与狭义的人工智能相比, 通用 人工 智能 通过 跨领域、跨学科、跨任务和跨模态的 大模型,能够满足更广泛的场景需求、实现更高程度的 逻辑理解能力 与 使用工具能力 。 2 023 年, 随着 LLM 大规模语言模型技术的不断突破, 大模型为探索更高阶的通用人工智能带来了新的曙光 。 通用人工智能进入了快速发展期,在中国,大模型已经呈现出百花齐放的态势,各种大模型层出不穷。
要想在 “百模争秀”的时代占得先机,A I 开发团队需要着力化解 算力、算法、数据 层面的巨大挑战 ,而开发效率和训练速度是保障大模型市场竞争力的核心关键因素,也是未来的核心发力点 。 近日, 浪潮信息人工智能与高性能应用软件部 AI 架构师Owen ZHU 参与首届由 CSDN、《新程序员》联合主办的NPCon大会,发表重要技术演讲, 分享面向新一轮 A IGC 产业革命, A I 大模型的算力系统解决之道,并强调算力、算法、数据和系统架构等多个方面的综合优化对大模型训练到了至关重要的作用。
以下为 Owen ZHU 在 NPCon大会的演讲实录整理:
l “百模争秀”时代的算力瓶颈
大模型研发的核心技术是由预训练与 Alignment 组成的,第一部分就是预训练,需要用大量的数据使模型收敛速度更快、性能更好。第二部分则是 Alignment , Alignment不完全等于强化学习 ,其通过 使用多种方式/策略优化模型输出,让AI在和人的交流反馈中学会如何沟通表达 ,这两部分是提升大模型质量的核心要素。
目前来看,模型基础能力 取决于数据、模型参数量和算力 。模型参数量越大、 投入的训练数据越大,模型 泛化 能力越强。 由于资源限制,在两者不可兼得的时候,应该如何进行取舍呢? O penAI 的研究 结论 认为,与增加 数据量相比,先增大模型参数量受益 则 会更 好,用一 千亿的模型训练两千亿的Token和两千亿模型训练一千亿的Token ,后者的模型性能会更高。
由此可见,参数量是衡量模型能力的一个重要指标, 当模型参数量增长超过一定阈值 时 ,模型能力表现出跃迁式的提升 ,表现出来 语言理解能力、生成能力、逻辑推理能力 等能力的显著提升,这也就是我们所说的模型的涌现能力。
模型 规模多大能产生涌现能力 呢?现在来看, 百亿参数是模型具备涌现能力的门槛 , 千亿参数的模型具备较好的涌现能力 。但这并不意味着模型规模就要上升到万亿规模级别的竞争,因为现有大模型并没有得到充分训练,如 G PT-3 的 每个参数基本上只训练了1 - 2个Token , DeepMind的研究表明, 如果把一个大模型训练充分,需要把每个参数量训练20个Token 。所以,当前的很多 千亿 规模的大 模型还需要 用 多10倍的数据 进行 训练,模型性能才能达到比较好的水平 。
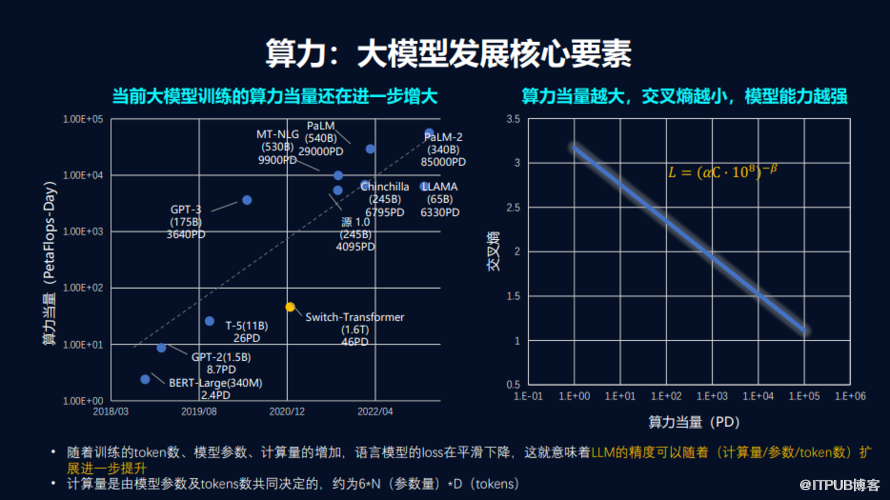
无论是提高模型参数量还是提升数据规模,算力依旧是大模型能力提升的核心驱动力:需要用 “足够大”的算力,去支撑起“足够精准”模型泛化能力。 当前大模型训练的算力当量还在进一步增大,从GPT-3到GPT-4算力当量增长了68倍 。 算力当量越大,交叉熵越小,模型能力越强。随着训练的token数、模型参数、计算量的增加,语言模型的loss在平滑下降,这就意味着 大语言模型 的精度可以随着计算量 、 参数 规模、 token数扩展进一步提升 。
l 欲炼大模型,先利其器
大模型能力来源于大量 工程实践经验, 预训练的工程挑战巨大 ,这表现在如下几个方面:首先, AI大模型的演化对于集群的并行运算效率、片上存储、带宽、低延时的访存等也都提出了较高的需求,万卡AI平台的规划建设、性能调优、算力调度 都是很难解决的难题;其次, 大规模训练普遍存在硬件故障、梯度爆炸等小规模训练不会遇到的问题 ;再次,工程实践方面的缺乏导致企业难以在模型质量上实现快速提升。
作为最早布局大模型的企业之一,浪潮信息在业界率先推出了中文 AI巨量模型“源1.0”,参数规模高达2457亿。 千亿参数规模的大模型创新实践,使得浪潮信息 在大模型领域积累了实战技术经验并拥有专业的研发团队, 为业界提供 A I 算力系统参考设计。 在算力效率层面,针对大模型训练中存在计算模式复杂,算力集群性能较低的情况,源 1.0在大规模分布式训练中采用了张量并行、流水线并行和数据并行的三维并行策略, 训练耗时约15天,共计训练了180 billion token ,并将 模型最后的loss 值 收敛 至 1.73, 显著低于 GPT-3等业界其他语言模型。 首-次提出面向效率和精度优化的大模型结构协同设计方法,围绕深度学习框架、训练集群 IO、通信开展了深入优化,在仅采用2x200G互联的情况下,源1.0的算力效率达到45%,算力效率世-界-领-先。 在集群高速互联层面,基于原生 RDMA实现整个集群的全线速组网,并对网络拓扑进行优化,可以有效消除混合计算的计算瓶颈,确保集群在大模型训练时始终处于最-佳状态。
l 为大模型良好生态发展寻找最优解
当前,中国和业界先进水平大模型的算力差距依 然较大, 从算力当量来看, G PT-4 的算力当量已经达到了 248,842PD ,而国内大多数主流的大模型算力大量仅为数千 P D ,差距高达近百倍。
同时, 中国和业界先进水平大模型 在算法、数据方面也存在巨大差距。在算法方面, 虽然开源为国内大模型发展带来了弯道超车的良机,但LLaMA 等 开源 大 模型 相比 G PT4 等 顶-级水平自研模型的性能,开源模型的能力 存在 “天花板” 。
在数据方面, 中文数据集和英文数据集相比较,在规模、质量上均存在显著差距 , 相较于动辄数千亿 单词 量级的英文数据,中文大模型的数据量级仅为百亿左右,而且开源程度较低 ,封闭程度较高。
开发大模型、发展通用人工智能是一项非常复杂的系统工程,我们 亟需 从系统层面为未来大模型的良好生态发展寻找最优解。 从实战中走来,通过构建高效稳定的智算系统,加速模型开发效率提升。
日前,浪潮信息大模型智算软件栈
OGAI(Open GenAI Infra)——“元脑生智“已正式发布。浪潮信息正通过“工具化、系统化、全链条”的全栈赋能能力,让炼大模型省时、省力,让大模型更快、更稳、更智能,助力百模真正实现“竞速A
IGC”
。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69946831/viewspace-2980159/ ,如需转载,请注明出处,否则将追究法律责任。

