跨模态行人重识别之“模态互转”
今天给大家分享两篇跨模态行人重识别的论文,它们分别是来自 ICCV 2019 的《 RGB-Infrared Cross-Modality Person Re-Identification via Joint Pixel and Feature Alignment》和 CVPR 2019 的《 Learning to Reduce Dual-level Discrepancy for Infrared-Visible Person Re-identification》。为什么要一起分享这两篇论文?因为两篇论文的思路大致相当,个人将其称之为“模态互转”,顾名思义,就是让不同模态的数据之间相互转换以此来解决跨模态行人重识别问题。
注:如果大家对跨模态行人重识别不了解的话,可以参考我之前写的一篇文章: 《行人跨模态重识别 | 双向限制的排序损失》 ,相对于今天要分享的文章,这篇文章更适合入门,同时里面也提供了代码,大家有问题的话也欢迎私信或者留言讨论。
行人重识别本身可以认为是一个图像检索问题,通常的行人重识别任务都是用行人的 RGB 图像搜索该行人其他镜头下的 RGB 图像。本文所描述的跨模态行人重识别则是用行人的 RGB(红外)图像搜索该行人的红外(RGB)图像,通常使用的方法框架如下图所示。
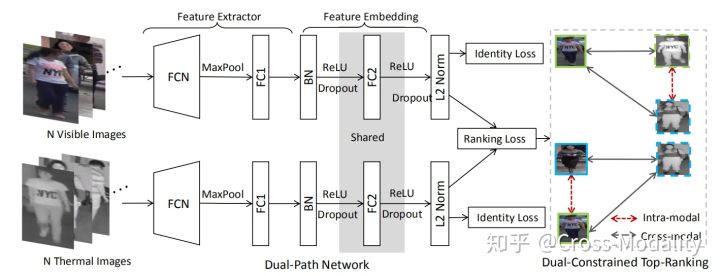 目前解决跨模态行人重识别任务的通用框架
注:插图来源于论文《 Visible Thermal Person Re-Identification via Dual-Constrained Top-Ranking 》
图中整体框架的训练过程可以用以下三个过程概括:(1)先用双路的卷积网络分别提取 RGB 图像和红外图像的特征;(2)随后将两个模态的特征输入共享参数的网络;(3)最后通过交叉熵损失和三元组损失引导训练。以上三个过程,都有一个共同的目的:让同一行人不同模态下的特征变得更为相似。其中的每一个过程都为了这个目的各自发挥着不一样的作用。
既然是为了提高相似性,有一个非常简单明了的想法:用 RGB 图像生成对应的红外图像,同时红外图像也生成对应的 RGB 图像。这样我们提取 RGB(红外)图像特征的时候,可以直接将其转换成红外(RGB)图像,随后整体的框架就变成单模态下红外(RGB)的行人重识别。两个模态的数据统一成了一个模态下的数据,给人的感觉就已经很相似了。今天要分享的两篇论文,整体思路就是如此。
Paper 1:RGB-Infrared Cross-Modality Person Re-Identification via Joint Pixel and Feature Alignment(ICCV 2019)
代码地址: https://github.com/wangguanan/A lignGAN
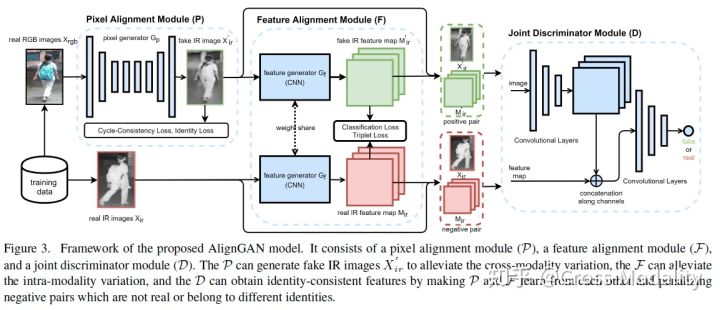 AlignGAN
【【 方法:三个模块 】】
像素对齐模块(Pixel Alignment Module):该模块将行人的 RGB 图像通过 CycleGAN 生成对应的红外图像。因为 CycleGAN 在图像风格迁移任务中表现不俗,同时这里的任务仅仅希望是将图像的 RGB 风格转换成红外的风格,因此采用 CycleGAN 是一个较好的选择。与此同时,为了让生成的 fake 红外图像和 real 红外图像保持相同的身份信息,这里也加入了身份损失和三元组损失对 fake 红外图像进行约束。
特征对齐模块(Feature Alignment Module):该模块可以认为是论文 《 Visible Thermal Person Re-Identification via Dual-Constrained Top-Ranking 》的网络框架,将 fake 红外图像和 real 红外图像输入至一个共享参数的 CNN 网络中得到各自的 feature map,获得的 feature map 也是最终要使用的 feature map,因此少不了交叉熵损失和三元组损失的加持。
联合判别模块(Joint Discriminator Module):该模块有分别与前面两个对齐模块展开对抗。针对像素对齐模块,它负责判别真假红外图像;针对特征对齐模块,它又可以当做是一个模态判别器。至于这里为什么只用一个判别器,我个人猜测是作者在做实验的过程中发现只用一个判别器效果更好,同时只有一个判别器也使得整体的网络框架精简了许多。
【【 实验结果】】
该方法在 SYSU-MM01 数据集以及 RegDB 数据集上的效果是目前 CV 顶会中最好的,实验结果如下图所示:
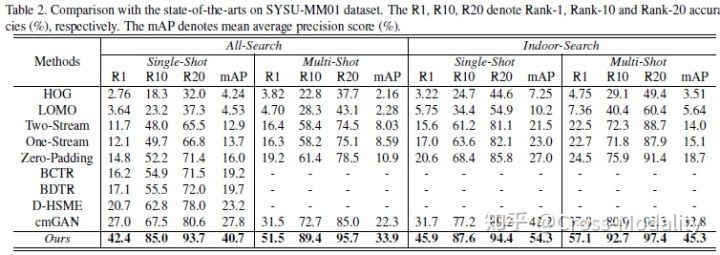 SYSU-MM01 数据集上的实验结果
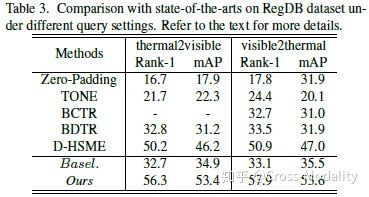 RegDB 数据集上的实验结果
【【 总结】】
这篇论文的思路简单,但因为涉及到 GAN,训练复杂了许多,能做出来很难得,这里咱们得为作者及其团队点赞。但这篇文章 仅从想法上来看有一个不那么美的点:它仅仅使用 RGB 图像生成对应的红外图像,红外图像为什么不转换成对应 RGB 图像呢?如果两者相互转换,是不是会给人感觉以一种对称美?而接下来介绍的这篇论文,它就完成了这一壮举。
Paper 2:Learning to Reduce Dual-level Discrepancy for Infrared-Visible Person
Re-identification(CVPR 2019)
 D2RL
【【 方法:两个过程】】
该文章解决跨模态重识别问题分成两个步骤:(1)先消除模态之间的差异;(2)再消除图像内容之间的差异。下面分别对这两个过程进行简单介绍。
(1)消除模态差异的过程
如何才能消除模态之间的差异?论文中用了一个很好的工具,VAE,即变分自编码器。怎么用这个工具呢?首先,将行人的 RGB 图像和红外图形通过 VAE 生成中间的隐向量。注意,这一步是消除模态差异的关键,因为 VAE 的隐向量满足标准正态分布,而这一步已经将不同模态(也满足不同分布)的行人图像映射至同一标准正态分布空间中。然后,将 RGB (红外)图像的隐向量通过解码器生成对应的红外(RGB)图像。在这里,解码器也是生成器,同时后面为其配备了相应的判别器,具体可以参见上图。
(2)消除图像内容差异的过程
这一过程可以看做是单模态下行人重识别的过程,只是在有些细节上会有不同,不同之处主要在于输入的形式发生了变化:在(1)之后,文中的做法是将 RGB(红外)图像和生成的红外(RGB)图像在通道上合并成一张图像,这样一张图像变成了 4 个通道。因此,需要将通常所用的网络结构(如:Resnet50)第一层卷积的输入通道数改为 4,同时文中用 market1501 数据集对该网络进行了预训练,这样做估计是因为改完以后效果不行,所以作者对网络进行了预训练。接下来就是用交叉熵损失和三元组损失提取特征的过程,这里就不进行过多的描述。
【【 实验结果】】
该方法在效果上与上一篇有一定的差距,精度虽低(RGB 图像生成红外可会容易些,而红外图像生成 RGB 图像很可能带来的是噪声),个人觉得这篇论文的方法更优美。
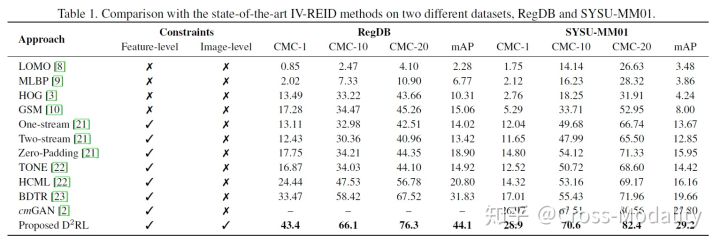 在 SYSU-MM01 数据集和 RegDB 数据集上的实验结果
【【 总结】】
尽管投身于跨模态行人重识别的研究越来越多(2017 年 SYSU-MM01 数据集的公布打开了跨模态行人重识别的大门),但从近两年 CV 顶会的发表情况来看,跨模态行人重识别占据的数量很少(2018 年:0 篇;CVPR 2019: 1 篇;ICCV 2019: 1 篇),由此可见在跨模态行人重识别领域还有很大的一块肉等着大家,希望对此有兴趣的同胞们私底下好好磨牙。
https://zhuanlan.zhihu.com/p/91655667
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69946223/viewspace-2674250/ ,如需转载,请注明出处,否则将追究法律责任。

