10月17日,DeepSeek宣布DeepSeek V4.1 Flash更新至V4.1-Flash-1017版本,官方网页端、APP与API模型同步变更为新模型,随着新版本的发布,DeepSeek API还新增了对Search与Fetch接口(网页搜索与抓取接口)的支持。
DeepSeek V4.1-Flash-1017版本与上一版本相比是一次小幅更新,而且基础模型的调用方式和定价结构保持不变,大家用起来也比较方便。
目前该模型已同步开源,DeepSeek-V4.1-Flash-1017 模型权重下载地址如下:
-
HuggingFace: https://huggingface.co/deepseek-ai/DeepSeek-V4.1-Flash-
-
1017ModelScope: https://modelscope.cn/models/deepseek-ai/DeepSeek-V4.1-Flash-1017
性能与成本的帕累托前沿
虽然是小更新,但是效果备受瞩目。官方指出,新模型在推理、编程、智能体任务及视觉基准测试方面均实现了显著提升。与此同时,该模型缩短了任务执行时间和输出长度,使用户能够以更低的成本更快地完成任务,并在多个智能体评测框架中推进了性能与成本的帕累托前沿(兼顾性能与成本,在某一维度上取得提升的同时,另一维度并未有所牺牲。)
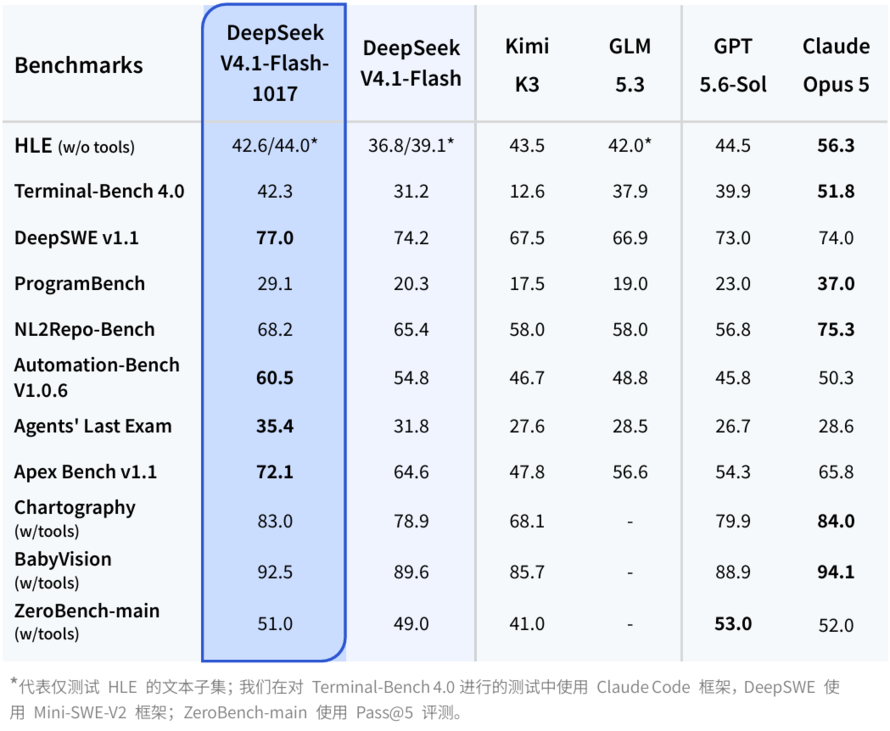
根据DeepSeek官方披露的基准测试数据,新版本模型在DeepSWE v1.1、Automation-Bench v1.0.6、Agents’ Last Exam、Apex Bench v1.1等编程与智能任务基准测试中,表现优异,均超过了Claude Opus 5及其他图表所列模型。在图表理解评测基准测试Chartography(含工具)中得分接近Claude Opus 5,超过其他图表所列模型。
本次发布中最引人注目的数据是DeepSWE v1.1基准测试得分,DeepSWE v1.1是一项旨在测试模型执行实际软件工程工作能力的基准测试,通常会向模型提供一个真实的代码仓库、问题或功能请求,并衡量模型生成的补丁能否端到端地解决问题,这比单功能代码补全的门槛要高得多,更贴近生产环境。
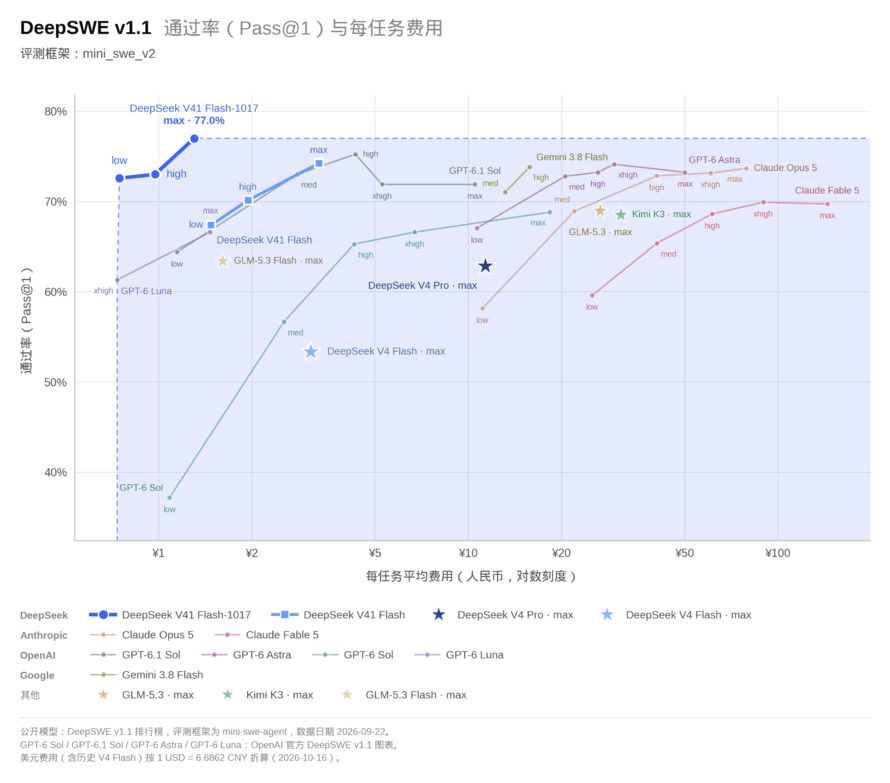
DeepSeek V4.1 Flash 1017使用mini-swe-v2框架测试DeepSWE的性能/成本图
上图DeepSWE v1.1基准测试的横坐标为每任务平均费用,纵坐标为通过率,可以看到,DeepSeek V4.1-Flash-1017在max档实现了77%的通过率,超过GPT-6.1 Sol、GPT-6 Astra、Claud Fable 5等一众体量更大的旗舰模型,让用户能够以更低成本、更快速度完成任务,在多个Harness评测环境下达到了新的性能-费用帕累托最优。
需要说明的是,大模型基准测评结果高度依赖模型版本、提示词策略、Harness评测框架、任务数据集与评分规则,上述数据为DeepSeek的独立测评结果,不同的Harness评测框架会影响测评结果,真实的表现仍有待独立第三方机构在相同评测条件下复现验证,不宜直接等同于全部真实业务场景下的表现。但是亮眼的表现仍然体现出DeepSeek V4.1-Flash-1017以更低成本、更好地完成任务的潜力。
与其他模型厂商不同,DeepSeek新版本的模型更新并不追求参数的峰值和更极致的模型能力,而是在性能、速度、成本中寻求更优解,力求在每项任务成本上胜出,并为开发者提供可构建的基础设施,让一个已广泛投入生产使用的模型拥有更高的效率。
DeepSeek指出,DeepSeek V4.1-Flash-1017还着重针对DeepSeek Harness、腾讯 CodeBuddy、WorkBuddy等大家常用的平台框架进行了优化。官方建议请升级到DeepSeek Harness 0.2.1-rc.1及以上版本,以获得适配新版模型的最优体验。
让“许愿式”编程成为可能
DeepSeek指出,新版本通过基于自反馈的强化学习(RL)训练技术,提升了在游戏开发、3D建模等方面从零开始构建完整项目的能力,能够支持实现更多“许愿式”编程任务及项目开发请求。
所谓“许愿式”编程,即用户只用自然语言描述最终想要的结果,AI智能体自主完成需求拆解、架构设计、编码、调试、运行验证,直接交付完整可运行项目,中间过程尽量减少人工介入,一句话“许愿”,AI交付完整项目正成为现实,这极大降低了编程开发的门槛。
DeepSeek官方提供的故宫3D建模、网页版赛车游戏开发、以3D场景动态展现从史前时代到现代的发展历程等示例中,DeepSeek V4.1-Flash-1017模型在较少的提示词与素材参考条件下,在DeepSeek Harness框架环境内通过极短的交互轮次,实现了较好的3D建模与游戏开发效果。
需要注意,该能力表现是在官方Harness环境下得到的演示效果,项目最终交付质量会受需求描述清晰度、任务复杂度、场景边界条件影响,复杂工程场景下的稳定性、安全性仍有待验证,相关效果也需要第三方在对齐环境下复现评估。
有不少AI社区的开发者们测试了相关能力,表现不错,大家可以尝试一下。
新开放的自研搜索API
另一个值得关注的是DeepSeek对外开放了自研搜索API,新增了对Search与Fetch接口的支持,有海外分析师指出,从DeepSeek的业务发展轨迹来看,搜索API的开放或许比基准测试分数更为重要。Search与Fetch属于服务端工具接口,可让模型在执行任务时从网络上检索实时信息并提取特定页面的内容,正是这种能力,将静态大模型升级为具备自主检索能力的研究与编码智能体。
在此版本发布之前,该功能主要内置于特定的集成方案中。DeepSeek指出,其自研的通用搜索引擎,索引了全球千亿级网页,支持多语言搜索,实时返回高相关、高权威、高时效的优质结果。而且针对现在常见的SEO作弊、GEO操纵和低质AIGC等问题,DeepSeek通过严格的识别机制对其进行过滤,确保向用户与LLM呈现权威可信的信息。
在定价方面,DeepSeek表示,Search/Fetch接口价格均为5元/千次,当前用户在DeepSeek Harness / Claude Code / Codex中使用DeepSeek API时,Search/Fetch接口调用暂未计费,设置了两周的免费试用期,将于北京时间2026年11月1日00:00开始按次收取调用费用。有分析指出,与从第一天就开始收费相比,这种入门曲线要平缓得多,DeepSeek为开发者留出了时间,使其能在计费开始前将端点集成到现有的代理管道中。
小结
总体来看,DeepSeek V4.1-Flash-1017虽然被定位为一次“小幅更新”,但其释放的信号并不小:在基础模型调用方式与定价结构保持不变的前提下,新版本在推理、编程、智能体任务和视觉基准测试中实现了同步提升,同时缩短任务执行时间与输出长度,进一步推进了性能与成本的帕累托前沿。对于已经将DeepSeek模型投入生产环境的开发者而言,这种“不加价、少改动、提效率”的更新,往往比参数规模上的跃升更具实际意义。对于追求单位任务成本效益的开发者来说,新版本提供了一个值得尽快升级和实测的新选项。
更值得关注的是能力边界与基础设施的同步扩展。一方面,“许愿式”编程展示了模型从自然语言需求到完整可运行项目的端到端交付潜力;另一方面,同步开放搜索API等基础设施,也能吸引第三方代理框架基于DeepSeek的基础设施进行开发。
大模型之战的重心已然转移。海内外厂商正持续强化编程与智能代理能力,竞争的关键不再是单一指标的极限突破,而是在真实任务场景下,以更优的性价比交付可用价值,这也是Agentic AI时代模型与配套基础设施共同面对的长期考题。未来,谁能在真实业务中持续平衡性能、成本与可靠性,谁就能在这场竞争中占据优势。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69925873/viewspace-3186049/ ,如需转载,请注明出处,否则将追究法律责任。

