随着分布式数据库日渐成熟,在推广使用上开始步入深水区。在这一过程中,对企业的架构、运维、开发都带来不小的冲击,如何快速掌握这一新技术,尽快落地成为大家关注的焦点。本文从开发者的视角出发,讨论使用分布式数据库所面临的难点之一:数据分片策略,这也是阻碍很多企业上到分布式数据库的核心问题。
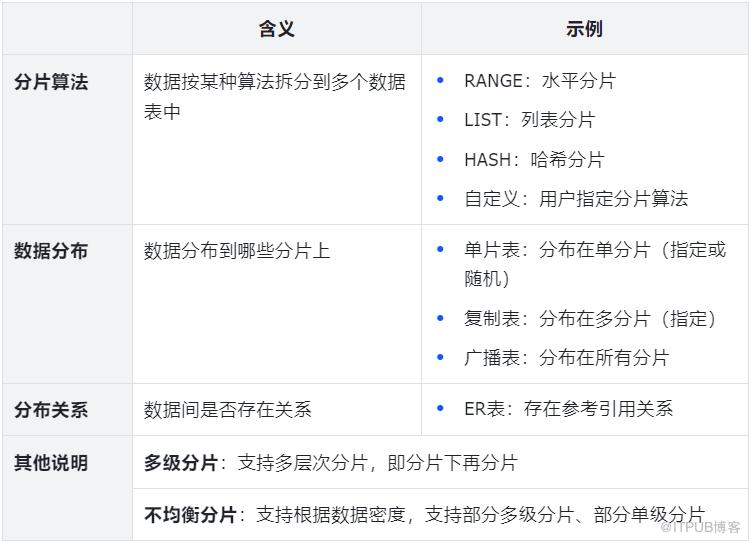
分布式数据库的核心能力之一,就是通过数据分片存储,来承载更大的数据规模和计算负载。数据分片,是把数据库横向扩展到多个物理节点上的一种分布式技术。可以理解为将表数据按照特定的分片规则水平切分成若干片段(shard),使这些数据片段分布在不同物理节点上。数据分片从大类可分为垂直分片和水平分片,前者是按业务类别进行拆分,常见为业务拆库;后者则是以字段为依据,按照一定策略拆分到若干表中。本文后面所谈的数据分片,是针对后者。那么如何将数据从单体更换为分布式,这就需要考虑数据分片策略。数据分片策略包括分片算法、数据分布、分布关系等,简单描述参见下表。
业内分布式数据库产品,针对数据分片策略通常有三种做法。一种是基于主键/唯一索引/隐含主键等做统一数据分片,即用户无需人为设置分片策略;一种是开放若干数据分片算法,用户可自行创建数据对象时人为指定;还有一些数据库中间件产品,支持更为灵活的分片方式,可以让用户自行扩展。上面三种,我们可命名为内置、开放、自定义。下面从开发者角度,简单对比下这几种方式。
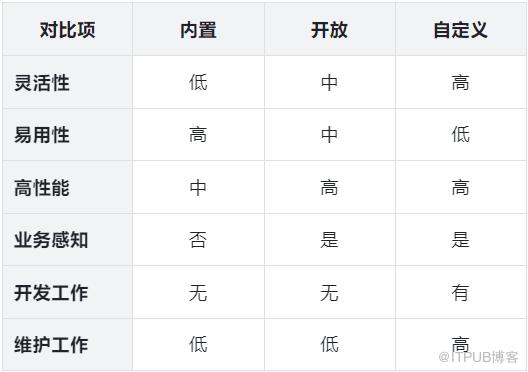
内置方式产品,通常对开发者来说更容易上手,使用体验与单机数据库基本一致。但由于无法干预分片策略,其灵活性较差且与业务无关。在大部分业务场景下,是需要牺牲性能体验、消耗更多硬件资源来弥补上述不足。
开放方式产品,需要开发者从内置策略中选择一种相对最优解,其具备一定灵活性也兼具了性能表现,可满足绝大多数场景的需要,只有个别业务因其特殊性很难找到合适分片策略,需要业务定制改造。
自定义方式产品,为开发者提供最大的灵活自由度,但也意味着易用性较差及需要开发运维方面做更多工作,很难做到标准产品化。
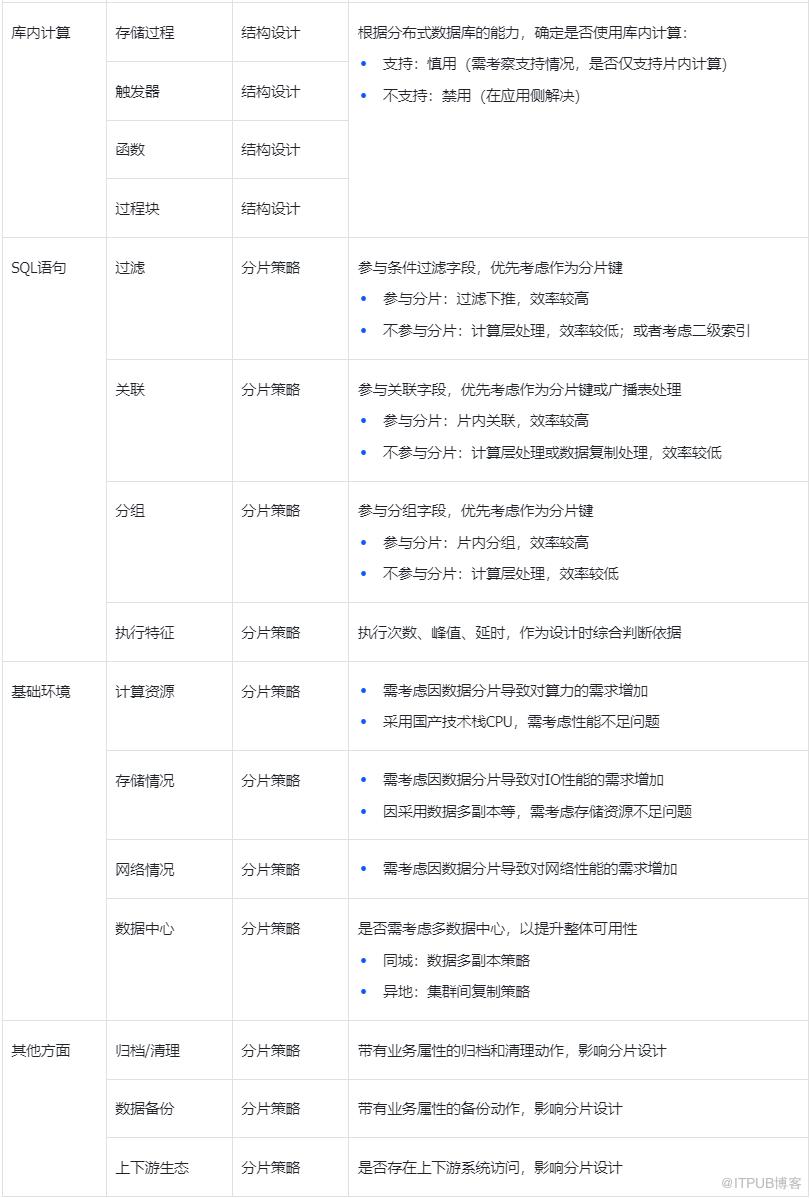
除了第一种方式外,其余两种都涉及一个问题就是现有数据对象如何拆分?好的拆分策略,一定是兼顾业务模型、性能最佳、稳定可靠、研发改造、运维难点等多种因素下,结合分布式数据库的特点而做的最优解,这是在多种因素下平衡的结果。在具体实施上,需要收集大量信息后才能做出决定,下面将主要部分整理为一个表格。

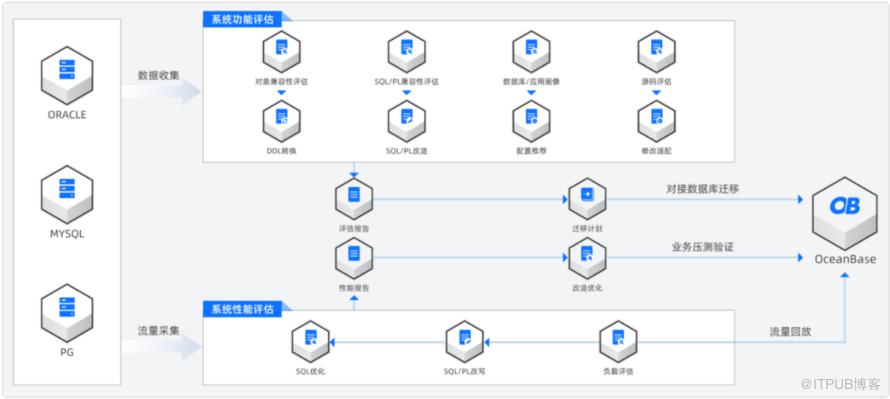
目前国内很多分布式数据库厂商都加强了迁移能力的支持,一般是通过外置工具的方式提供收集、评估、辅助迁移、验证等一系列流程的支持。下图是以OceanBase的OMA工具举例,说明其提供的支持能力。

韩锋频道:
关注技术、管理、随想。
长按扫码可关注
原文作者:韩锋频道;如有侵权,请联系管理员删除。

