Redis,看这篇博客,吊打所有面试官
Redis是基于内存,采用单线程的键值对数据库,并使用多路IO复用策略,处理连接请求。
Redis支持丰富的数据类型
Redis的key只支持String类型,value支持String、List、Set、Zset、Hash
- String
String数据类似是二进制安全的,可以把图片、视频等文件保存在String中。
String类型支持增量操作(String转Integer,自加,再转回String),可用于统计网站访问次数
- List
redis的List数据类型,底层是双向链表结构,List提供链表支持的所有操作

可以用于存放微博中的关注列表,或论坛中所有回帖ID
- Set(类似Java中的HashSet)
Set类型是一种无序集合,可以快速查找元素是否存在,用于记录一些不能重复的数据。
网站中注册的用户名,如果要注册的用户名已经存在于集合中,就拒绝此用户注册
- Zset类型(类似于Java中的SortedSet)
Zset属于有序集合,通过一个double类型数值score对集合中的元素进行排序。Zset通过
SkipList(跳跃表)和HashTable组合完成。SkipList负责排序,而HashTable负责保存数据
排行榜应用中按顶贴次数进行排序,将顶贴次数设置成排序依据的score,用户每次顶贴,
只需执行Zadd命令修改score值
- Hash类型(类似于Java中的HashMap)
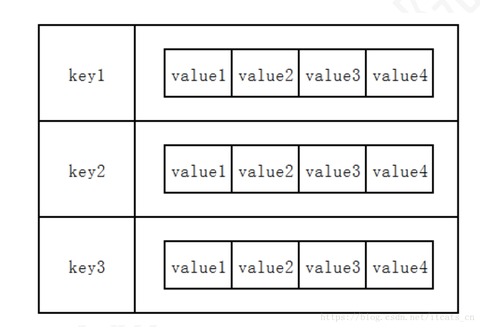
Hahs类型是每个Key对应一个HashTable,Hash类型适合存储对象,也就是HashTable存储对象的<属性,属性值>键值对。
用户信息对象,把用户ID作为key,可以把用户信息保存到Hash类型中

持久化
Redis数据库是完全基于内存的,内存数据库有一个严重的弊端,突然宕机或者断电,内存的数据就会丢失,为了解决这个问题,Redis提供了两种持久化方式,RDB、Append Only File(AOF)
- RDB
RDB是默认的持久化方式,主要的过程是将Redis保存在内存中的数据以快照的方式写入二进制文件,默认的文件名为dump.rdb
可以通过修改配置文件,来设置快照策略
vim /usr/local/Redis/etc/Redis.conf
save 900 1             # 每900秒,数据更改1次,就发起快照保存
save 300 10            # 每300秒,数据更改10次,则发起快照保存
save 60  10000        # 每60秒,数据更改10000,则发起快照保存
#只有其中一个条件成立,Redis就会进行一次内存快照操作 Redis每隔一段时间进行一次内存快照操作,客户端也可以使用save或者bgsave命令,告诉Redis需要进行一次内存快照操作,save命令在主线程中保存快照,上文提到了Redis通过单线程处理所有连接请求,执行save命令,有可能阻塞其他客户端请求,所有建议使用bgsave,redis fork出一个新子进程,处理内存快照请求,父进程继续处客户端连接请求。
特别要注意的是,内存快照每次都要把内存数据完整写入硬盘,而不是写入增量数据,所以如果数据量很大,写入操作比较频繁,就会严重影响性能。
快照方式是每隔一段时间,执行一次快照操作,一但Redis宕机,就会丢失最后一次快照后的所有修改
- AOF(Append of File)
AOF,也称为日志追加,启用AOF方式后,Redis会将收到的每一个写命令通过write函数追加到文件appendonly.aof中,当Redis重启后,会执行文件中的所有命令,这样就可以在内存中重建整个Redis数据库。
操作系统内核的I/O接口存在缓存,所以AOF方式不可能立即写入文件,存在丢失部分数据的风险。可以通过修改配置文件,指定写入策略
#启用aof持久化方式   appendonly yes

#每次收到写命令就立即写入磁盘,性能最差,持久化最好(同步双写)   appendfsync always

#每秒钟写入磁盘一次,在性能和持久化方面做了很好的折中(定时异步双写)   appendfsync everysec

#是否写入磁盘完全依赖操作系统,性能最好,持久化没保证    Append sync no
AOF方式有效降低了数据丢失的风险,但是带来了一个新问题,持久化文件会不断膨胀
例如调用 incr nums 命令100次,文件就会保存100条该命令,其实99条都是多余的,因为要恢复数据只需要set nums 100。
AOF重写,为了压缩日志文件,Redis提供bgrewriteaof命令,命令主要的功能是,使用类似内存快照的方式将内存中的数据逆化成命令,保存到临时文件中,最后替换原来的日志文件。
如下图所示,状态n的快照逆化成命令,可以替代阴影部分包括的增量日志

内存淘汰策略
机器的内存肯定是有限制的,一旦内存使用到了阈值,就必须使用内存淘汰策略淘汰内存
Redis总共支持六种淘汰策略
-
noeviction(默认): 当内存使用达到阈值时,所有申请内存的命令都会报错
-
allKeys-lru: 在主键空间,优先一处最近最少使用的Key
-
volatile-lru: 在设置了过期时间的键空间中,优先移除最近最少使用的Key
-
allKeys-random: 在主键空间中,随机删除key
- volatile-random: 在设置了过期时间的键空间中,随机删除Key
- volatile-ttl: 在设置了过期时间的键空间中,优先删除具有更早过期时间的key
选择淘汰策略
allKeys-lru: 推荐使用,有相对热点数据时,推荐使用
allKeys-random: 访问key概率相等,推荐使用
volatile-ttl: 可以提示Redis去删除指定的Key
非精准的LRU
LRU算法,需要扫描所有key,扫描所有key,需要耗费很高的成本。为了在一定成本内实现相对的LRU,早期的Redis版本是基于采样的LRU,也就是放弃全部键空间内搜索解改为采样空间搜索最优解。自从Redis3.0版本之后,Redis作者对于基于采样的LRU进行了一些优化,目的是在一定的成本内让结果更靠近真实的LRU。
主从复制
主从复制可以防止主节点宕机,导致应用崩溃,并且可以用于读写分离,即读操作访问从服务器,写操作访问主服务器
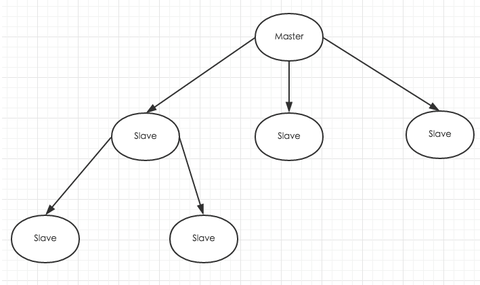
Redis主从结构
- 一个master可以拥有多个slave
- 多个slave除了可以连接同一个master外,还可以连接其他slave

主从复制原理
主从复制流程主要可以分为以下几个步骤
- slave发送SYNC命令
- master启动一个后台进程,将内存数据以快照方式写入文件中,即执行
bgsave命令
同时使用缓冲区记录此后执行的所有写命令
- master后台进程完成内存快照操作后,将rdb数据文件发送给slave
- slave清空数据库数据,把rdb文件数据导入数据库中
- master把缓存的命令发给slave,后续master接受到的命令也发送给slave.
同时slave执行来自master的写命令。

Redis分区
单机Redis的网络、I/O能力、存储容量、和计算资源是有限的,所以出现分区策略,即将数据分布到不同的Redis实例,相应得请求也将分散到多台机器,提升Redis得总体服务能力。
分区主要有三种分区策略
范围分区
将一个范围得Key都映射到同一个Redis实例中
例如将用户ID从0-10000的用户数据映射到R0实例,ID从10001到20000映射到R1实例,依次类推。范围分区是一个简单有效的方式,但是存在一个明显缺点,如果key不是简单的整数,无法进行范围分区,比如Key是一组uuid
哈希分区
哈希分区和范围分区相比一个明显的优点是哈希分区适合任何形式的Key.
#key所属实例id计算方式
id = hash(key) % N
分区实现方式
- 客户端实现:即Key在Redis客户端就决定了要被存储在那台Redis实例中

-
代理实现
客户端将请求发往代理服务器,代理服务器实现了Redis协议,因此代理服务其可以代理客户端和Redis服务器通信。代理服务器通过配置分区Schema来将客户端的请求转发到正确的Redis实例中,同时将反馈消息返回给客户端。

-
查询路由
客户端可以将查询请求随机发送到任意一个Redis实例,该Redis实例负责将请求转发至正确的Redis实例中。

分区缺点
- 多键操作不支持,由于分区,导致批量操作的键被映射到不同的Redis实例中
- 分区最小粒度是键,超级键值对(数据规模很大的键值对)无法映射到不同实例中
- 持久化操作,需要将分布在不同实例的文件聚集到一起进行备份。
- 添加、删除节点很复杂,Redis集群支持几乎运行时透明的因为增加或减少机器而需要做的
rebalancing,然而客户端和代理分区不支持这种功能。Pre-Sharding可以有效解决此问题。
预分片
我们可以开启多个Redis实例,尽管是一台物理机器,我们在刚开始的时候也可以开启多个实例。我们可以从中选择一些实例,比如32或64个实例来作为我们的工作集群。当一台物理机器存储不够的时候,我们可以将一半的实例移动到我们的第二台物理机上,依次类对,我们可以保证集群中Redis的实例数不变,又可以达到扩充机器的目的。
缓存穿透
缓存穿透是指查询一个一定不存在的数据(缓存和数据库中均不存在),由于缓存是不命中时被动写的,并且出于容错考虑,如果从存储层查不到数据则不写入缓存,这将导致这个不存在的数据每次请求都要到存储层去查询,失去了缓存的意义。在流量大时,可能DB就挂掉了,要是有人利用不存在的key频繁攻击我们的应用,这就是漏洞
解决方法
- 利用互斥锁,缓存失效的时候,先去获得锁,得到锁了,再去请求数据库。没得到锁,则休眠一段时间重试
- 提供一个能迅速判断请求是否有效的拦截机制,比如,利用布隆过滤器,内部维护一系列合法有效的key。迅速判断出,请求所携带的Key是否合法有效。如果不合法,则直接返回。
缓存雪崩
缓存雪崩是指在我们设置缓存时采用了相同的过期时间,导致缓存在某一时刻同时失效,请求全部转发到DB,DB瞬时压力过重雪崩。
解决方法
- 给缓存的失效时间,加上一个随机值,避免集体失效。
- 使用互斥锁,但是该方案吞吐量明显下降了。
- 双缓存。我们有两个缓存,缓存A和缓存B。缓存A的失效时间为20分钟,缓存B不设失效时间。自己做缓存预热操作。然后细分以下几个小点
- 从缓存A读数据库,有则直接返回
- A没有数据,直接从B读数据,直接返回,并且异步启动一个更新线程。
- 更新线程同时更新缓存A和缓存B。
缓存击穿
短时间内,并发用户集中访问缓存过期数据(缓存没有,数据库中有),由于缓存中没有读取到数据,会直接去数据库读取数据,并回设回缓存,导致数据库压力瞬间增大。
解决方法
- 设置热点数据永远不过期
- 加互斥锁
参考文献
【面试】redis缓存穿透、缓存击穿、缓存雪崩区别和解决方案_fcvtb的博客-CSDN博客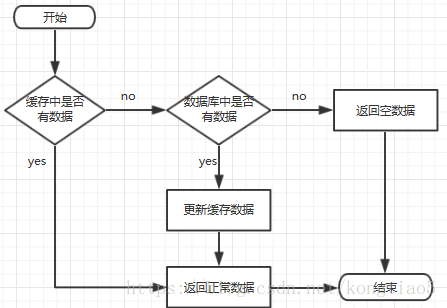 redis全面解析_数据库_itcats_cn的博客-CSDN博客
 Redis主从复制原理总结 - 老虎死了还有狼 - 博客园
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69918097/viewspace-3139739/ ,如需转载,请注明出处,否则将追究法律责任。

