Linux
系统编程之多任务实现(一)
在系统编程中实现多任务一般使用fork函数,其需要的头文件:
#include <sys/types.h>
#include <unistd.h>
Fork 函数原型如下:
pid_t fork(void);
功能:
用于从一个已存在的进程中创建一个新进程,新进程称为子进程,原进程称为父进程。
参数:无
返回值:
成功:子进程中返回 0,父进程中返回子进程 ID。pid_t,为无符号整型。
失败:返回 -1。
失败的两个主要原因是:
1 )当前的进程数已经达到了系统规定的上限,这时 errno 的值被设置为 EAGAIN。
2 )系统内存不足,这时 errno 的值被设置为 ENOMEM。
测试示例如下:
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
int main(int argc, char *argv[])
{
fork();
printf("id ==== %d\n", getpid()); // 获取进程号
return 0;
}
运行结果:
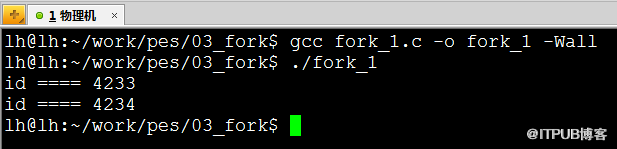
从运行结果,我们可以看出,fork() 之后的打印函数打印了两次,而且打印了两个进程号,这说明,fork() 之后确实创建了一个新的进程,新进程为子进程,原来的进程为父进程。
那子进程长什么样的呢?
使用 fork() 函数得到的子进程是父进程的一个复制品,它从父进程处继承了整个进程的地址空间:包括进程上下文(进程执行活动全过程的静态描述)、进程堆栈、打开的文件描述符、信号控制设定、进程优先级、进程组号等。子进程所独有的只有它的进程号,计时器等(只有小量信息)。因此,使用 fork() 函数的代价是很大的。
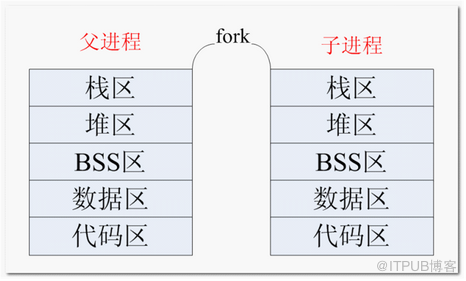
简单来说, 一个进程调用 fork() 函数后,系统先给新的进程分配资源,例如存储数据和代码的空间。然后把原来的进程的所有值都复制到新的新进程中,只有少数值与原来的进程的值不同。相当于克隆了一个自己。
实际上,更准确来说,Linux 的 fork() 使用是通过写时拷贝 (Copy- On-Write,COW技术) 实现。写时拷贝是一种可以推迟甚至避免拷贝数据的技术。内核此时并不复制整个进程的地址空间,而是让父子进程共享同一个地址空间。只用在需要写入的时候才会复制地址空间,从而使各个进行拥有各自的地址空间。也就是说,资源的复制是在需要写入的时候才会进行,在此之前,只有以只读方式共享。
子进程是父进程的一个复制品,可以简单认为父子进程的代码一样的。那大家想过没有,这样的话,父进程做了什么事情,子进程也做什么事情(如上面的例子),是不是不能实现满足我们实现多任务的要求呀,那我们是不是要想个办法区别父子进程呀,这就通过 fork() 的返回值。
fork() 函数被调用一次,但返回两次。两次返回的区别是:子进程的返回值是 0,而父进程的返回值则是新子进程的进程 ID。
测试代码:
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
int main(int argc, char *argv[])
{
pid_t pid;
pid = fork();
if( pid < 0 ){ // 没有创建成功
perror("fork");
}
if(0 == pid){ // 子进程
while(1){
printf("I am son\n");
sleep(1);
}
}else if(pid > 0){ // 父进程
while(1){
printf("I am father\n");
sleep(1);
}
}
return 0;
}
运行结果:
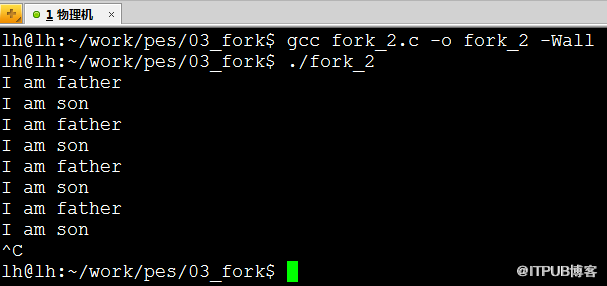
通过运行结果,可以看到,父子进程各做一件事(各自打印一句话)。这里,我们只是看到只有一份代码,实际上,fork() 以后,有两个地址空间在独立运行着,有点类似于有两个独立的程序(父子进程)在运行着。需要注意的是,在子进程的地址空间里,子进程是从 fork() 这个函数后才开始执行代码。
一般来说,在 fork() 之后是父进程先执行还是子进程先执行是不确定的。这取决于内核所使用的调度算法
下面的例子,为验证父子进程各自的地址空间是独立的
#include <stdio.h>
#include <unistd.h>
#include <sys/types.h>
int a = 10; // 全局变量
int main(int argc, char *argv[])
{
int b = 20; //局部变量
pid_t pid;
pid = fork();
if( pid < 0 ){ // 没有创建成功
perror("fork");
}
if(0 == pid){ // 子进程
a = 111;
b = 222; // 子进程修改其值
printf("son: a = %d, b = %d\n", a, b);
}else if(pid > 0){ // 父进程
sleep(1); // 保证子进程先运行,但不保证1秒足够
printf("father: a = %d, b = %d\n", a, b);
}
return 0;
}
运行结果:
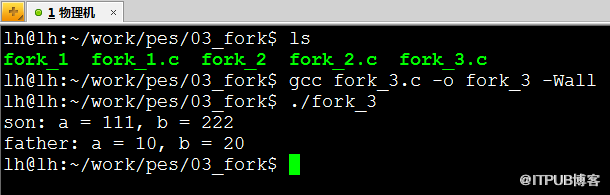
通过得知,在子进程修改变量 a,b 的值,并不影响到父进程 a,b 的值。
在以后的编程中,fork() 之后最好是加上判断,区别哪个是子进程的空间,哪个为父进程的空间,否则,fork() 以后的代码为父子进程各有一份,对于用户而言,没有太大意义,如例子1。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69914734/viewspace-2654123/ ,如需转载,请注明出处,否则将追究法律责任。

