OceanBase seekdb 1.4 正式发布:更小、更轻、更强
2026 年 8 月 27 日,OceanBase seekdb 正式发布 1.4 版本。这是一次以轻量化为主线的版本更新:携带 seekdb 核心的
pylibseekdb包从 160 MiB 缩减至 50 MiB, 二进制体积缩小近 2/3,空载内存和 CPU 开销下降超过 70%。与此同时,seekdb 进一步完善嵌入式多应用同时访问、macOS 稳定性与开发者工具链,并第一次引入 Rust 技术栈和 Bazel 构建支持(Preview)。
这篇文章不只是罗列更新项,我们还非常想和大家一起聊聊,一个已经具备完整数据库能力的产品,为什么还要主动做减法,以及这次减法为 AI 应用开发者带来了什么?

欢迎大家关注 OceanBase 社区公众号 “老纪的技术唠嗑局”。在这里,我们会持续为大家更新与 和 #Data 相关的技术内容~
数据库版本发布通常都在做加法,seekdb 1.4 则选择重新审视产品边界,围绕本地与端侧 AI 应用做一次有选择的减法。
我们把
pylibseekdb 从 160 MiB 缩减至 50 MiB,同时保留 SQL、事务、混合检索和数据版本管理等 AI 应用需要的核心能力。这里的“完整”,不是覆盖所有数据库负载的功能全集,而是结构化数据管理、向量/全文/标量混合检索、事务持久化和 Fork、Diff & Merge 共同构成的 AI 应用数据闭环。
50 MiB,首先改变的是交付成本
与 1.3 相比,1.4 的基础资源变化如下:
| 指标 | seekdb 1.3 | seekdb 1.4 | 变化 |
|---|---|---|---|
pylibseekdb 包体积 |
160 MiB | 50 MiB | 下降 68.8% |
| seekdb 二进制 | 366.2 MiB | 132.4 MiB | 下降 63.9% |
| 空载稳态内存均值 | 630.6 MiB | 166.3 MiB | 下降 73.6% |
| 空载 CPU 均值 | 0.05 核 | 0.01 核 | 下降 70.3% |
测试口径:内存与 CPU 数据来自相同测试环境下的空载对比,用于衡量数据库自身的基础开销,不代表不同数据量和业务负载下的资源上限。表中降幅沿用发布说明,CPU 值仅展示两位小数。50 MiB 指
pylibseekdb核心包,不包含 Python SDK 的其他依赖、Embedding 模型和用户数据。
对于本地 AI 助手、桌面应用和端侧应用来说,数据库也是应用交付物的一部分。包体越小,下载和分发成本越低;基础资源开销越少,留给模型、数据和业务逻辑的空间就越多。

做减法,不等于简单裁剪
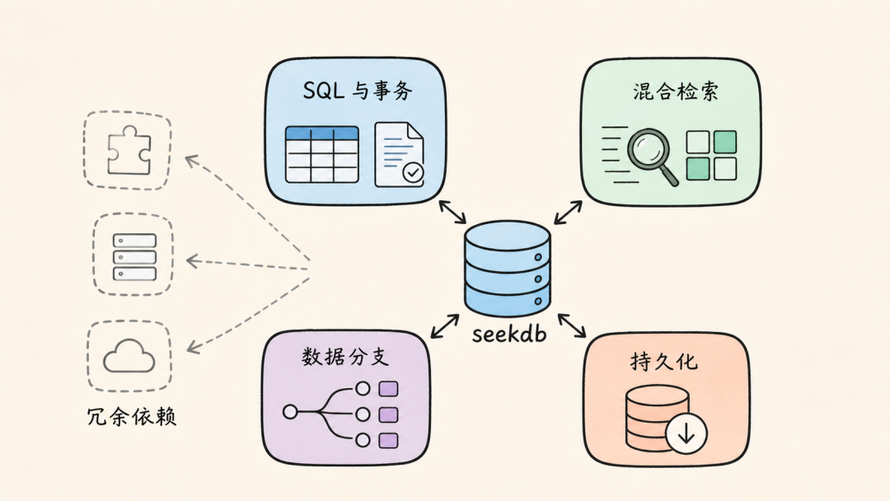
seekdb 源自面向大型生产系统的数据库内核,拥有成熟的 SQL、事务与存储能力,也带着一些更适合传统服务端场景的模块和依赖。1.4 清理了与目标场景关联较弱的功能路径、冗余代码和依赖,把资源集中到:
-
MySQL 兼容的 SQL 与事务处理;
-
向量、全文和标量数据的混合检索;
-
面向 Agent 持续写入与检索的索引能力;
-
Fork、Diff & Merge 数据版本管理;
-
本地数据持久化与可靠性保障。
这不是追求功能列表无限延展,而是 让 AI 应用真正需要的能力更容易交付、更轻地运行。
体积和内存,是怎样降下来的?
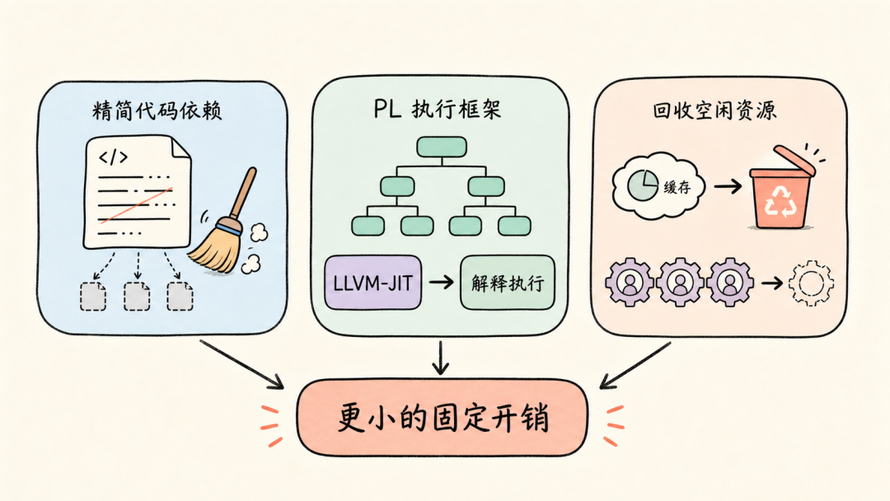
这次轻量化不是某一个编译参数带来的,而是覆盖构建依赖、执行框架和运行时资源管理的一系列调整。
第一,清理冗余代码与依赖
我们移除不再需要的代码路径和编译依赖,让二进制代码段明显收敛。更小的代码段不仅降低了二进制体积,也减少了运行时需要映射和驻留在内存中的代码页。
第二,重构 PL 执行框架
seekdb 1.4 将 PL 执行框架从基于 LLVM-JIT 的即时编译重构为 tree-walking 解释执行,减少构建依赖,让执行路径更轻、跨平台行为更一致;多数场景下的执行性能仍能得到保持。
第三,压缩空载时的内存和 CPU 开销
数据库即使没有业务请求,缓存、线程和后台任务也会持续消耗内存与 CPU。1.4 对这些基础成本逐项收敛:
-
集成 jemalloc,降低长期运行中的内存碎片;
-
回收 memstore、plan cache、KV cache 等空闲态内存;
-
精简冗余后台线程,并下调默认线程栈尺寸;
-
减少不必要的预分配与常驻对象。
这些优化使相同空载条件下的内存均值下降 73.6%,CPU 均值下降 70.3%。这不是业务负载资源上限的承诺,而是先降低数据库自身的固定成本。
嵌入式能力升级:多个应用可以同时使用同一份数据
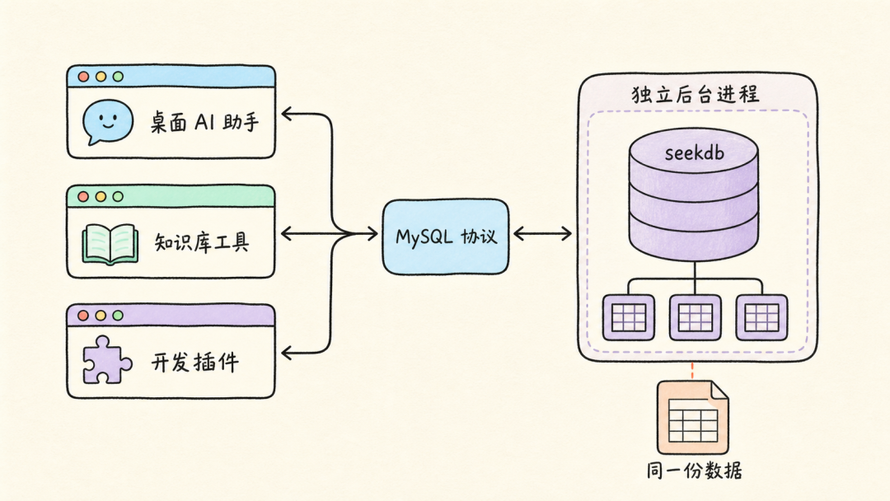
在此前的嵌入式模式下,同一份 seekdb 数据只能由一个应用打开;当一个应用正在使用数据库时,其他应用无法同时访问这份数据。
seekdb 1.4 解除了这一限制,支持 多个应用同时访问同一份 seekdb 数据。例如,桌面 AI 助手、知识库工具和开发者插件可以同时读取和更新同一份用户知识、Agent Memory 与业务状态,不再需要为每个应用各维护一份副本、额外同步。
这背后也有一项架构变化:1.4 的嵌入式模式改为由独立后台进程运行数据库,通过 MySQL 协议与应用通信。“嵌入式”仍指随应用部署和使用,不再等同于数据库内核运行在宿主应用进程内。
macOS 更稳定,开发技术栈也在演进
1.4 系统修复了 macOS 上 GIS 计算、排序、数值转换、浮点运算和 PL 等关键路径的问题,让本地开发和运行更加稳定。
seekdb 还第一次引入 Rust 技术栈,使用 Rust 重写 MySQL 协议栈与网络 I/O 层,为底层模块提供更稳健的演进基础。Bazel 原生模块 Bzlmod 也以 Preview 形式加入,带来增量编译、构建缓存和模块依赖分析能力。
此外,本次版本还修复了向量索引、SQL 执行、事务、主备库以及 Windows 平台上的一系列问题。完整清单请参见文末 Release Note。

跑一个最小 Demo
前面提到的
pylibseekdb 负责承载 seekdb 核心,
pyseekdb 则提供面向应用开发者的 Python API。在受支持的平台上,安装
pyseekdb 时会自动安装对应的
pylibseekdb。
准备 Python 3.11 或更高版本,然后安装 Python SDK:
pip install -U pyseekdb
下面的示例请在新建的测试目录中运行,写入两条 Agent Memory,刷新索引后检索:
import pyseekdb
client = pyseekdb.Client(path="./seekdb.db")
memory = client.get_or_create_collection("agent_memory")
memory.add(
    ids=["1", "2"],
    documents=[
        "user prefers dark mode",
        "user usually communicates in Chinese",
    ],
)
memory.refresh_index()
result = memory.query(
    query_texts=["dark mode preference"],
    n_results=1,
)
print(result["documents"][0])
pyseekdb 会自动为文档和查询生成 Embedding。第一次运行时会下载默认 Embedding 模型,之后将直接复用本地缓存;你也可以替换为业务所用的其他 Embedding 模型。
refresh_index() 用于主动刷新索引,让后续检索能查到刚写入的数据。对于异步索引,基表事务提交和向量检索可见之间存在时间窗口,不能把两者当成同一时点。

已有实例升级请注意:1.0.x、1.1.0、1.2.0、1.3.0 不支持原地升级到 1.4.0,需要使用 OBDUMPER/OBLOADER 或 mysqldump 进行逻辑迁移。上面的安装命令用于准备 SDK,不等于完成旧数据库升级。
seekdb 轻量化,不止是包更小
seekdb 是一款 MySQL 高度兼容、面向 AI 应用的数据库。它把关系数据、向量、全文和 JSON 放在同一套数据管理体系里,提供 SQL、事务、混合检索和数据分支能力。1.4 缩小了核心包和基础资源开销;放到完整的应用开发流程里,轻量化还有另外几层含义。
Agent 做试验,不必先复制整库
假设一个 Agent 要整理用户记忆:合并重复记录、调整标签,再生成后续计划。让它直接修改主数据,误写后不好收拾;每次试验都完整复制数据库,又要付出时间和存储成本。
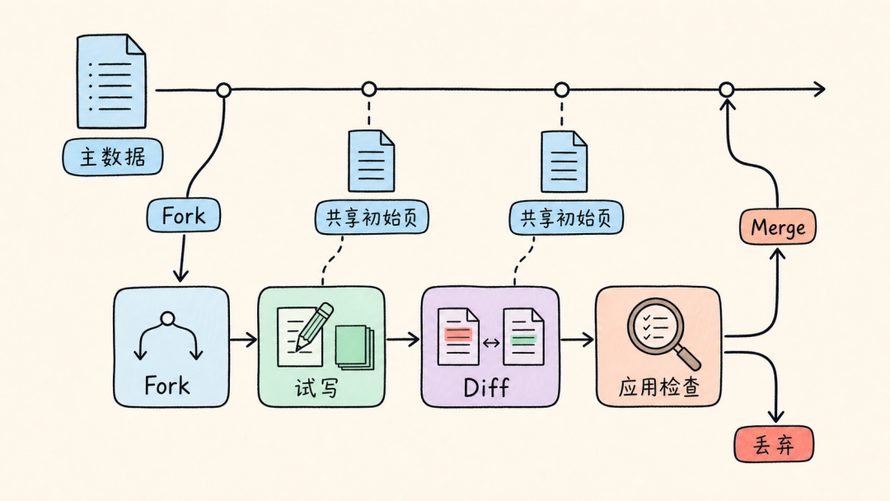
seekdb 提供原生的 Fork/Diff/Merge 工作流。
FORK DATABASE 可以创建数据库分支,
FORK TABLE 可以只针对一张表。底层采用写时复制(Copy-on-Write,COW),
创建分支时共享已有数据,后续写入再形成独立增量,无需先复制一整份数据。
Agent 可以在分支里多轮读写,再通过
DIFF TABLE 检查行级差异和冲突,由应用决定是否通过
MERGE TABLE 采纳结果。对于不需要保留的试验,可以清理对应分支。
这里减掉的是试验前的全量复制,以及应用自己维护数据副本的负担。分支后续写入仍会消耗资源,应用也需要管理权限、合并前校验和分支生命周期。COW 让试验更轻,业务规则决定哪些结果可以进入主数据。
从本地工具到独立服务,按需要选择形态
同样是保存记忆和做检索,个人桌面助手与团队共享知识库,对数据库的部署要求并不相同。seekdb 提供两种主要运行形态:
-
Embedded:通过 SDK 接入,随应用部署和交付,适合桌面 Agent、本地知识工具、边缘应用和开发测试;1.4 还支持多个应用共享同一实例。
-
Server:作为独立数据服务运行,通过 MySQL 协议、SQL 和标准驱动接入,适合跨主机访问、集中资源管理和统一运维。
两种形态共享数据模型、SQL 语义、索引和事务能力。应用可以从本地原型起步,再按协作范围和运维需要选择独立服务,不必一开始就搭建复杂的服务环境。
在平台支持上,seekdb 覆盖 Linux 的 x86_64、ARM64,Apple Silicon macOS,以及 x64 Windows。开发者可以在个人电脑上验证数据模型和 AI 流程,再面向实际交付平台选择部署方式;具体系统版本与 SDK 支持范围,以官方文档为准。
数据放在本地,也不意味着整条 AI 链路自动离线。若应用调用云端 Embedding、重排或生成模型,相应请求仍会访问外部服务,需要按实际数据边界配置。

不只看空载:边写边查时,检索稳不稳?
Agent 通常一边记录新观察,一边检索已有上下文。数据库除了待机时占用少,还要处理持续写入期间的查询。seekdb 的异步向量索引将事务写入与索引更新解耦,查询结合增量索引和稳定索引完成召回,以平衡写入与检索开销。
在已有的流式向量检索参考测试中,以千万级目标数据规模为例,seekdb 的查询吞吐为 1,523 QPS,串行查询 P99 为 19.7 ms,并发写入下 P99 为 21.7 ms,约为前者的 1.1 倍;对应 Recall 为 0.7397。这组数据展示的是给定召回水平下的吞吐与尾延迟,不能脱离配置单看 QPS。
测试采用 VDB StreamBench
[1] 流式工作负载:Cohere 768 维数据集,16 vCPU、64 GiB 内存,持续写入 500 行/秒;HNSW 参数为
M=16、
ef_construction=256、
ef_search=200,在写入到目标规模的 50% 和 80% 时进行查询测试,覆盖 5、10 两档查询并发,查询阶段在写入后继续运行 30 秒。
这些是 seekdb 已有能力的参考结果, 不是 1.4 相比 1.3 的新增性能对比,也不表示前文的 166.3 MiB 空载内存能够承载千万级向量。实际部署时,仍要结合数据规模、索引参数、召回率与读写负载评估资源。
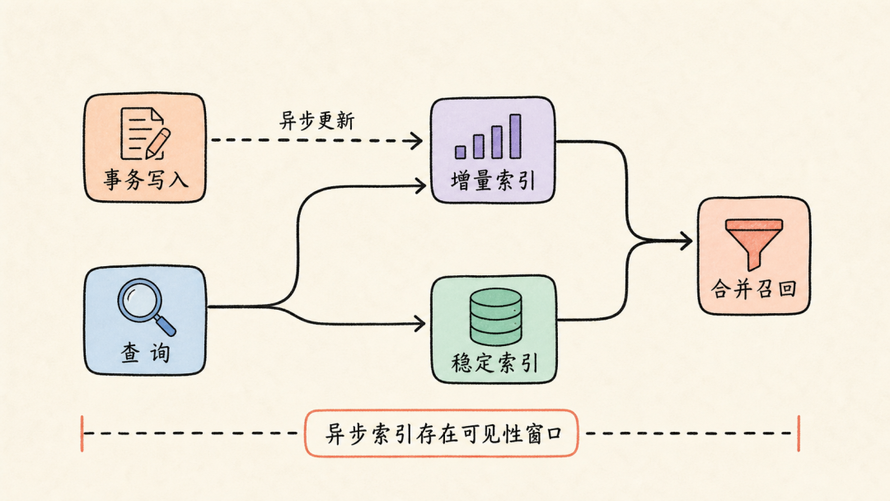
包体更小,降低的是交付成本;分支和多形态运行,减少的是应用试验与部署的负担;写查性能,则决定它能否接住后续的业务负载。这几件事放在一起,才是 AI 应用真正用得上的轻量化。
写在最后
50 MiB 不是最终目的,它代表一次更清晰的产品选择:减掉与目标场景关联较弱的负担,把资源集中到 AI 应用真正需要的数据能力上,把更多空间留给应用、数据和模型。
从本地部署,到 Agent 隔离试验,再到持续写入与检索,seekdb 希望让开发者少花一些精力搬数据、维护副本和拼接数据服务,多花一些精力打磨应用本身。

如果你正在为本地 AI 助手、Agent Memory、知识库或桌面应用寻找数据底座,欢迎运行上面的 Demo 试试看~
相关链接 / 文档
-
seekdb GitHub [2]
-
`pyseekdb` GitHub [3]
-
Python SDK 文档 [4]
-
完整更新日志:GitHub Release v1.4.0 [5]
如果 seekdb 对你有帮助,欢迎点一个 Star;如果遇到问题,也欢迎通过 GitHub Issues 和 Discussions 告诉我们~
参考资料[1]VDB StreamBench: https://github.com/oceanbase/vdb-streambench
[2]seekdb GitHub: https://github.com/oceanbase/seekdb
[3]pyseekdb GitHub: https://github.com/oceanbase/pyseekdb
[4]Python SDK 文档: https://docs.seekdb.ai/seekdb/pyseekdb-sdk-get-started
[5]完整更新日志:GitHub Release v1.4.0: https://github.com/oceanbase/seekdb/releases/tag/v1.4.0

往期内容推荐


了解更多
 添加社区小助手,加入微信交流群~
立即试用 OceanBase 企业版,体验国产数据库能力 立即试用
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/69909943/viewspace-3181197/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- FAST 2027 论文:OceanBase PromTCS 时间序列存储架构解析
- 基于 3 类具身智能场景,多模态数据底座统一架构实践
- GPT-6 发布“Better prompt cache” - 企业级数据库实践
- 联通广东产互 × OceanBase AI 存储底座实践 - 企业级数据库实践
- 被 TKDE 接收OceanBase 最新论文让大模型合成数 - 企业级数据库实践
- 被 VLDB 2027 接收OceanBase 最新论文让数据库基 - 企业级数据库实践
- 交易时延降 10% 以上 - 企业级数据库实践
- 亮相中国通信展主论坛 OceanBase 发布通信 AI 一 - 企业级数据库实践
- 跑出 AI 新能力OceanBase 刷新国际 Data Agent - 企业级数据库实践
- OceanBase × MiniMax × 行业伙伴 - 企业级数据库实践
