震惊!一次小时级到秒级的优化--原因实在不敢恭维
接到别人求助,背景是业务向开发投诉某个功能太慢。开发找支持人员,支持人员找到我。向我诉说了他们系统的背景。是一个国内知名大数据供应商,给业务做了一个功能。该功能其实是上传一个excel(又说到这个的数据库了)。
现象是上传上千条数据库很慢,如果更多的数据就更加慢。总之越多越慢,当然少的时候也不快,但是能等。不过在1000以上的时候基本应用程序都报超时。
但凡涉及到慢的我还都算擅长。我问了一下知道不知道处理逻辑?支持人员说可能打听到的逻辑是:更加excel的某几列去数据库的表中找到相应的数据,先进行一波删除。(别问为什么,我也不知道。据说是防止重复,为什么会重复,可能是重复导入。或者导入数据后觉得不准,再次导入。总之各式各样的原因要这样做)然后再吧excel的数据导入到表中。
其实说白了,就是一个数据同步功能。从一个数据库(excel)同步到另外一个数据库。本次是MySQL。
虽然整体设计和逻辑上我不认同这样做,但是这个又不是我的系统,帮别人就先按照优先的条件去做。介绍好了这些,我让他把数据库慢日志阈值放到0.1秒,然后操作上传excel的动作。我根据日志看看后台都发生了什么?
任何基于数据库的开发重要的不是开发语言而是SQL。增删改查就是Insert Delete Update和Select 俗称CRUD。
正式上传的时候,就看到那个页面的进度条不动(估计在初始化),然后进度条开始了。这时候就看到MySQL后台的日志大致是这样的。
我和小伙伴都惊呆了!
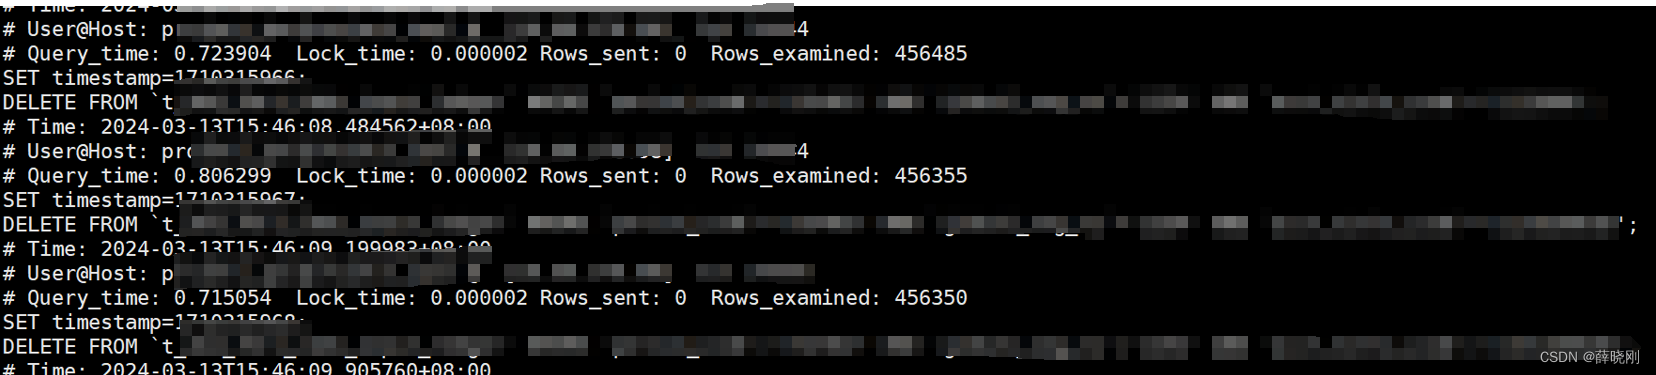

每删除一条遍历了45万数据(估计是全表,后来问了全表大致就这么多,判断正确)。然后他如果要删除1万条,那么就是循环1万次。
那数据就是:一次循环读取45万行,1万次,一共循环读取45亿行。单次约0.7秒。1万行就是7000多秒,将近2小时。然后删除以后再插入这些数据。有时候不要觉得不到1秒就很快,其实数据库真实的快超出一般人的想象。
难怪业务抱怨呢?说实在的这不就是没索引吗?听起来简单。现在很多风气就是好高骛远。小学没毕业就要上大学课程。
这就1万的数据同步到50万的场景,硬是搞出了大数据(48亿行的运算)的场景。有点5个人就是集团军的意思。难怪是国内大数据库公司,什么都是大数据姿势啊。
一提到大数据,我群里的群友都说我对CDH有怨念。我其实是对浪费人力物力财力有怨念。我国还是社会主义初级阶段,全世界最大的发展中国家。为什么总是这么浪费?不明真相的就认为什么都是大数据。其实不是呀!
硬盘装的东西多了就重?
而且有时候听到别人说这个机器负荷有点高。不少人还会说,大数据的机器是要负荷高的。其实未必是那么回事。
做技术的总有对技术的研究,深入研究的都知道大数据库本身就是数据库。原理也都是一样的,无论小马拉大车还是杀鸡用牛刀都是不合适的。
就这个案例而言,索引上去后。实际除去程序初始化的时间,就是几秒就完成了。虽然如果说这是我的系统,有权管理的话,我不认同这种设计。但是这不是我的,就这个而言先这样解决吧,已经估计能让业务发来贺电了。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/637517/viewspace-3009018/ ,如需转载,请注明出处,否则将追究法律责任。

