说明:从pdf文件中提取其他类型的数据,如文本或图像。将说明从pdf文件中提取数据表,然后将其转换为适合于进一步分析和构建模型的格式,以一个实例作为介绍。
使用Python从PDF文件中提取一个表格
1、将表复制到Excel并保存为table_1_raw.csv
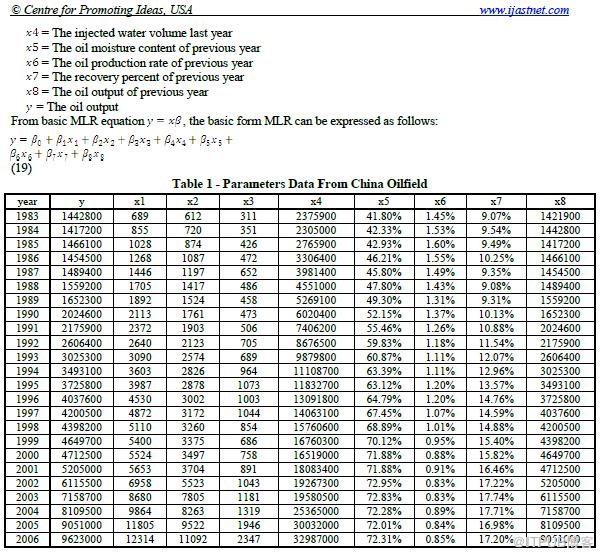
数据以一维格式存储,必须进行重塑、清理和转换。
2、导入必要的库
import pandas as pd
import numpy as np
3、导入原始数据,重新定义数据
df=pd.read_csv("table_1_raw.csv", header=None)
df.values.shape
df2=pd.DataFrame(df.values.reshape(25,10))
column_names=df2[0:1].values[0]
df3=df2[1:]
df3.columns = df2[0:1].values[0]
df3.head()
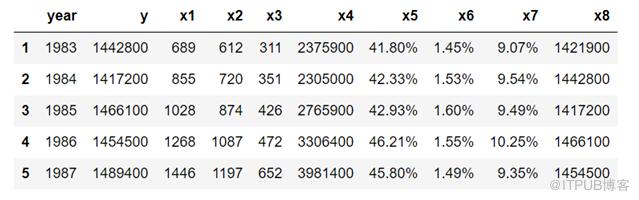
4、使用字符串处理工具进行数据纠缠
我们从上面的表格中注意到,x5、x6和x7列是用百分比表示的,所以我们需要去掉percent(%)符号:
df4['x5']=list(map(lambda x: x[:-1], df4['x5'].values))
df4['x6']=list(map(lambda x: x[:-1], df4['x6'].values))
df4['x7']=list(map(lambda x: x[:-1], df4['x7'].values))
5、将数据转换为数字形式
我们注意到列x5、x6和x7的列值数据类型为string,因此我们需要将它们转换为数值数据,如下所示:
df4['x5']=[float(x) for x in df4['x5'].values]
df4['x6']=[float(x) for x in df4['x6'].values]
df4['x7']=[float(x) for x in df4['x7'].values]
6、查看转换数据的最终形式
df4.head(n=5)
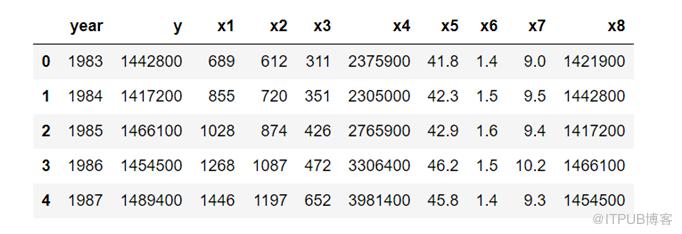
7、最后导出最终数据到一个csv文件
df4.to_csv('table_1_final.csv',index=False)
从第一步开始内容就很不简单,大家边看边动手就很容易理解哦~如需了解更多python实用知识,点击进入PyThon学习网教学中心。
(推荐操作系统:windows7系统、Python 3.9.1,DELL G3电脑。)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4715/viewspace-2832479/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
python3类方法使用时需要注意什么?
下一篇:
mysql提示sql语句版本不兼容怎么办

请登录后发表评论
登录
全部评论
