有的小伙伴对于动态网页的概念不是很清楚,这里我们简单的说一下。我们平时购物浏览的界面或者是上网查找资料的网页都是动态界面的一种,这样解释小伙伴们是不是恍然大悟了呢?其实动态界面在我们生活中还是比较常见的,今天小编就给大家带来json解析动态网页的方法,以论坛为例爬取上面的数据,具体的内容如下:
json是一种数据存储格式,可以被多种语言解析,一般用于数据传输。
data = json.loads(html_str);
all_items=data['topic_list']['topics'] write_content=[];
for item in all_items:
     slug = item['slug'];
     item_id = item['id']
     link = f'https://forum.cocos.org/t/{slug}/{item_id}'
     title = item['title'];
     like_count = item['like_count'];
     like_count = item['like_count'];
     posts_count = item['posts_count'];
     views = item['views'];
     created_at = item['created_at'];
     write_content.append({'标题': title, '链接': link, '点赞':like_count, '回复':posts_count, '浏览':views, '发帖时间':created_at});
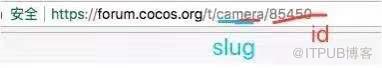
其中的链接地址可以通过打开几个论坛内容找到规律,是由 slug 和 id 这两个字段拼接的。
最后使用多线程 和 csv 存储结果。
pool = Pool(3);
orign_num=[x for x in range(0,10)];
result = pool.map(scrapy,orign_num);
with open('ccc_title_link.csv', 'w', newline='') as csvfile:
     fieldnames = ('标题', '链接', '点赞', '回复','浏览', '发帖时间')
     writer = csv.DictWriter(csvfile, fieldnames=fieldnames)
     writer.writeheader()
     for write_content in result:
         for _content in write_content:
             writer.writerow(_content);
以上方法最后得到的结果是论坛上文章的标题、链接等内容,对于我们查找信息来说是非常方便的。对于json解析使用不熟练的小伙伴可以课后再好好的了解一下,然后就可以完成动态网页的解析啦~更多Python学习指路:PyThon学习网教学中心。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4648/viewspace-2832047/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
