完整微服务化示例:使用 Apache ServiceComb (inc
摘要: 最完整的微服务化示例,从业务场景入手,讲述微服务化架构设计、容器化、集群部署、弹性伸缩
本文转载自 微服务 开源项目 Apache ServiceComb (incubating) 官网博客:
http://servicecomb.incubator.apache.org/cn/docs/linuxcon-workshop-demo/
http://servicecomb.incubator.apache.org/cn/docs/company-on-kubernetes/
http://servicecomb.incubator.apache.org/cn/docs/autoscale-on-company/
微服务架构作为新兴领域的架构模式,已步入产品化形态,与容器化、集群等一起成为了当下热点。而微服务、Docker、kubernetes 之间的关系,究竟这三者之间是什么样的关系,分别能在微服务领域发挥什么作用,却常给入门的读者和用户带来些许迷茫感。
本文使用一个简单的普适性的 微服务 示例,从 业务场景入手,到微服务架构设计、实现、容器化、集群部署、压测、弹性伸缩、资源控制,端到端以最直白的方式演示了这三者的关系,会给读者带来不一样的真切的理念体验和感受,增强对系列概念的理解。
Service Center:# all interconnected microservices must belong to an application wth the same IDAPPLICATION_ID: companyservice_description:# name of the declaring microservice name: worker version: 0.0.1# service center addresscse: service: registry: address: http://sc.servicecomb.io:30100 highway: address: 0.0.0.0:7070 rest: address: 0.0.0.0:8080
最后,提供技工服务应用启动入口,并加上 @EnableServiceComb 注释启用 ServiceComb :
@SpringBootApplication@EnableServiceCombpublic class WorkerApplication {  public static void main(String[] args) {
    SpringApplication.run(WorkerApplication.class, args);
  }
}
下载编译好的版本直接运行。
研究表明,雄蜂(Drone)由未受精卵孵化而生,只有母亲;而雌蜂(Queen)由受精卵孵化而生,既有母又有父。
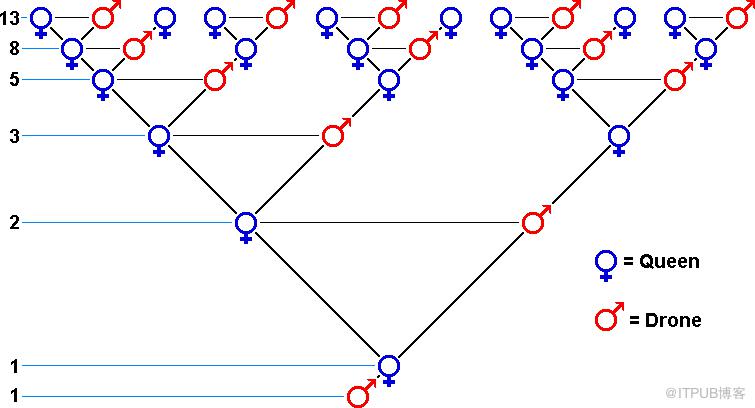 Credit: Dave Cushman’s website
参考上图,蜜蜂的某一代祖先数量符合黄金分割数列的模型,由此我们可以很快实现服务功能。
蜜蜂繁殖规律研究服务
首先我们定义黄金数列运算接口:
public interface FibonacciCalculator {  long term(int n);
}
接下来定义并实现蜜蜂繁殖规律研究服务:
interface BeekeeperService { long ancestorsOfDroneAt(int generation); long ancestorsOfQueenAt(int generation);
}class BeekeeperServiceImpl implements BeekeeperService { private final FibonacciCalculator fibonacciCalculator;
BeekeeperServiceImpl(FibonacciCalculator fibonacciCalculator) { this.fibonacciCalculator = fibonacciCalculator;
} @Override
public long ancestorsOfDroneAt(int generation) { if (generation
这里我们用到之前定义的 FibonacciCalculator 接口,并希望通过这个接口远程调用技工服务端点。@RpcReference 注释能帮助我们自动从Service Center中获取 microserviceName = "worker", schemaId = "fibonacciRpcEndpoint" , 即服务名为 worker 已经schema ID为 fibonacciRpcEndpoint的端点:
@Configurationclass BeekeeperConfig { @RpcReference(microserviceName = "worker", schemaId = "fibonacciRpcEndpoint") private FibonacciCalculator fibonacciCalculator; @Bean
BeekeeperService beekeeperService() { return new BeekeeperServiceImpl(fibonacciCalculator);
}
}
我们在技工一节已定义好对应的服务名和schema ID端点,通过上面的配置,ServiceComb 会自动将远程技工服务 实例和 FibonacciCalculator 绑定在一起。
养蜂人服务端点
与上一节技工服务相似,我们在这里也需要提供养蜂人服务端点,让用户可以进行调用:
@RestSchema(schemaId = "beekeeperRestEndpoint")@RequestMapping("/rest")@Controllerpublic class BeekeeperController { private static final Logger logger = LoggerFactory.getLogger(BeekeeperController.class); private final BeekeeperService beekeeperService; @Autowired
BeekeeperController(BeekeeperService beekeeperService) { this.beekeeperService = beekeeperService;
} @RequestMapping(value = "/drone/ancestors/{generation}", method = GET, produces = APPLICATION_JSON_UTF8_VALUE)
@ResponseBody
public Ancestor ancestorsOfDrone(@PathVariable int generation) {
logger.info( "Received request to find the number of ancestors of drone at generation {}",
generation); return new Ancestor(beekeeperService.ancestorsOfDroneAt(generation));
} @RequestMapping(value = "/queen/ancestors/{generation}", method = GET, produces = APPLICATION_JSON_UTF8_VALUE)
@ResponseBody
public Ancestor ancestorsOfQueen(@PathVariable int generation) {
logger.info( "Received request to find the number of ancestors of queen at generation {}",
generation); return new Ancestor(beekeeperService.ancestorsOfQueenAt(generation));
}
}class Ancestor { private long ancestors;
Ancestor() {
}
Ancestor(long ancestors) { this.ancestors = ancestors;
} public long getAncestors() { return ancestors;
}
}
因为养蜂人需要消费技工提供的服务,所以其 microservice.yaml 配置稍有不同:
# all interconnected microservices must belong to an application wth the same IDAPPLICATION_ID: companyservice_description:# name of the declaring microservice name: beekeeper version: 0.0.1cse: service: registry: address: http://sc.servicecomb.io:30100 rest: address: 0.0.0.0:8090 handler: chain: Consumer: default: bizkeeper-consumer,loadbalance references:# this one below must refer to the microservice name it communicates with worker: version-rule: 0.0.1
这里我们需要定义 cse.references.worker.version-rule ,让配置名称中指向技工服务名 worker ,并匹配其版本号。
最后定义养蜂人服务应用入口:
@SpringBootApplication@EnableServiceCombpublic class BeekeeperApplication { public static void main(String[] args) {
SpringApplication.run(BeekeeperApplication.class, args);
}
}
JSON Web Token (JWT)的机制,具体实现超出了这篇文章的范围, 细节大家可以查看github上workshop的 doorman 模块代码。
认证服务的接口如下,authenticate 方法根据用户名和密码查询确认用户存在,并返回对应JWT token。用户登录后的每次 请求都需要带上返回的JWT token,而 validate 方法将验证token以确认其有效。
public interface AuthenticationService { String authenticate(String username, String password); String validate(String token);
}
门卫认证服务端点
与前两节的Rest服务端点相似,我们加上 @RestSchema 注释,以便 ServiceComb 自动配置端点、生成契约并注册服务。
@RestSchema(schemaId = "authenticationRestEndpoint")@Controller@RequestMapping("/rest")public class AuthenticationController { private static final Logger logger = LoggerFactory.getLogger(AuthenticationController.class);
static final String USERNAME = "username";
static final String PASSWORD = "password";
static final String TOKEN = "token"; private final AuthenticationService authenticationService; @Autowired
AuthenticationController(AuthenticationService authenticationService) { this.authenticationService = authenticationService;
} @RequestMapping(value = "/login", method = POST, produces = TEXT_PLAIN_VALUE)
public ResponseEntity login( @RequestParam(USERNAME) String username, @RequestParam(PASSWORD) String password) {
logger.info("Received login request from user {}", username);
String token = authenticationService.authenticate(username, password);
HttpHeaders headers = new HttpHeaders();
headers.add(AUTHORIZATION, TOKEN_PREFIX + token);
logger.info("Authenticated user {} successfully", username); return new ResponseEntity("Welcome, " + username, headers, OK);
} @RequestMapping(value = "/validate", method = POST, consumes = APPLICATION_JSON_UTF8_VALUE, produces = TEXT_PLAIN_VALUE)
@ResponseBody
public String validate(@RequestBody Token token) {
logger.info("Received validation request of token {}", token); return authenticationService.validate(token.getToken());
}
}class Token { private String token;
Token() {
}
Token(String token) { this.token = token;
} public String getToken() { return token;
} @Override
public String toString() { return "Token{" + "token='" + token + ''' + '}';
}
}
同样,我们需要提供服务应用启动入口以及 microservice.yaml:
@SpringBootApplication@EnableServiceCombpublic class DoormanApplication { public static void main(String[] args) {
SpringApplication.run(DoormanApplication.class, args);
}
}
# all interconnected microservices must belong to an application wth the same IDAPPLICATION_ID: companyservice_description:# name of the declaring microservice name: doorman version: 0.0.1cse: service: registry: address: http://sc.servicecomb.io:30100 rest: address: 0.0.0.0:9090
Netflix Zuul作为候选人并加以培训, 提升其能力,以保证其能胜任该职位。
首先我们引入依赖:
org.apache.servicecomb
spring-boot-starter-discovery
Service Center 中的服务注册信息,只需在地址中以如下格式包含被调用的服务名cse://doorman/path/to/rest/endpoint
ServiceComb 将自动查询对应服务并发送请求到地址中的服务端点。
@Servicepublic class AuthenticationService { private static final Logger logger = LoggerFactory.getLogger(AuthenticationService.class); private static final String DOORMAN_ADDRESS = "cse://doorman"; private final RestTemplate restTemplate;
AuthenticationService() { this.restTemplate = RestTemplateBuilder.create(); this.restTemplate.setErrorHandler(new ResponseErrorHandler() { @Override
public boolean hasError(ClientHttpResponse clientHttpResponse) throws IOException { return false;
} @Override
public void handleError(ClientHttpResponse clientHttpResponse) throws IOException {
}
});
} @HystrixCommand(fallbackMethod = "timeout") public ResponseEntity validate(String token) {
logger.info("Validating token {}", token);
ResponseEntity responseEntity = restTemplate.postForEntity(
DOORMAN_ADDRESS + "/rest/validate",
validationRequest(token),
String.class
); if (!responseEntity.getStatusCode().is2xxSuccessful()) {
logger.warn("No such user found with token {}", token);
}
logger.info("Validated request of token {} to be user {}", token, responseEntity.getBody()); return responseEntity;
} private ResponseEntity timeout(String token) {
logger.warn("Request to validate token {} timed out", token); return new ResponseEntity(REQUEST_TIMEOUT);
} private HttpEntity validationRequest(String token) {
HttpHeaders headers = new HttpHeaders();
headers.setContentType(MediaType.APPLICATION_JSON_UTF8); return new HttpEntity(new Token(token), headers);
}
}
workshop的 manager 模块代码。
Workshop demo项目也包含大量完整易懂的测试 代码,以及使用docker集成微服务,模拟生存环境,同时应用Travis搭建持续集成环境,体现 DevOps在微服务开发中的实践。希望能对大家有所帮助。
github上已经提供了在kubernetes集群上一键式部署的功能。本文将着重讲解相应的yaml文件和服务间通信,这对于开发者基于Company 模型进行微服务开发并且部署到云上将会有所帮助。
Run Company on Kubernetes Cluster 提供了详细的使用方法,读者只需通过以下3条指令,就可将company在kubernetes集群上部署起来,git clone https://github.com/ServiceComb/ServiceComb-Company-WorkShop.gitcd ServiceComb-Company-WorkShop/kubernetes/bash start.sh
kube-dns将会自动解析该servicename。
对于kubernetes如何实现服务间通信,可以阅读connect-applications-service。
其他的deployment.yaml以及service.yaml都跟以上大同小异,唯一例外的是company-manager服务,我们可以看到在company-manager-service.yaml中看到定义了nodePort,这将使能company-manager对集群外部提供公网IP和服务端口,如下:
spec: ports:
- name: "8083"
port: 8083
targetPort: 8080
nodePort: 30301
protocol: TCP type: NodePort
可以通过以下方法获得公网IP和服务端口:
kubectl get svc company-manager -o yaml | grep ExternalIP -C 1kubectl get svc company-manager -o yaml | grep nodePort -C 1
接下来你就可以使用公网IP和服务端口访问已经部署好的company了,在github.com/ServiceComb/ServiceComb-Company-WorkShop/kubernetes上详细提供了通过在集群内访问和集群外访问的方法。
Run Acmeair on Kubernetes获取 。
heapster,可直接获取下载获取,需要调整一个参数,后直接运行kube.sh脚本进行安装。vi LinuxCon-Beijing-WorkShop/kubernetes/heapster/deploy/kube-config/influxdb/heapster.yaml
spec: replicas: 1 template: metadata: labels: task: monitoring k8s-app: heapster spec: serviceAccountName: heapster containers: - name: heapster image: gcr.io/google_containers/heapster-amd64:v1.4.1 imagePullPolicy: IfNotPresent command: - /heapster#集群内安装直接使用kubernetes - --source=kubernetes#集群外安装请直接将下面的服务地址替换为k8s api server地址# - --source=kubernetes:http://10.229.43.65:6443?inClusterConfig=false - --sink=influxdb:http://monitoring-influxdb:8086
启动Company:
下载Comany支持弹性伸缩的代码:
git clone https://github.com/ServiceComb/ServiceComb-Company-WorkShop.git
cd LinuxCon-Beijing-WorkShop/kubernetes/
bash start-autoscale.sh
在Company的deployment.yaml中, 增加了如下限定资源的字段,这将限制每个pod被限制在200mill-core(1000毫core == 1 core)的cpu使用率以内。
resources: limits: cpu: 200m
在 start-autoscale.sh 中,对每个deployment创建HPA(pod水平弹性伸缩器)资源,限定每个pod的副本数弹性伸缩时控制在1到10之间,并限定每个pod的cpu占用率小于50%,结合前面限定了200mcore,故,每个pod的的平均cpu占用率会被HPA通过弹性伸缩能力控制在100mcore以内。
# Create Horizontal Pod Autoscalerkubectl autoscale deployment zipkin --cpu-percent=50 --min=1 --max=10kubectl autoscale deployment company-bulletin-board --cpu-percent=50 --min=1 --max=10kubectl autoscale deployment company-worker --cpu-percent=50 --min=1 --max=10kubectl autoscale deployment company-doorman --cpu-percent=50 --min=1 --max=10kubectl autoscale deployment company-manager --cpu-percent=50 --min=1 --max=10kubectl autoscale deployment company-beekeeper --cpu-percent=50 --min=1 --max=10
当运行start-autoscale.sh之后,具备弹性伸缩器的company已经被创建,可通过下面指令进行HPA的查询:
kubectl get hpa
启动压测:
export $HOST=:bash LinuxCon-Beijing-WorkShop/kubernetes/stress-test.sh
该脚本不断循环执行 1s内向Company请求计算 fibonacci 数值200次,对Company造成请求压力:
FIBONA_NUM=`curl -s -H "Authorization: $Authorization" -XGET "http://$HOST/worker/fibonacci/term?n=6"`
文章中提到: 微服务是一种架构风格,一个大型复杂软件应用由一个或多个微服务组成。系统中的各个微服务可被独立部署,各个微服务之间是松耦合的。每个微服务仅关注于完成一件任务并很好地完成该任务。在所有情况下,每个任务代表着一个小的业务能力。
国内实践微服务的先行者王磊先生也在《微服务架构与实践》一书中进行了全面论述。
Company使用ServiceComb进行微服务化改造后,具备了微服务的属性,故可以对单个负载较大的company-manager这个微服务进行精细化的控制,达到按需的目的,相比传统单体架构来讲,这将大大帮助准确有效地化解应用瓶颈,提高资源的利用效率。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4547/viewspace-2808650/ ,如需转载,请注明出处,否则将追究法律责任。

