1背景
关于水塘抽样的算法原理此处不再说明了, 本文重点是针对它的一种应用场景, 具体算法原理可参考水塘抽样算法原理
2问题:
在编写Spark程序时, 鉴于内存等资源不够, 然而Hbase数据量又十分巨大(100亿数据, 申请资源Spark核数以及内存较小), 此时在Spark应用程序中调用了repartition进行重新分区, 导致了大量Shuffle 网络IO, 很有可能使得Spark应用程序瘫痪. 因此想到一种委婉的解决方式, 使用水塘抽样算法, 它可以在一开始不知道数据总量的情况下进行抽样, 最终得到接近均匀的分区. 具体解决原理是先进行扫描Hbase进行水塘抽样,抽样出rowKey, 然后分别针对这些rowKey进行单独scan扫描处理, 由于处理的数据量小了就可以保证应用程序不崩溃. 此处是保证可用性牺牲了性能.
解决方式:
使用水塘抽样算法
Hbase预分region,并配置合适的region 分隔算法, 保证每个region数据量不要太大, 按region扫描
3代码
3.1水塘抽样解决代码
此处给出一个基本的Demo,
首先创建一个字节数组封装类, 用于比较字节数组(rowKey)
package hbase;import org.apache.hadoop.hbase.util.Bytes;/** * Created by zhangkai12 on 2018/6/27. */public class MyBytes implements Comparable{ private byte[] bytes; public MyBytes(byte[] bytes) { this.bytes = bytes; } public byte[] getBytes() { return bytes; } public void setBytes(byte[] bytes) { this.bytes = bytes; } @Override public int compareTo(MyBytes o) { return Bytes.compareTo(this.bytes, o.getBytes()); } }
其次创建一个Hbase基本处理类
package hbase;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.hbase.HBaseConfiguration;import org.apache.hadoop.hbase.TableName;import org.apache.hadoop.hbase.client.Connection;import org.apache.hadoop.hbase.client.ConnectionFactory;import org.apache.hadoop.hbase.client.Table;import java.io.IOException;public class HbaseUtil {    static Configuration conf = HBaseConfiguration.create();    private static Connection connection;    public HbaseUtil(String zkUrl) {
        conf.set("hbase.zookeeper.quorum", zkUrl);
        conf.set("hbase.client.operation.timeout", "60000");
    }    public static synchronized Connection getConn() {        if (connection == null) {            try {
                connection = ConnectionFactory.createConnection(conf);
            } catch (IOException e) {
                e.printStackTrace();
            }
        }        return connection;
    }    public static Table getTable(String tableName) throws IOException {
        Table table = getConn().getTable(TableName.valueOf(tableName));        return table;
    }    public static void closeTable(Table table) {        if (table == null) {            return;
        }        try {
            table.close();
        } catch (IOException e) {
            e.printStackTrace();
        }
    }
}
最后就是最终的抽样算法类, 此处的抽样函数直接将Spark的scala代码移植成java版本的.
package hbase;import org.apache.hadoop.hbase.client.Result;import org.apache.hadoop.hbase.client.ResultScanner;import org.apache.hadoop.hbase.client.Scan;import org.apache.hadoop.hbase.client.Table;import org.apache.hadoop.hbase.util.Bytes;import java.io.IOException;import java.util.*;import java.util.stream.Collectors;import java.util.stream.Stream;/**
 * Created by zhangkai12 on 2018/6/27.
 */public class Sample {    private static final byte[] ROW_END = new byte[]{-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1,-1};    private static final byte[] ROW_START = {0};    public static void main(String[] args) {
        Table table = null;
        ResultScanner scanner = null;        try {
            table = HbaseUtil.getTable("myedge");
            Scan scan = new Scan();
            scan.addFamily(Bytes.toBytes("g"));
            scanner = table.getScanner(scan);
            Iterator iterator = scanner.iterator();            byte[][] rowKeys = reservoirSampleAndCount(iterator, 20, 100);

            System.out.println("----------------------sort before----------------------");
            Arrays.stream(rowKeys).forEach(res -> {
                System.out.println(" value " + Arrays.toString(res));
            });

            System.out.println("----------------------sort after----------------------");
            Stream sorted = Arrays.stream(rowKeys).map(res -> new MyBytes(res)).sorted();
            Arrays.stream(rowKeys).map(res -> new MyBytes(res)).sorted().forEach(res -> {
                System.out.println("****" + Arrays.toString(res.getBytes()));
            });
            List collect = sorted.collect(Collectors.toList());            byte[] start = ROW_START;            byte[] end;            int sumNum = 0;            if (null != collect) {                for (int i = 0; i  input, int k, long seed) {        byte[][] reservoir = new byte[k][];        int i = 0;        while (i  iterator = scanner.iterator();            while (iterator.hasNext()) {
                Result next = iterator.next();                byte[] row = next.getRow();
                String s = Bytes.toString(row);
                System.out.println(Arrays.toString(row) + "---" + s);
                num ++;
            }
            System.out.println("---num-----: " + num);
        } catch (IOException e) {
            e.printStackTrace();
        } finally {            if (null != scanner) {
                scanner.close();
            }            if (null != table) {
                HbaseUtil.closeTable(table);
            }
        }        return num;
    }    private static int getSumWithNOSampleMethod() {        int num = 0;
        Table table = null;
        ResultScanner scanner = null;        try {
            table = HbaseUtil.getTable("myedge");
            Scan scan = new Scan();
            scan.addFamily(Bytes.toBytes("g"));
            scanner = table.getScanner(scan);
            Iterator iterator = scanner.iterator();            while (iterator.hasNext()) {
                Result next = iterator.next();
                num ++;
            }
        } catch (IOException e) {
            e.printStackTrace();
        } finally {            if (null != scanner) {
                scanner.close();
            }            if (null != table) {
                HbaseUtil.closeTable(table);
            }
        }        return num;
    }
}
3.2 按Region进行数据处理
package hbase;import org.apache.hadoop.conf.Configuration;import org.apache.hadoop.hbase.HBaseConfiguration;import org.apache.hadoop.hbase.HRegionInfo;import org.apache.hadoop.hbase.TableName;import org.apache.hadoop.hbase.client.*;import org.apache.hadoop.hbase.util.Bytes;import java.util.Arrays;import java.util.Iterator;import java.util.List;/**
 * Created by zhangkai12 on 2018/6/27.
 */public class HbaseRegion {    public static void main(String[] args) {        try {
            checkTable("Janus321");
        } catch (Exception e) {
            e.printStackTrace();
        }
    }    private static void checkTable(String tabName) throws Exception {
        TableName tn = TableName.valueOf(tabName);
        Configuration config = HBaseConfiguration.create();
        HRegionInfo regionInfo;
        Connection connection = null;
        Admin admin = null;
        Table table = null;        try  {
            connection = ConnectionFactory.createConnection(config);
            admin = connection.getAdmin();
            table = connection.getTable(tn);            if (!admin.tableExists(TableName.valueOf(tabName))) {                return;
            }
            List lr = admin.getTableRegions(tn);
            Result r = null;            if (lr == null) {
                System.out.print("No region found for table " + tabName);
            }            // 遍历表的每个region
            Iterator ir = lr.iterator();            int i = 1;            while (ir.hasNext()) {
                regionInfo = ir.next();
                ResultScanner scanner = null;                byte[] startRowkey = regionInfo.getStartKey();
                System.out.println("----start----" + Bytes.toString(startRowkey));                byte[] endKey = regionInfo.getEndKey();
                System.out.println("----end----" + Bytes.toString(endKey));
                Scan sc = new Scan();
                sc.setBatch(1);
                sc.setStartRow(startRowkey);
                sc.setStopRow(endKey);                try {
                    scanner = table.getScanner(sc);
                    Iterator iterator = scanner.iterator();                    while (iterator.hasNext()) {
                        Result next = iterator.next();                        byte[] row = next.getRow();
                        System.out.println("第" + i + " 批 " + Arrays.toString(row));
                    }
                } finally {                    if (null != scanner) {
                        scanner.close();
                    }
                }
                i ++;
            }
        }catch (Exception e) {

        } finally {            if (null != table) {
                table.close();
            }            if (null != admin) {
                admin.close();
            }            if (null != connection) {
                connection.close();
            }
        }
    }
}
4水塘抽样结果图
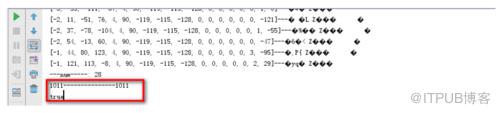
水塘抽样结果图
根据水塘抽样结果图可以发现, 我们通过抽样算法处理的数据总量和不使用抽样算法的数据总量是一致的,也就保证了算法的准确性.
作者:kason_zhang
链接:https://www.jianshu.com/p/587613b08cee
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4419/viewspace-2810483/ ,如需转载,请注明出处,否则将追究法律责任。

