好了,现在鉴黄的demo可以跑通了,就差大量的数据了(就是黄图)
这可难倒了纯洁的宝宝。
本宝宝表示找了好几天都找不到一张黄图

后来问了一些老司机,得到了一些资源丰富的网址
不过本宝宝还是不好意思打开~就只能写一个小爬虫批量下载了-.-
其实就是用python的urllib完成打开、下载等操作,直接简单的匹配该后缀jpg的就好了
#coding=utf-8import urllibimport redef getHtml(url):page = urllib.urlopen(url)html = page.read()return htmldef getImg(html):reg = r'class="lazyload" src="data:image/png;base64,iVBORw0KGgoAAAANSUhEUgAAAAEAAAABCAYAAAAfFcSJAAAAAXNSR0IArs4c6QAAAARnQU1BAACxjwv8YQUAAAAJcEhZcwAADsQAAA7EAZUrDhsAAAANSURBVBhXYzh8+PB/AAffA0nNPuCLAAAAAElFTkSuQmCC" data-original="(.+?.jpg)" pic_ext'imgre = re.compile(reg)imglist = re.findall(imgre,html)x = 0for imgurl in imglist:urllib.urlretrieve(imgurl,'%s.jpg' % x)x+=1return 'OK!'html = getHtml("某些资源丰富的网站")print getImg(html)
效果还是蛮不错的~~
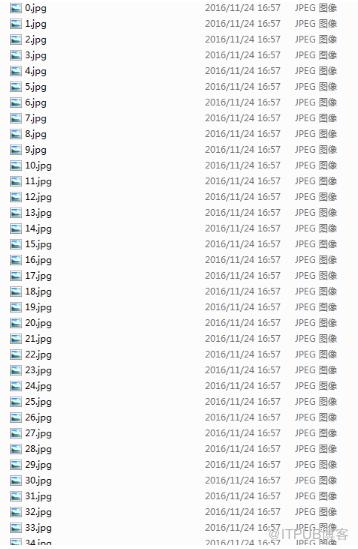
好了不说了,我要去测(yong)试(zhi)了

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4365/viewspace-2804773/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
