论文:《Learning Similarity Conditions Without Explicit Supervision》
论文笔记
1. 简介
目前搭配方面的工作都比较依赖于多种相似条件,比如在颜色、类型和形状的相似性,通过学习到基于条件的 embedding,这些模型可以学习到不同的相似信息,但是也受限于这种做法以及显式的标签问题,导致它们没办法生成没见过的类别。
所以,本文希望在弱监督的条件下,将不同的相似条件和属性作为一个隐变量,学习到对应的特征子空间,如下图所示,对比了本文的方法和先前的一些工作。
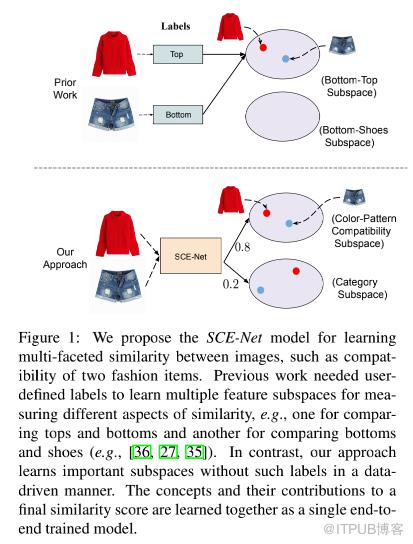
先前的工作需要用户定义的标签来学习不同相似性的特征子空间,比如上衣和裤子的子空间,或者裤子和鞋子的子空间。而对于本文的方法来说,并不需要这些显式的标签来学习特征子空间。
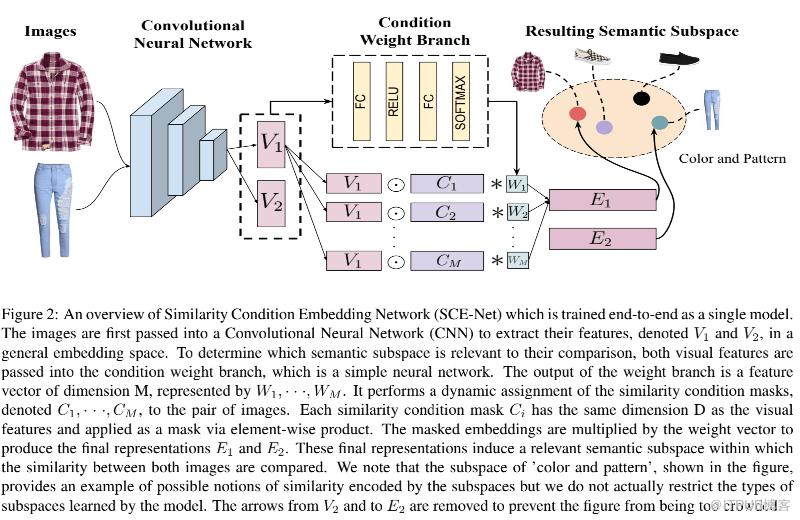
本文是提出了一个相似条件向量网络(Similarity Condition Embedding Network,SCE-Net)模型从一个统一的向量空间中联合学习不同的相似条件,一个整体结构示意图如下所示:
- 每张图片会经过一个 CNN 网络,然后映射到统一的向量空间中
- 该网络比较核心的部分是一系列平行的相似条件 masks,即图中的 KaTeX parse error: Expected 'EOF', got ',' at position 9: C_1, C_2,̲cdots, C_M,这些 masks 是通过图中的条件权重分支所学习到的;
- 图中的条件权重分支可以被看做是一种 attention 机制,对正在进行比较的对象,动态分配每种条件 mask;
本文的贡献归纳如下:
- 本文提出了一个 SCE-Net 模型,它可以在没有显式类别或者属性的监督条件下,从图片中学习到丰富的不同相似条件的特征;
- 本文提出的 SCE-Net 模型也很适合 zero-shot 任务中的新类别和属性;
- 更重要的是,我们证明了一个动态加权机制在帮助一个弱监督模型学习不同相似概念的表示是不可或缺的。
2. 方法
这部分将介绍本文提出的 SCE-Net 模型,它是在一个弱监督条件下,将不同的相似条件以及属性当做隐变量,从而学习到对应的特征子空间。
首先输入的图片将输入到 CNN 中提取特征,这里我们用 g(x;θ)g(x;theta)g(x;θ) 进行表示,其中 x 表示输入图片,而θthetaθ 表示模型参数。本文的网络主要包含两个部件:
- 一套平行相似条件的掩码;
- 一个条件权重分支
这会在接下来的两个小节里分别介绍,然后第三小节会介绍在不同输入形式下,条件权重分支的变形。
2.1 学习相似的条件
本文的模型的一个关键组件就是一组 M 个平行的相似条件掩码,记作 C1,C2,⋯,CMC_1, C_2,cdots,C_MC1,C2,⋯,CM,其维度是 D,其中 M 是通过held out data 进行实验得到的数值。
这组相似条件掩码和图片特征进行点积的计算,从而让图片特征映射到一个编码了不同相似子结构的二阶语义子空间 RDR^DRD.
令 CjC_jCj 表示每个相似条件掩码,ViV_iVi 表示生成的图片特征,则上述操作可以如下所示:
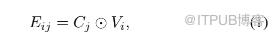
上述输出结果的维度是 M×DMtimes DM×D,令 O 表示掩码操作的输出,即 O=[Ei1,⋯,EiM]O=[E_{i1},cdots,E_{iM}]O=[Ei1,⋯,EiM] ,所以最终的输出为:
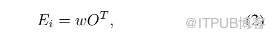
这里的 w 是一个维度为 M 的权重向量,它是由条件权重分支计算得到的。
2.2 条件权重分支
没有选择预先定义一套相似条件,本文选择使用一个条件权重分支来让模型自动决定需要学习的条件。
条件权重分支会基于一对给定比较的对象决定了每个条件掩码的关联性。对于一对图片 xi,xjx_i, x_jxi,xj ,它们经过 CNN 提取到的特征计算如下所示:
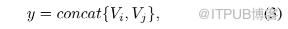
这里的 concat 表示连接操作,如之前给出的整体结构图所示,经过 CNN 提取特征然后进行 concat 操作后,将进入条件权重分支,主要是包括多个全连接层和 RELU 激活函数,最后使用一个 softmax 层得到 M 维的向量 w。
对于学习复杂相似性关系的时候,很常用的一个方法就是 triplet loss。我们定义一个三元组 xi,xj,xk{x_i, x_j, x_k}xi,xj,xk ,其中 xix_ixi 是目标对象,而 xj,xkx_j, x_kxj,xk 则分别是正负样本,即在一些不可见的条件 c 下,和 xix_ixi 在语义上相似和不相似的两个样本。triplet loss 的计算如下所示:
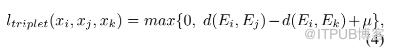
其中 d(Ei,Ej)d(E_i, E_j)d(Ei,Ej) 采用的是欧式距离,然后间隔 μmuμ 是一个超参数。
除此之外,本文还对相似条件掩码采用一个 L1 loss 来鼓励稀疏性和分离性。另外还用一个 L2 loss 来约束学习的图片特征,所以最终整个模型的目标函数如下所示:
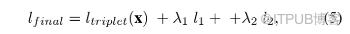
2.3 SCE-Net 的多种变体
除了仅输入图片外,本文也进行了其他不同输入形式的实验,这包括了:
- 文本特征:本文也可以输入一对文本,表示类别标签或者是图片的文本描述。对于一个句子会采用预先训练的词向量进行预处理,那么输入到条件权重分支的输入特征如下所示:
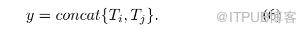
- 视觉-文本特征:对于给定的一对图片特征 (Vi,Vj)(V_i, V_j)(Vi,Vj) 和其文本特征 (Ti,Tj)(T_i, T_j)(Ti,Tj) ,输入到条件权重分支的特征如下所示:
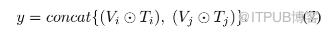
实际上还有其他处理文本和图片特征的方式,比如连接后映射到相同的向量空间,但是在本文实验中上述直接进行点积操作是性能最好的。
3. 实验
本文采用了 3 个数据集进行实验,分别是 Maryland-Polyvore , Polyvore-Outfits,以及 UT-Zappos50k。其中前两个数据集包含两种任务的验证集,分别是搭配匹配性预测和 fill-in-the-blank 任务,而第三个数据集是用于评估本文模型识别不同强度的属性的能力。
3.1 数据集
-
Maryland-Polyvore:该数据集包含了在社交网站 Polyvore 上的 21799 套搭配,这里采用作者提供的分割好的训练集、验证集和测试集,分别是 17316,1407 和 3076 套搭配;
-
Polyvore-Outfits:这个比上个数据集更大一些,包含了 53306 套搭配的训练集和 10000 套搭配的测试集,5000 套搭配的验证集,同样来自 Polyvore 网站,但和 Maryland-Polyvore 不同的是,该数据集还包含了衣服类别标签和相关文本描述的标注信息;
-
UT-Zappos50k:这是一个包含 50000 张鞋子图片的数据集,同时还有一些标注信息,这里采用论文《Conditional similarity networks》提供的基于四个不同条件进行采样得到的三元组,包括鞋子类型、鞋子性别、鞋跟高度以及鞋子闭合机制。因此每种特性分别得到的三元组数量是训练集20 万组、验证集 2 万组以及测试集4 万组,不过在训练本文的模型的时候,将来自同个特征的三元组都聚集到一个单独的训练集中。
3.2 实验细节
对于两个 Polyvore 数据集,采用一个 Resnet18 作为提取图片特征的网络模型,然后 embedding 大小是 64。对于文本描述的表示方法,这里采用了word2vec 的 HGLMM 费舍尔向量(fisher vector),并用 PCA 降维到 6000。另外,还增加了两个 loss,VSE 和 Sim,分别表示:
- VSE:视觉-语义损失函数,其目标是让三元组中同一个对象的图片特征和其对应的文本特征要更靠近一些;
- Sim:一个损失函数,目标是让相似的图片或者相似的文本描述特征的距离变得更近;
所以,最终的 loss 如下所示:
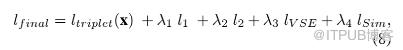
对于第三个数据集,因为采用三元组的输入,所以输入到条件权重分支的输入如下所示:
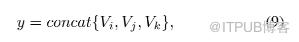
分别对应输入图片 xi,xj,xk{x_i, x_j, x_k}xi,xj,xk 。
3.3 实验结果
对于在两个 Polyvore 数据集上的实验结果,如下所示,对比的方法是 Siamese 网络和 Type-Aware Embedding 网络模型:
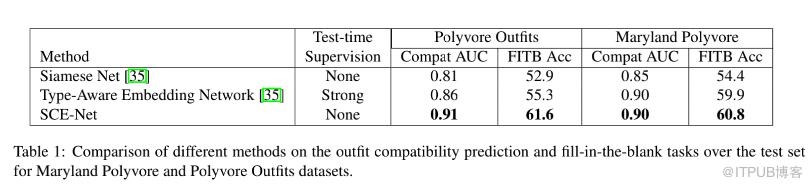
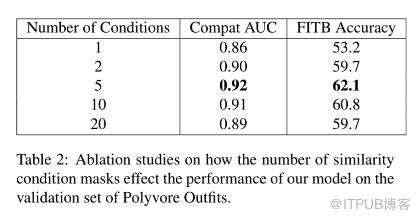
使用的条件数量的实验,如下所示,看到对于 Polyvore 数据集,当只用 5 个条件的时候,模型性能最佳。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/4352/viewspace-2797841/ ,如需转载,请注明出处,否则将追究法律责任。

