一. Spark 心跳概述
前面两节中介绍了 Spark RPC 的基本知识,以及深入剖析了 Spark RPC 中一些源码的实现流程。
具体可以看这里:
这一节我们来看看一个 Spark RPC 中的运用实例 – Spark 的心跳机制。这次主要还是从代码的角度来看。
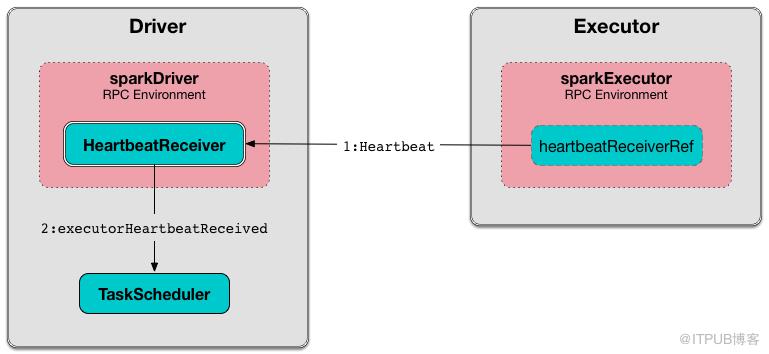
我们首先要知道 Spark 的心跳有什么用。心跳是分布式技术的基础,我们知道在 Spark 中,是有一个 Master 和众多的 Worker,那么 Master 怎么知道每个 Worker 的情况呢,这就需要借助心跳机制了。心跳除了传输信息,另一个主要的作用就是 Worker 告诉 Master 它还活着,当心跳停止时,方便 Master 进行一些容错操作,比如数据转移备份等等。
我们同样分成两部分来分析 Spark 的心跳机制,分为服务端(Spark Context)和客户端(Executor)。
二. Spark 心跳服务端 heartbeatReceiver 解析
我们可以发现,SparkContext 中有关于心跳的类以及 RpcEndpoint 注册代码。
class SparkContext(config: SparkConf) extends Logging {
	......
	private var _heartbeatReceiver: RpcEndpointRef = _
	......
	//向 RpcEnv 注册 Endpoint。
    _heartbeatReceiver = env.rpcEnv.setupEndpoint(HeartbeatReceiver.ENDPOINT_NAME, new HeartbeatReceiver(this))
	......
	  val (sched, ts) = SparkContext.createTaskScheduler(this, master, deployMode)
    _schedulerBackend = sched
    _taskScheduler = ts
    _dagScheduler = new DAGScheduler(this)
    _heartbeatReceiver.ask[Boolean](TaskSchedulerIsSet)
	......
}
这里 rpcEnv 已经在上下文中创建好,通过 setupEndpoint 向 rpcEnv 注册一个心跳的 Endpoint。还记得上一节中 HelloworldServer 的例子吗,在 setupEndpoint 方法中,会去调用 Dispatcher 创建这个 Endpoint(这里就是HeartbeatReceiver) 对应的 Inbox 和 EndpointRef ,然后在 Inbox 监听是否有新消息,有新消息则处理它。注册完会返回一个 EndpointRef (注意这里有 Refer,即是客户端,用来发送消息的)。
所以这一句
_heartbeatReceiver = env.rpcEnv.setupEndpoint(HeartbeatReceiver.ENDPOINT_NAME, new HeartbeatReceiver(this))
就已经完成了心跳服务端监听的功能。
那么这条代码的作用呢?
_heartbeatReceiver.ask[Boolean](TaskSchedulerIsSet)
这里我们要看上面那句 val (sched, ts) = SparkContext.createTaskScheduler(this, master, deployMode) ,它会根据 master url 创建 SchedulerBackend 和 TaskScheduler。这两个类都是和资源调度有关的,所以需要借助心跳机制来传送消息。其中 TaskScheduler 负责任务调度资源分配,SchedulerBackend 负责与 Master、Worker 通信收集 Worker 上分配给该应用使用的资源情况。
这里主要是告诉 HeartbeatReceiver(心跳) 的监听端 ,告诉它 TaskScheduler 这个东西已经设置好啦。HeartbeatReceiver 就会回应你说好的,我知道的,并持有这个 TaskScheduler。
到这里服务端 heartbeatReceiver 就差不多完了,我们可以发现,HeartbeatReceiver 除了向 RpcEnv 注册并监听消息之外,还会去持有一些资源调度相关的类 ,比如 TaskSchedulerIsSet 。
三. Spark 心跳客户端发送心跳解析
发送心跳发送在 Worker ,每个 Worker 都会有一个 Executor ,所以我们可以发现在 Executor 中发送心跳的代码。
private[spark] class Executor(
    executorId: String,
    executorHostname: String,
    env: SparkEnv,
    userClassPath: Seq[URL] = Nil,
    isLocal: Boolean = false)
  extends Logging {
  ......
  // must be initialized before running startDriverHeartbeat()
  //创建心跳的 EndpointRef
  private val heartbeatReceiverRef = RpcUtils.makeDriverRef(HeartbeatReceiver.ENDPOINT_NAME, conf, env.rpcEnv)
  ......
  startDriverHeartbeater()
  ......
    /**
   * Schedules a task to report heartbeat and partial metrics for active tasks to driver.
   * 用一个 task 来报告活跃任务的信息以及发送心跳。
   */
  private def startDriverHeartbeater(): Unit = {
    val intervalMs = conf.getTimeAsMs("spark.executor.heartbeatInterval", "10s")

    // Wait a random interval so the heartbeats don't end up in sync
    val initialDelay = intervalMs + (math.random * intervalMs).asInstanceOf[Int]

    val heartbeatTask = new Runnable() {
      override def run(): Unit = Utils.logUncaughtExceptions(reportHeartBeat())
    }
	//heartbeater是一个单线程线程池,scheduleAtFixedRate 是定时执行任务用的,和 schedule 类似,只是一些策略不同。
    heartbeater.scheduleAtFixedRate(heartbeatTask, initialDelay, intervalMs, TimeUnit.MILLISECONDS)
  }
  ......
}
可以看到,在 Executor 中会创建心跳的 EndpointRef ,变量名为 heartbeatReceiverRef 。
然后我们主要看 startDriverHeartbeater() 这个方法,它是关键。
我们可以看到最后部分代码
    val heartbeatTask = new Runnable() {
      override def run(): Unit = Utils.logUncaughtExceptions(reportHeartBeat())
    }
	heartbeater.scheduleAtFixedRate(heartbeatTask, initialDelay, intervalMs, TimeUnit.MILLISECONDS)
heartbeatTask 是一个 Runaable,即一个线程任务。scheduleAtFixedRate 则是 java concurrent 包中用来执行定时任务的一个类,这里的意思是每隔 10s 跑一次 heartbeatTask 中的线程任务,超时时间 30s 。
为什么到这里还是没看到 heartbeatReceiverRef 呢,说好的发送心跳呢?别急,其实在 heartbeatTask 线程任务中又调用了另一个方法,我们到里面去一探究竟。
private[spark] class Executor(
    executorId: String,
    executorHostname: String,
    env: SparkEnv,
    userClassPath: Seq[URL] = Nil,
    isLocal: Boolean = false)
  extends Logging {
  ......
  private def reportHeartBeat(): Unit = {
    // list of (task id, accumUpdates) to send back to the driver
    val accumUpdates = new ArrayBuffer[(Long, Seq[AccumulatorV2[_, _]])]()
    val curGCTime = computeTotalGcTime()

    for (taskRunner <- runningTasks.values().asScala) {
      if (taskRunner.task != null) {
        taskRunner.task.metrics.mergeShuffleReadMetrics()
        taskRunner.task.metrics.setJvmGCTime(curGCTime - taskRunner.startGCTime)
        accumUpdates += ((taskRunner.taskId, taskRunner.task.metrics.accumulators()))
      }
    }

    val message = Heartbeat(executorId, accumUpdates.toArray, env.blockManager.blockManagerId)
    try {
	  //终于看到 heartbeatReceiverRef 的身影了
      val response = heartbeatReceiverRef.askWithRetry[HeartbeatResponse](
          message, RpcTimeout(conf, "spark.executor.heartbeatInterval", "10s"))
      if (response.reregisterBlockManager) {
        logInfo("Told to re-register on heartbeat")
        env.blockManager.reregister()
      }
      heartbeatFailures = 0
    } catch {
      case NonFatal(e) =>
        logWarning("Issue communicating with driver in heartbeater", e)
        heartbeatFailures += 1
        if (heartbeatFailures >= HEARTBEAT_MAX_FAILURES) {
          logError(s"Exit as unable to send heartbeats to driver " +
            s"more than $HEARTBEAT_MAX_FAILURES times")
          System.exit(ExecutorExitCode.HEARTBEAT_FAILURE)
        }
    }
  }
  ......

}
可以看到,这里 heartbeatReceiverRef 和我们上一节的例子, HelloworldClient 类似,核心也是调用了 askWithRetry() 方法,这个方法是通过同步的方式发送 Rpc 消息。而这个方法里其他代码其实就是获取 task 的信息啊,或者是一些容错处理。核心就是调用 askWithRetry() 方法来发送消息。
看到这你就明白了吧。Executor 初始化便会用一个定时任务不断发送心跳,同时当有 task 的时候,会获取 task 的信息一并发送。这就是心跳的大概内容了。
OK,Spark RPC 三部曲完毕。如果你能看到这里那不容易呀,给自己点个赞吧!!
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/420/viewspace-2820257/ ,如需转载,请注明出处,否则将追究法律责任。

