爬虫类在制作过程中,经常会遇到这样的情况,刚开始爬虫时,爬虫通常都是正常的抓取数据,但是过了一会儿就会报错,比如403Forbidden,此时打开网页一看,可能会发现IP访问率太高等。造成这一现象的原因是网站采取了一些反爬虫措施。这种方法就是使用代理,代理的使用方法以后再讲,首先要理解代理的基本原理。
基本原理:
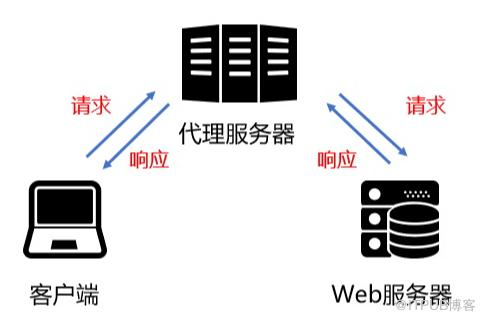
1、本机即客户端,不直接向Web服务器发送请求,而是向代理服务器发送请求。
2、由代理服务器发送到Web服务器,代理服务器再将返回服务器的响应转发给客户端。
这样就使我们能够正常访问网页,网络服务器识别的IP不再是我们的本地IP,成功地实现了IP伪装。代理实际上是指代理服务器,其作用是代理网络用户获取网络信息,这是便于我们直接理解的一张图。
代理的作用是什么?
打破自己的IP接入限制,访问一些平时无法访问的网站。
对特定单位或团体的内部资源的访问。
为提高访问速度,通常代理服务器设置较大的硬盘缓冲区,外部信息通过时,同时保存在缓冲区中,其他用户在访问相同信息时,直接从缓冲区中提取信息。
隐藏了真实IP,对于爬虫来说,使用代理就是隐藏IP,防止被封。
那么爬虫代理能达到什么?
对于爬虫动物来说,由于爬虫速度过快,爬虫时可能会遇到访问IP过多的问题,此时网站会让我们输入验证码登陆或者直接封锁IP。用代理隐藏真正的IP,让服务器误以为代理服务器需要自己,在爬虫的过程中不断更换代理,不会被封锁,从而达到我们的目的。
以上是关于爬虫代理ip的基本原理,作用和可以达到的效果,大家想使用爬虫代理ip可以尝试品易http代理,提供高匿稳定代理ip,支持HTTP/HTTPS/SOCKS5代理协议,提供动态IP、静态IP等服务。百兆带宽,千万ip资源,保证爬虫数据传输安全性。方便快捷获取网站数据,现在还有免费测试活动!
(推荐操作系统:windows7系统、Internet Explorer 11,DELL G3电脑。)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/3702/viewspace-2828686/ ,如需转载,请注明出处,否则将追究法律责任。

