原文见点击打开链接
“Cyclical Learning Rates for Training Neural Networks”中的3.3节描述了一个非常棒的方法来找初始学习率,同时推荐大家去看看这篇论文,有一些非常启发性的学习率设置想法。
这个方法在论文中是用来估计网络允许的最小学习率和最大学习率,我们也可以用来找我们的最优初始学习率,方法非常简单。首先我们设置一个非常小的初始学习率,比如1e-5,然后在每个batch之后都更新网络,同时增加学习率,统计每个batch计算出的loss。最后我们可以描绘出学习的变化曲线和loss的变化曲线,从中就能够发现最好的学习率。
下面就是随着迭代次数的增加,学习率不断增加的曲线,以及不同的学习率对应的loss的曲线。
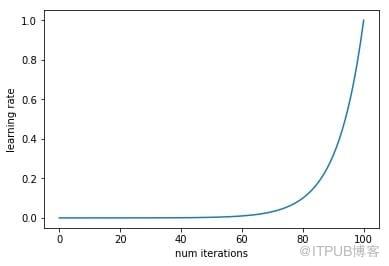
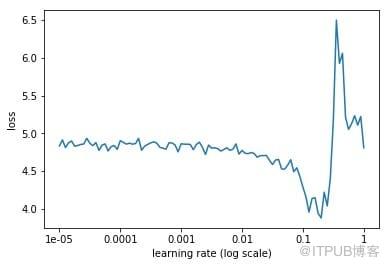
从上面的图片可以看到,随着学习率由小不断变大的过程,网络的loss也会从一个相对大的位置变到一个较小的位置,同时又会增大,这也就对应于我们说的学习率太小,loss下降太慢,学习率太大,loss有可能反而增大的情况。从上面的图中我们就能够找到一个相对合理的初始学习率,0.1。
之所以上面的方法可以work,因为小的学习率对参数更新的影响相对于大的学习率来讲是非常小的,比如第一次迭代的时候学习率是1e-5,参数进行了更新,然后进入第二次迭代,学习率变成了5e-5,参数又进行了更新,那么这一次参数的更新可以看作是在最原始的参数上进行的,而之后的学习率更大,参数的更新幅度相对于前面来讲会更大,所以都可以看作是在原始的参数上进行更新的。正是因为这个原因,学习率设置要从小变到大,而如果学习率设置反过来,从大变到小,那么loss曲线就完全没有意义了。
mxtorch,借鉴了gluon的一些优点,在定义层的时候暴露初始化方法,支持tensorboard,同时增加了大量的model zoo,包括inceptionresnetv2,resnext等等,提供预训练权重。
下面就是部分代码,这里使用的数据集是kaggle上的dog breed,使用预训练的resnet50,ScheduledOptim的源码如下:
class ScheduledOptim(object):
    '''A wrapper class for learning rate scheduling'''

    def __init__(self, optimizer):
        self.optimizer = optimizer
        self.lr = self.optimizer.param_groups[0]['lr']
        self.current_steps = 0

    def step(self):
        "Step by the inner optimizer"
        self.current_steps += 1
        self.optimizer.step()

    def zero_grad(self):
        "Zero out the gradients by the inner optimizer"
        self.optimizer.zero_grad()

    def set_learning_rate(self, lr):
        self.lr = lr
        for param_group in self.optimizer.param_groups:
            param_group['lr'] = lr

    @property
    def learning_rate(self):
        return self.lr


def find_lr():
    pass


def train_model():
    pass
整体代码如下
criterion = torch.nn.CrossEntropyLoss()
net = model_zoo.resnet50(pretrained=True)
net.fc = nn.Linear(2048, 120)
with torch.cuda.device(0):
net = net.cuda()
basic_optim = torch.optim.SGD(net.parameters(), lr=1e-5)
optimizer = ScheduledOptim(basic_optim)
lr_mult = (1 / 1e-5) ** (1 / 100)
lr = []
losses = []
best_loss = 1e9
for data, label in train_data:
with torch.cuda.device(0):
data = Variable(data.cuda())
label = Variable(label.cuda())
# forward
out = net(data)
loss = criterion(out, label)
# backward
optimizer.zero_grad()
loss.backward()
optimizer.step()
lr.append(optimizer.learning_rate)
losses.append(loss.data[0])
optimizer.set_learning_rate(optimizer.learning_rate * lr_mult)
if loss.data[0]
best_loss = loss.data[0]
if loss.data[0] > 4 * best_loss or optimizer.learning_rate > 1.:
break
plt.figure()
plt.xticks(np.log([1e-5, 1e-4, 1e-3, 1e-2, 1e-1, 1]), (1e-5, 1e-4, 1e-3, 1e-2, 1e-1, 1))
plt.xlabel('learning rate')
plt.ylabel('loss')
plt.plot(np.log(lr), losses)
plt.show()
plt.figure()
plt.xlabel('num iterations')
plt.ylabel('learning rate')
plt.plot(lr)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/3199/viewspace-2801967/ ,如需转载,请注明出处,否则将追究法律责任。

