全文检索Solr集成HanLP中文分词
以前发布过HanLP的Lucene插件,后来很多人跟我说其实Solr更流行(反正我是觉得既然Solr是Lucene的子项目,那么稍微改改配置就能支持Solr),于是就抽空做了个Solr插件出来,开源在Github上,欢迎改进。HanLP中文分词solr插件支持Solr5.x,兼容Lucene5.x。
快速上手
-
将hanlp-portable.jar和hanlp-solr-plugin.jar共两个jar放入${webapp}/WEB-INF/lib下
-
修改solr core的配置文件${core}/conf/schema.xml:
-
<fieldType name = "text_cn" class = "solr.TextField" >
-
<analyzer type = "index" >
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "true" />
-
</analyzer>
-
<analyzer type = "query" >
-
<!-- 切记不要在query中开启index模式 -->
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "false" />
-
</analyzer>
-
</fieldType>
-
<!-- 业务系统中需要分词的字段都需要指定type为text_cn -->
-
<field name = "my_field1" type = "text_cn" indexed = "true" stored = "true" />
-
<field name = "my_field2" type = "text_cn" indexed = "true" stored = "true" />
Solr5中文分词器详细配置
对于新手来说,上面的两步可能太简略了,不如看看下面的step by step。本教程使用Solr5.2.1,理论上兼容solr5.x。
放置jar
将上述两个jar放到solr-5.2.1/server/solr-webapp/webapp/WEB-INF/lib目录下。
启动solr
首先在solr-5.2.1bin目录下启动solr:
-
solr start - f
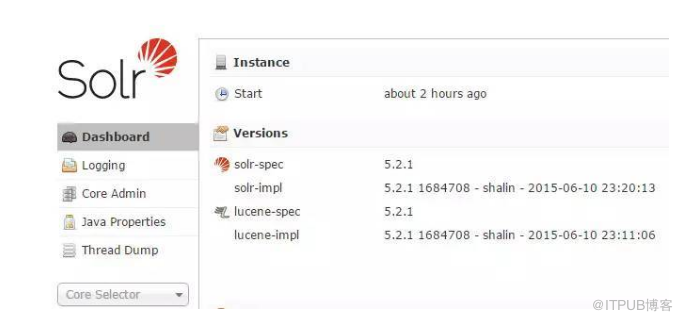
用浏览器打开http://localhost:8983/solr/#/,看到如下页面说明一切正常:
创建core
在solr-5.2.1serversolr下新建一个目录,取个名字比如叫one,将示例配置文件solr-5.2.1serversolrconfigsetssample_techproducts_configsconf拷贝过来,接着修改schema.xml中的默认域type,搜索
-
<fieldType name = "text_general" class = "solr.TextField" positionIncrementGap = "100" >
-
...
-
</fieldType>
替换为
-
<!-- 默认文本类型: 指定使用HanLP分词器,同时开启索引模式。
-
通过solr自带的停用词过滤器,使用"stopwords.txt"(默认空白)过滤。
-
在搜索的时候,还支持solr自带的同义词词典。-->
-
<fieldType name = "text_general" class = "solr.TextField" positionIncrementGap = "100" >
-
<analyzer type = "index" >
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "true" />
-
<filter class = "solr.StopFilterFactory" ignoreCase = "true" words = "stopwords.txt" />
-
<!-- 取消注释可以启用索引期间的同义词词典
-
<filter class="solr.SynonymFilterFactory" synonyms="index_synonyms.txt" ignoreCase="true" expand="false"/>
-
-->
-
<filter class = "solr.LowerCaseFilterFactory" />
-
</analyzer>
-
<analyzer type = "query" >
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "true" />
-
<filter class = "solr.StopFilterFactory" ignoreCase = "true" words = "stopwords.txt" />
-
<filter class = "solr.SynonymFilterFactory" synonyms = "synonyms.txt" ignoreCase = "true" expand = "true" />
-
<filter class = "solr.LowerCaseFilterFactory" />
-
</analyzer>
-
</fieldType>
意思是默认文本字段类型启用HanLP分词器,text_general还开启了solr默认的各种filter。
solr允许为不同的字段指定不同的分词器,由于绝大部分字段都是text_general类型的,可以说这种做法比较适合新手。如果你是solr老手的话,你可能会更喜欢单独为不同的字段指定不同的分词器及其他配置。 如果你的业务系统中有其他字段,比如location,summary之类,也需要一一指定其type="text_general"。切记,否则这些字段仍旧是solr默认分词器,会造成这些字段“搜索不到”。
另外, 切记不要在query中开启indexMode ,否则会影响PhaseQuery。 indexMode只需在index中开启一遍即可,要不然它怎么叫 indexMode呢。
如果你不需要solr提供的停用词、同义词等filter,如下配置可能更适合你:
-
<fieldType name = "text_cn" class = "solr.TextField" >
-
<analyzer type = "index" >
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "true" />
-
</analyzer>
-
<analyzer type = "query" >
-
<!-- 切记不要在query中开启index模式 -->
-
<tokenizer class = "com.hankcs.lucene.HanLPTokenizerFactory" enableIndexMode = "false" />
-
</analyzer>
-
</fieldType>
-
<!-- 业务系统中需要分词的字段都需要指定type为text_cn -->
-
<field name = "my_field1" type = "text_cn" indexed = "true" stored = "true" />
-
<field name = "my_field2" type = "text_cn" indexed = "true" stored = "true" />
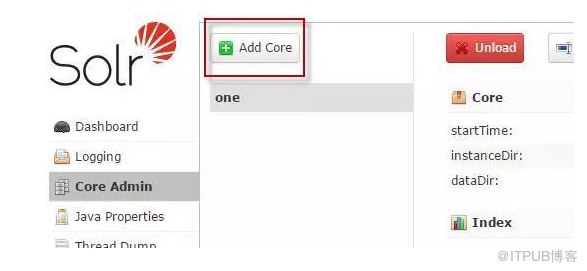
完成了之后在solr的管理界面导入这个core one:
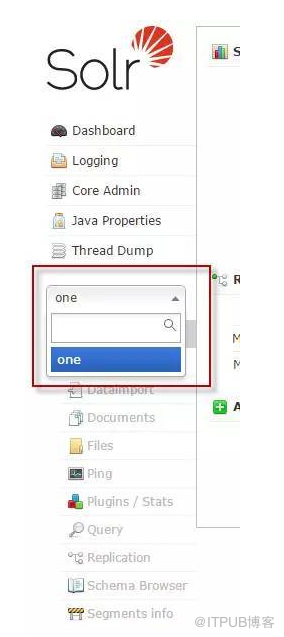
接着就能在下拉列表中看到这个core了:
上传测试文档
修改好了,就可以拿一些测试文档来试试效果了。 hanlp-solr-plugin代码库中的src/test/resources下有个测试文档集合documents.csv,其内容如下:
代表着id从1到5共五个文档,接下来复制solr-5.2.1exampleexampledocs下的上传工具post.jar到resources目录,利用如下命令行将数据导入:
Windows用户的话直接双击该目录下的upload.cmd即可,Linux用户运行upload.sh。
正常情况下输出如下结果:
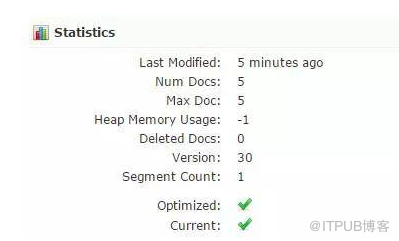
同时刷新一下core one的Overview,的确看到了5篇文档:
搜索文档
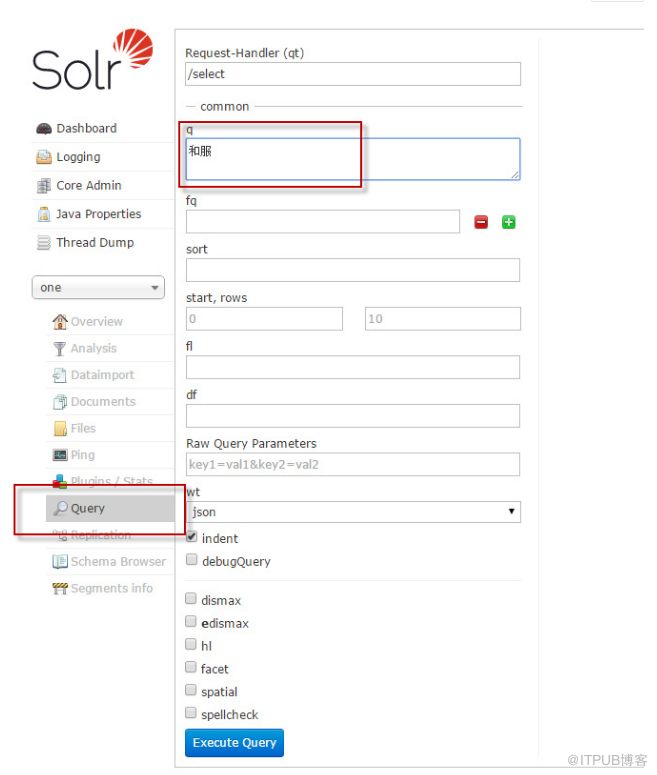
是时候看看HanLP分词的效果了,点击左侧面板的Query,输入“和服”试试:
发现精确地查到了“
和服
的价格是每镑15便士
”,而不是“商品
和服
务”这种错误文档:
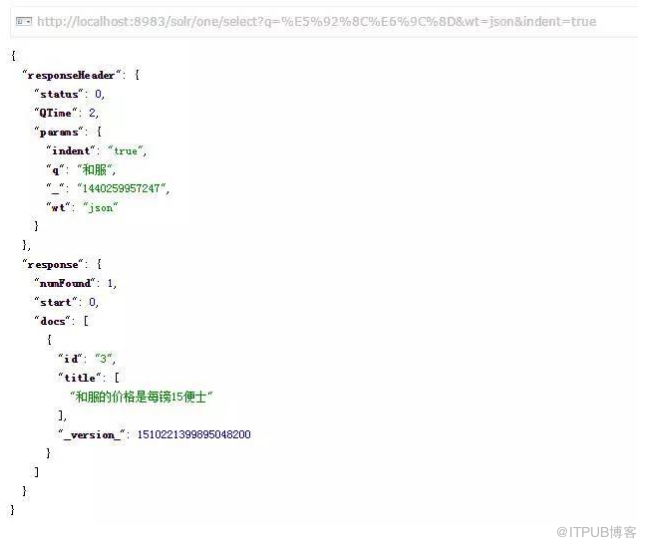
这说明HanLP工作良好。
要知道,不少中文分词器眉毛胡子一把抓地命中“商品 和服 务”这种错误文档,降低了查准率,拉低了用户体验,跟原始的MySQL LIKE有何区别?
索引模式的功能
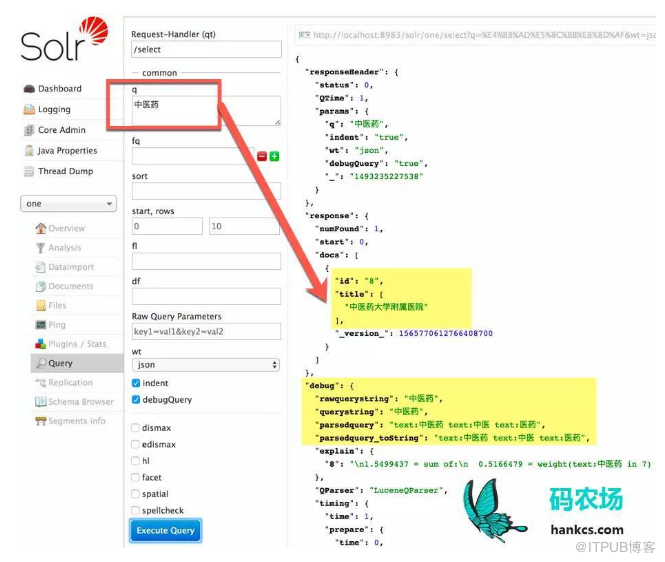
索引模式可以对长词进行全切分,得到其中蕴含的所有词汇。比如“中医药大学附属医院”在HanLP索引分词模式下的切分结果为:
开启indexMode后,无论用户搜索“中医”“中医药”还是“医药”,都会搜索到“中医药大学附属医院”:
高级配置
目前本插件支持如下基于schema.xml的配置:
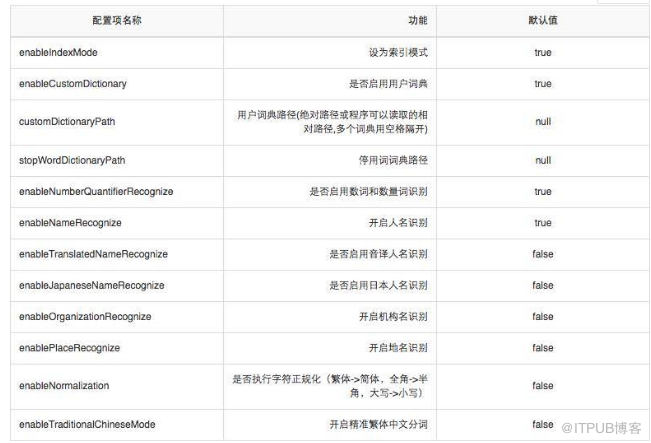
对于更高级的配置,HanLP分词器主要通过class path下的hanlp.properties进行配置,请阅读HanLP自然语言处理包文档以了解更多相关配置,如:
-
停用词
-
用户词典
-
词性标注
-
……
代码调用
在Query改写的时候,可以利用HanLPAnalyzer分词结果中的词性等属性,如
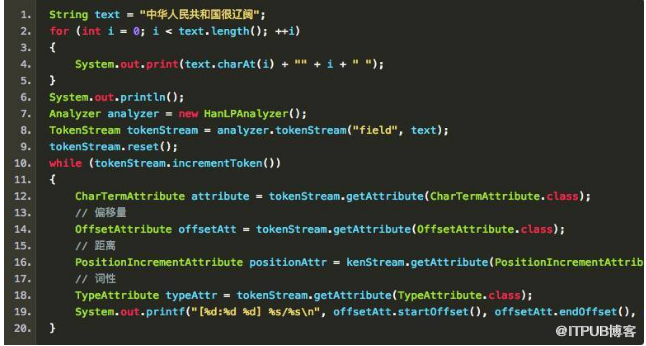
在另一些场景,支持以自定义的分词器(比如开启了命名实体识别的分词器、繁体中文分词器、 CRF分词器等)构造HanLPTokenizer,比如:
1. tokenizer = new HanLPTokenizer(HanLP.newSegment()
2. .enableJapaneseNameRecognize(true)
3. .enableIndexMode(true), null, false);
4. tokenizer.setReader(new StringReader("林志玲亮相网友:确定不是波多野结衣?"));
5. ...
文章来源于网络
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31557723/viewspace-2217830/ ,如需转载,请注明出处,否则将追究法律责任。

