背景
一般大公司的机器学习团队,才会尝试构建大规模机器学习模型,如果去看百度、头条、阿里等分享,都有提到过这类模型。当然,大家现在都在说深度学习,但在推荐、搜索的场景,据我所知, ROI 并没有很高,大家还是参考 wide&deep 的套路做,其中的 deep 并不是很 deep 。而大规模模型,是非常通用的一套框架,这套模型的优点是一种非常容易加特征,所以本质是拼特征的质和量,比如百度、头条号称特征到千亿规模。可能有些朋友不太了解大规模特征是怎么来的,举个简单的例子,假设你有百万的商品,然后你有几百个用户侧的 profile ,二者做个交叉特征,很容易规模就过 10 亿。特征规模大了之后,需要 PS 才能训练,这块非常感谢腾讯开源了 Angel ,拯救了我们这种没有足够资源的小公司,我们的实践效果非常好。
网上有非常多介绍大规模机器学习的资料,大部分的内容都集中在为何要做大规模机器学习模型以及 Parameter Server 相关的资料,但我们在实际实践中,发现大规模的特征预处理也有很多问题需要解决。有一次和明风(以前在阿里,后来去了腾讯做了开源的 PS : angel )交流过这部分的工作为何没有人开源,结论大致是这部分的工作和业务相关性大,且讲明白了技术亮点不多,属于苦力活,所以没有开源的动力。
本文总结了蘑菇街搜索推荐在实践大规模机器学习模型中的特征处理系统的困难点。我们的技术选型是 spark ,虽然 spark 的机器学习部分不能支持大规模(我们的经验是 LR 模型的特征大概能到 3000w 的规模),但是它非常适合做特征处理。非常感谢组里的小伙伴 @ 玄德 贡献此文。
整体流程图
这套方法论的特点是,虽然特征规模很大,但是非常稀疏。我们对特征集合进行 onehot 编码,每条样本的存储需求很小。由于规模太大,编码就变成一个比较严峻的问题。
连续统计类特征:电商领域里面,统计的 ctr 、 gmv 是非常重要的特征。
特征构建遇到的问题
1. 特征值替换成对应的数值索引过慢
组合后的训练样例中的特征值需要替换成对应的数值索引,生成 onehot 的特征格式。
特征索引映射表 1 的格式如下 :
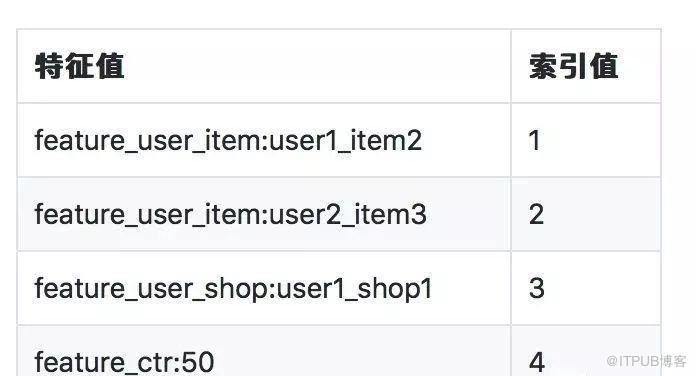
为了实现这种计算,我们需要对所有的特征做 unique 编码,然后将这个索引表 join 回原始的日志表,替换原始特征,后续流程使用编码的值做 onehot ,但这部分容易 OOM ,且性能有问题。于是我们着手优化这个过程 .
首先我们想到的点是将索引表广播出去 , 这样就不用走 merge join, 不用对样例表进行 shuffle 操作 , 索引表在比较小的时候 , 大概是 4KW 的规模 , 广播出去是没有问题的 , 实际内部实现走的是 map-side join, 所以速度也是非常快的 , 时间减少到一个小时内 .
当索引表规模达到 5KW 的时候 , 直接整表广播 , driver 端 gc 就非常严重了 , executor 也非常不稳定 , 当时比较费解 , 单独把这部分数据加载到内存里面 , 占用量只有大约 executor 内存的 20% 左右 , 为啥 gc 会这么严重呢 ? 后面去看了下 saprk 的原理 , 解决了心中的疑惑 . 因为 spark2.x 已经移除 HTTPBroadcast, 仅有的一种实现是 TorrentBroadcast. 实现原理类似于大家常用的 BT 下载技术。基本思想就是将数据分块成 data blocks ,如果 executor 取到了一些 data blocks ,那么这个 executor 就可以被当作 data server 了,随着取到数据的 executor 越来越多,有更多的 data server 加入,数据就很快能传播到全部的 executor 那里去了 .
在广播的过程中会将数据冗余一份到 blockManager, 供其他 executor 进行读取 . 其原理如图所示 :
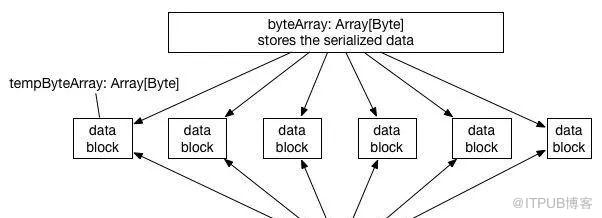
在广播的过程中 , driver 端和 executor 端都会有短暂的时间达到 2 倍的内存占用 。
dirver
端
driver
端先把数据序列成
byteArray,
切割成小块的
data block
再广播出去
,
切割的过程
,
内存会不断接近
2
倍
byteArray
的大小
,
直到切割完之后
,
将
byteArray
释放掉
.
executor
端
executor
装载广播的数据是
driver
的反过程
,
每次拿到一个
data block
之后
,
就将其存放到
blockManager,
同时通知
driver
的
blockManagerMaster
说这个
block
多了一个存储的地方
,
供其他
executor
下载
.
等
executor
把所有的
block
都从其他地方拿全之后
,
先申请一个
Array[Byte],
将
block
的数据进行反序列化之后得到原始数据
.
这个过程中和
driver
端应用
,
内存会不断接近
2
倍数据的大小
,
直到反序列化完成
.
通过了解了 spark 广播的实现 , 可以解释广播 5kw 维特征的 gc 严重的问题 .
随着实验特征的迭代 , 表 2 的列数会不断的增多 , 处理时间会随着列数的增多而线性增加 , 特征索引的规模增多 , 会导致广播的过程中 gc 问题越来越严重 , 直到 OOM 频繁出现 .
这个阶段需要解决 2 个问题
1. 需要高效得将表 1 的数据广播到各个 executor
2. 不能使用 join 列的方式来实现替换索引值
综合这两个问题 , 我们想出了一个解决方案 , 将表 1 先按照特征值排好序 , 然后再重新编码 , 用一个长度为 max( 索引值 ) 长度的数组去存储 , 索引值作为下标 , 对应的元素为特征值 , 将其广播到 executor 之后 , 遍历日志的每一行的每一列 , 实际上就是对应的特征值 , 去上面的数组中二分查找出对应的索引值并替换掉 .
使用下标数据存储表 1, 特征值按照平均长度 64 个字符计算 , 每个字符占用 1 个字节 , 5 千万维特征需要 3.2G 内存 , 广播的实际表现 ok , 1 亿维特征的话需要占用 6.4G 内存 , 按照广播的时候会有双倍内存占用的情况 ,gc 会比较严重 . 我们又想了一个办法 , 将字符串 hash 成 long,long 仅占用 8 字节 , 比起存储字符串来说大大节省了空间 , hash 的有个问题是可能会冲突 , 由于 8 字节的 hash 映射空间有 -2^63 到 2^63-1, 我们使用的是 BKDRHash, 实际测下来冲突率很少 , 在业务可接受的范围 , 这个方法可以大大节省占用的内存 ,1 亿特征仅占用 800M 的内存 , 广播起来毫无压力 , 对应的在遍历表 2 的时候 , 需要先将特征值用同样的算法 hash 之后再进行查找 . 经过这一轮优化之后 , 相同资源的情况下 , 处理 10 亿行 , 5KW 维特征的时候 , 耗时已经降低到半个小时了 , 且内存情况相对稳定 .
这种情况跑了一段时间之后 , 特征规模上到亿了 , 发现这一步的耗时已经上升到 45 分钟了 , 分析了下特征的分布 , 发现连续特征离散化的特征在日志出现的频率很高 , 由于是连续统计值,本身非常稠密,基本每一条数据都有其出现,但是这类特征在表 1 的分布不多 , 这完全可以利用缓存把这类特征对应的索引值保存下来 , 而没必要走 hash 之后再二分搜索 , 完全可以用少量的空间节省大量的时间 . 实际实现的时候 , 判断需要查找的特征值是否符合以上的这种情况 , 如果符合的话 , 直接用 guava 缓存表 2 的特征值 -> 表 1 的索引值 , 实际统计的缓存命中率是 99.98888%, 实际耗时下降得也很明显 , 从之前的 45 分钟降到 17 分钟 . 当然缓存并不是银弹 , 在算 hash 的时候误用了缓存 , 导致这一步的计算反而变得慢了 , 因为 hash 的组合实在是太多了 , 缓存命中率只有 10% 左右 , 而且 hash 计算复杂度并不高 . 在实际使用缓存的时候 , 有必要去统计一下缓存的命中率 .
2. Spark 的一些经验
1. 利用好 spark UI 的 SQL 预览 , 做类似特征处理的 ETL 任务多关注下 SQL, 做这类特征处理的工作的时候 , 这个功能绝对是一把利器 , 前期实现时间比较赶 , 测试用例比较少 , 在查实际运行逻辑错误的问题时 , 可以利用前期对数据的分析结论结合 SQL 选项的流程图来定位数据出错的位置 .
2. 利用 spark UI 找出倾斜的任务 , 找到耗时比较长的 Stages, 点进去看 Aggregated Metrics by Executor
3. 对单个 task 可以不用太关注 , 如果某些 Executor 的耗时比起其他明显多了 , 一般都是数据清洗导致的 ( 不排除某些慢节点 )
4. 利用 UI 确认是否需要缓存 , 如果一个任务重复步骤非常频繁的 , 且任务的数据本地性都是 RACK_LOCAL 的 则要考虑将其上游结果缓存下来 . 比如我们这里会统计单列特征的频次的时候
5. 会将上游数据缓存下来 , 但是数据量相对比较大 , 我们选择将其缓存到磁盘, spark 实现的自动分配内存和磁盘的方法有点问题,不知道是我们的姿势问题还是他的实现有 bug 。
生产版本小结
亿级别特征维度,几十亿样本(对全样本做了采样,效果损失不明显),二十分钟左右跑完。不过这个时间数据参考意义不大,和跑的资源和机器性能有关,而大厂在这块优势太大了。而本文核心解决的点是特征处理过程中,特征编码的索引达到亿级别时,数据处理性能差或者 spark OOM 的问题。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31555587/viewspace-2220375/ ,如需转载,请注明出处,否则将追究法律责任。

