它是一个高性能的 Key-Value 数据库。设计了完善的持久化机制,同时保证性能和安全性。能够良好的支持范围查询,因为 K-V 记录就是按照 Key 来排序的。
下图为写入的流程:
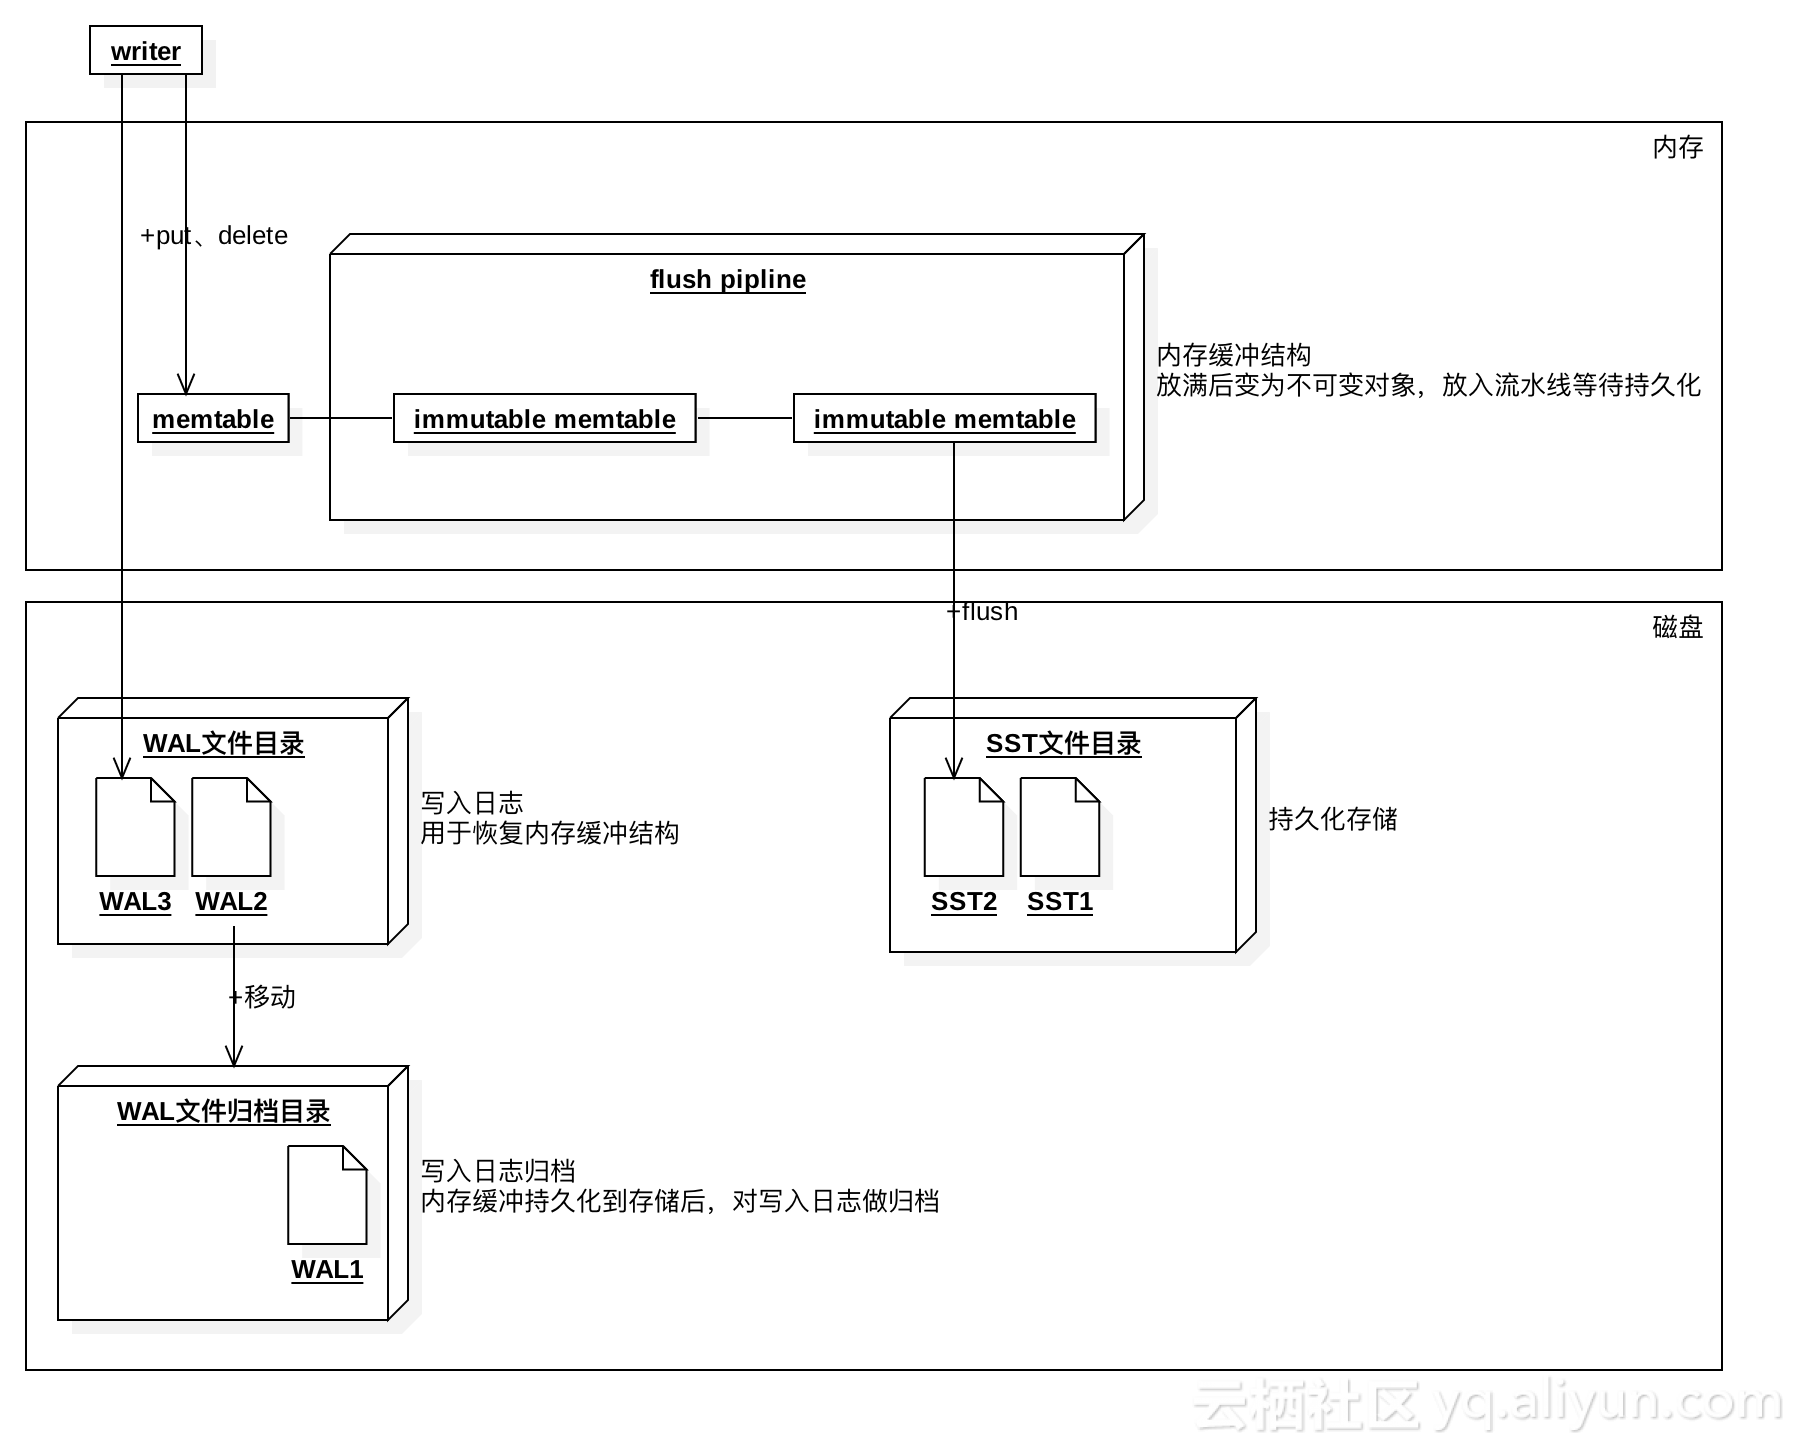
可以看到主要的三个组成部分,内存结构 memtable ,类似事务日志角色的 WAL 文件,持久化的 SST 文件。
数据会放到内存结构 memtable ,一定条件下触发写到到 SST 文件。写入 WAL 文件是可选的,用来恢复未写入到磁盘的 memtable 。
下图展示了读取的层次:

memtable 和 SST 文件组成数据的全集。之上是缓存层,缓存为提升查询性能做了分片,底层都采用 hash 查询,不同缓存结构的区别在于热点数据的替换逻辑。访问数据库时,都是访问的打开时间点的 view (我猜测一个 key 有不同时间戳的多条记录)。除了直接查询 db ,还提供了查询快照的机制。直接访问 db 时,会持有文件句柄,这样多个 SST 文件合并时,已经被合并但被访问的文件就不能被删除。而快照机制保证了访问过程中文件能被删除(我并未想明白如何做到的),不过打开期间被删除的 key 的记录还会在新合并的文件里存在。
memtable 的结构有几种可选,本质都是排序的结构(为了支持范围查询)

其中之一是上图的跳跃表,不了解跳跃表机制的读者可以简单理解为有序支持近似二分查找的时间复杂度为 log2 ( N )的结构

另外一种是 hash 结合跳跃表,是按照 key 的前缀做 hash ,单独访问一个 key 时性能更好,范围查询性能会差些
WAL 文件结构如下图,按照写入的顺序来存储变长的 K-V ,按照固定长度来分组存储(可能一个 K-V 跨多个分组)的目的是便于读取

支持几种 SST 文件结构

上图为按照多块来存储的结构。每块的 K-V 都是有序的,而多块也是有序的。文件中包含元数据相关的信息,包括数据压缩字典、过滤器等。会按照数据块所属的 K-V 范围来创建索引,为提升查询性能会给索引分片。

另外一种结构是每个 K-V 来存储。它的索引比较特殊,由 hash 结构和二进制查找缓存两部分组成。依然按照 key 的前缀做 hash ,如果桶对应的 K-V 记录很少,则直接指向第一个 key (有多个 key 属于该桶)的记录位置。如果属于桶的 K-V 记录多于 16 条,或者包含多于一个前缀的记录,则先指向二进制查找缓存(先二分查找),而后指向第一个 key 的记录位置。
随着 K-V 的写入,会生成很多的 SST 文件,这部分文件需要被合并到一起。从而降低打开文件数量,并且移除已经不存在的记录。通常可以配置两种方式,通用合并(下图左侧)与 level 合并(右侧)。

其中一个概念是 level ,可以简单理解成越老的数据在越高的 level (也就是数据最初写入到最低的 level , level0 就是 memtable )。
我将通用合并简单理解为一种简单粗暴的合并,可以尽量降低写磁盘的压力,会增大读取的压力,临时空间占用大。
一般多采用 level 合并的方式。每个 level 都有 max 大小,超出后会触发本 level 与下一 level 的文件合并到一起。不同 level 的合并是可以并发执行的。
对 rocksdb 做个总结。所有记录在业务上是有序的,对 key 的查询其实会执行类似二分查找。持久化是通过写入有序文件来实现的。高性能的写入是通过先写入内存结构来保证的(写满的内存结构刷到持久化文件)。提供了 level 机制对数据做分层,优先查询最新写入的 level 来优化查询性能。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31551794/viewspace-2220137/ ,如需转载,请注明出处,否则将追究法律责任。

