无监控,不运维!Prometheus 在线服务的监控实操指南
本文会介绍我近期使用Prometheus构建的一套完整的,可用于中小规模(小于500节点)的半自动化(少量人工操作)监控系统方案。
主动监控
监控手段一般可以分为三种:
主动监控:业务上线前,按照运维制定的标准,预先埋点。具体的实现方式又有多种,可能通过日志、向本地 Agent 上报、提供 REST API 等。
被动监控:通常是对主动监控的补充,从外围进行黑盒监控,通过主动探测服务的功能可用性来进行监控。比如定期ping业务端口。
旁路监控:主动监控和被动监控,通常还是都在内部进行的监控,内部运行平稳也不能保证用户的体验都是正常的(比如用户网络出问题),所以仍然需要通过舆情监控、第三方监控工具等的数据来间接的监控真实的服务质量。
Prometheus
为什么选择Prometheus而不是其它TSDB实现(如InfluxDB)?主要是因为Prometheus的核心功能,查询语言 PromQL,它更像一种可编程计算器,而不是其那么像 SQL,也意味着 PromQL 可以近乎无限之组合出各种查询结果。
http_requests_total 用于统计请求次数。某一组监控数据可能是这个样子:
http_requests_total{instance="1.1.1.1:80",job="cluster1",location="/a"} 100http_requests_total{instance="1.1.1.1:80", job="cluster1", location="/b"} 110http_requests_total{instance="1.1.1.2:80", job="cluster2", location="/b"} 100http_requests_total{instance="1.1.1.3:80", job="cluster3", location="/c"} 110
这里有3个标签,分别对应抓取的实例,所属的 Job(一般我用集群名),访问路径(你可以理解为Nginx的location),Prometheus多维数据模型意味着我们可以在任意一个或多个维度进行计算:
如果你想统计单机qps,sum(rate(http_requests_total[1m])) by (instance) 如果想用统计每个集群每个不同 location 的 path 的 qps, sum(rate(http_requests_total[1m])) by (job, path),PromQL会依据标签job-path的值聚合出结果。
Counter(计数器):标识单调递增的数据,比如接口访问次数。 Gauge(刻度):当前瞬时的一个状态,可能增加,也可能减小,比如CPU使用率,平均延时等等。 Historgram(直方图):用于统计数据的分布,比如95 percentile latency。
大部分监控项都可以使用Counter来实现,少部分使用Gauge和Histogram,其中Histogram在服务端计算是相当费CPU的,所以也没要导出太多Histogram数据。
最后,Prometheus采用PULL模型的实时抓取存储计算,主动去抓取监控实例数据,相比于PUSH模型对业务侵入更低,相比于基于log的离线统计则更实时,而监控实例只需提供一个文本格式的/metrics接口也更容易debug。
服务框架的改造
类似于 Nginx 的多进程架构(master/worker),但同时也支持多线程的事件循环编程模型 支持多种接入协议(HTTP,Thrift,PB等),但主流是HTTP 业务通过 Module 来加载进框架执行(类似 Nginx 的 module,但更简单) 提供纯异步的下游访问 API
提供基础数据类型
目前并没有官方的Prometheus Client Library,几种开源实现也都不太符合框架的需求。目前实现了支持多线程多进程的Counter和Histogram(除了初始化之外,更新操作都是无锁的),而Gauge由于多进程场景有的情况是无法聚合监控数据的(没用统一的聚合方法,并不一定都可以相加),所以没有提供具体实现
基础数据要有类似注册表的功能,方便自动导出数据到/metrics接口
在服务框架埋点
-
要足够灵活,将容易变化的信息通过标签来表达。
比如一个web服务可能有echo,date两个location,如果要统计它们qps,不要定义
echo_requests_total,date_requests_total两个不同名字的 metrics,而应该定义一个名为http_requests_total的 metrics,通过标签location(分别为echo/date)来区分,这样再增加/减少接口是不需要改代码的 理想情况是业务几乎为各种通信功能自行埋点,所以内置埋点要将常用监控项都要覆盖到(QPS,Latency,Error Ratio)
数据的抓取与展现
要控制导出数据规模,一些只对单机监控有意义的数据可以不导出(框架有针对单机的监控页面)
Prometheus号称支持 reload,但目测不是很好用,比如你修改了告警规则文件,重载之后,新旧告警规则似乎会一起计算执行….
Prometheus本身也提供图形界面,但是很简陋:
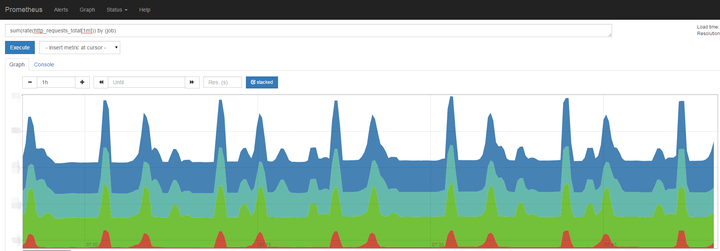
通常还是使用Grafana来展示监控数据。
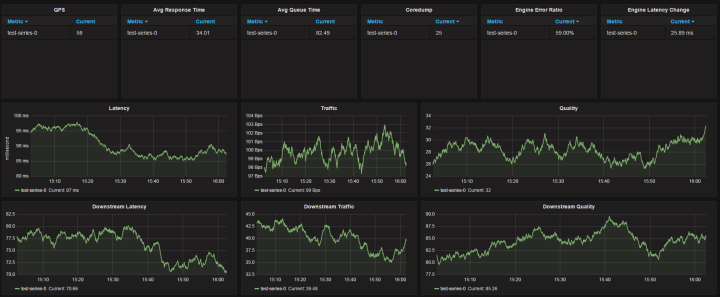
我没有找到将默认模板打包进 Grafana 的方法,只能迂回的创建了一个新的Grafana Plugin,在启动之后,每个业务实例只需要启动下这个插件,然后配置一个默认的 Prometheus 数据源,就可以使用统一的监控 Dashboard Dashboard 分为3行 第一行展示实时的 QPS,平均延时,平均排队时间,Coredump 数量,下游引擎失败率,下游引擎延时变化 第二行展示业务的延迟(50%和95%延迟),流量,吞吐(按照不同错误码) 第三行展示下游引擎的延迟(50%和95%延迟),流量,吞吐(按照不同错误码)
topk(5, 100*sum(rate(downstream_responses{error_code!="0"}[5m])) by (job, server)/sum(rate(downstream_responses[5m])) by (job, server))AlertManager

默认情况我们配置了不到10条告警规则,要注意的是周期的选择,过长的话会产生较大延迟,太短的话一个小的流量波动都会导致大量报警出现。
Prometheus 的设计是产生报警,但报警的汇总、分发、屏蔽则在 AlertManager 服务完成。
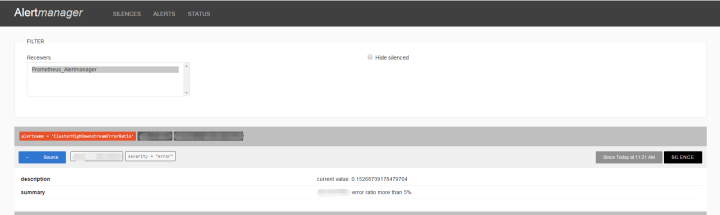
可以通过 webhook机制,发送告警到一个中间服务转换格式再发送到内部告警接口如果使用第三方告警管理平台,如PageDuty、OneAlert,可以直接用内置的 pageduty 支持或 webhook 发送告警过去 如果是一穷二白的团队,建议配置 email + slack,实现告警归档和手机 Push
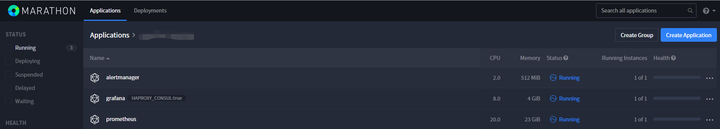
Prometheus + Grafana + Mesos
Prometheus + Grafana 的方案,加上统一的服务框架,可以满足大部分中小团队的监控需求。我们将这几个组件打包一起部署在 Mesos 之上,统一的安装包进一步降低监控系统部署的难度,用户需要配置一些简单的参数即可。但还需要注意几点:
目前并没有将 Prometheus 和 Grafana 容器化部署,因为这两者本身就没有什么特殊依赖;安装包存储在 minio 中。
由于 Prometheus 系统的特殊性,我们通常将其指定在一台固定的机器上执行,且将数据落地到一个固定的目录,这样重启 Prometheus 的影响会非常低
Grafana 是展示给用户的,需要尽可能的保持固定入口,所以我们通过
HAPROXY_CONSUL给其配置了代理
结论
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31548844/viewspace-3138180/ ,如需转载,请注明出处,否则将追究法律责任。

