概述

随着数据时代的到来,大数据平台越来越广泛地应用于各个领域中,工程师们开始借用大数据平台中的多个数据节点来实现分布式计算和分布式储存,以实现更加高效的数据分析和数据处理。但现有的大数据平台,没有综合数据节点之间的传输规律来合理控制数据节点之间的数据传输,从而使得数据传输中经常因为传输策略的失误而导致数据积压以及进一步的数据出错,现有技术存在缺陷,亟待解决。
定义
数据传输就是按照一定的规程,通过一条或者多条数据链路,将数据从数据源传输到数据终端,它的主要作用就是实现点与点之间的信息传输与交换。一个好的数据传输方式可以提高数据传输的实时性和可靠性。
数据传输部分在整个系统中处于重要的地位,相当于人体的神经给身体的各个部位传输信号,如何高效地、准确地、及时地传输采集模块采集到的数字信息是一个重要的课题。
挑战
传统集中式架构,并发量低,无法应对交易浪涌;
数据从采集、加工、应用和分析,由金融大数据服务接口向内部源数据输出,数据层层传输需要人工参与,无法及时响应;
内部源系统众多,数据容灾备份实时性、持续性难度大;
风控仅支持黑名单类的简单实时控制,复杂规则无法实时处理,多以事后处理为主;
超大数据传输需要占用大量的网络资源和存储空间,如果使用不合理或低效的工具和方案,会增加IT企业的运营成本和维护成本。
常见的解决方案
一、批量传输方案
批量传输是传输大规模数据的常用方式之一。它适用于数据量较大、传输时间相对宽松的场景。批量传输方案主要包括以下几种形式:
1.离线传输
离线传输是将数据存储在物理介质中,通过快递等方式进行传输的方法。这种方式适用于数据量较大、传输距离较远的情况。例如,将数据存储在硬盘或磁带上,通过快递进行传输。离线传输的优点是传输过程中不受网络速度限制,安全可靠,但传输时间较长。
2.FTP 传输
FTP(文件传输协议)是一种将文件从一台计算机传输到另一台计算机的标准协议。FTP传输适用于大文件传输,可以通过FTP客户端和FTP服务器进行文件上传和下载。不过,由于FTP传输过程中数据没有加密,安全性较低,因此在实际应用中需要注意数据的保护。
3.压缩打包传输
压缩打包传输是将大数据通过数据压缩和打包的方式进行传输。通过将数据进行压缩可以减小数据体积,提高传输效率。常用的压缩打包格式包括 ZIP、RAR、TAR等。这种传输方式适用于数据量较大但压缩比较高的场景。
二、实时传输方案
实时传输是一种将数据以实时方式进行传输和处理的方法。与批量传输相比,实时传输更适用于对数据实时性要求较高的场景。下面介绍几种实时传输方案:
1.消息队列传输
消息队列传输是将数据通过消息队列进行传输和处理的方式。消息队列可以实现生产者和消费者之间的解耦,生产者将数据发送到消息队列,消费者从消息队列中获取数据进行处理。常见的消息队列系统包括RabbitMQ、Kafka等。消息队列传输的优点是能够实现高吞吐量、低延迟的数据传输,适用于高并发场景。
2.流式传输
流式传输是一种将数据以流的方式进行传输和处理的方法。通过将数据分为多个流进行传输,可以提高传输效率和实时性。常用的流式传输框架包括Apache Storm、Apache Flink等。流式传输适用于对数据实时性要求较高的场景,如实时监控、实时分析等。
三、混合传输方案
混合传输方案是将批量传输和实时传输相结合的方式,根据不同的数据特点和传输需求采用不同的传输方式。混合传输方案通常结合了离线传输和实时传输的优点,既能满足大数据传输的效率要求,又能保证数据的实时性。
常见的数据传输组件
1、消息队列传输
(一)Kafka
一个Kafka集群由多个Broker和一个ZooKeeper集群组成,Broker作为Kafka节点的服务器。同一个消息主题Topic可以由多个分区Partition组成,分区物理存储在Broker上。负载均衡考虑,同一个Topic的多个分区存储在多个不同的Broker上,为了提高可靠性,每个分区在不同的Broker会存在副本。
ZooKeeper是一个分布式开源的应用程序协调服务,可以实现统一命名服务、状态同步服务、集群管理、分布式应用配置项的管理等工作。Kafka里的ZooKeeper主要有一下几个作用:
Broker注册,当有Broker故障的时候能及时感知。
Topic注册,维护Topic各分区的个副本所在的Broker节点,以及对应leader/follower的角色。
Consumer注册,维护消费者组的offset以及消费者与分区的对应关系,实现负载均衡。
(二)Pulsar
Pulsar有三个重要的组件,Broker、BookKeeper和ZooKeeper,Broker是无状态服务,客户端需要连接到Broker上进行消息的传递。BookKeeper与ZooKeeper是有状态服务。BookKeeper的节点叫Bookie,负责存储消息和游标,ZooKeeper存储Broker和Bookie的元数据。Pulsar以这种架构,实现存储和计算分离,Broker负责计算,Bookie负责有状态存储。
Pulsar的多层架构影响了存储数据的方式。Pulsar将Topic分区划分为分片(Segment),然后将这些分片存储在Apache BookKeeper的存储节点上,以提高性能、可伸缩性和可用性。Pulsar的分布式日志以分片为中心,借助扩展日志存储(通过Apache BookKeeper)实现,内置分层存储支持,因此分片可以均匀地分布在存储节点上。由于与任一给定Topic相关的数据都不会与特定存储节点进行捆绑,因此很容易替换存储节点或缩扩容。另外,集群中最小或最慢的节点也不会成为存储或带宽的短板。
(三)RocketMQ
RocketMQ是阿里开源的消息中间件,它是一个开源的分布式消息传递和流式数据平台。总共有四大部分:NameServer,Broker,Producer,Consumer。
NameServer主要用来管理brokers以及路由信息。broker服务器启动时会注册到NameServer上,并且两者之间保持心跳监测机制,以此来保证NameServer知道broker的存活状态。而且,每一台NameServer都存有全部的broker集群信息和生产者/消费者客户端的请求信息。
Broker负责管理消息存储分发,主从数据同步,为消息建立索引,提供消息查询等能力。
(四)RabbitMQ
RabbitMQ基于AMQP协议来实现,主要由Exchange和Queue两部分组成,然后通过RoutingKey关联起来,消息投递到Exchange然后通过Queue接收。
(五)NSQ
NSQ主要有nsqlookup、nsqd两部分组成:
Nsqlookup为守护进程,负责管理拓扑信息并提供发现服务。客户端通过查询nsqlookupd获取指定Topic所在的nsqd节点。nsqd往nsqlookup上注册和广播自身topic和channel的信息。
nsqd在服务端运行的守护进程,负责接收,排队,投递消息给客户端。
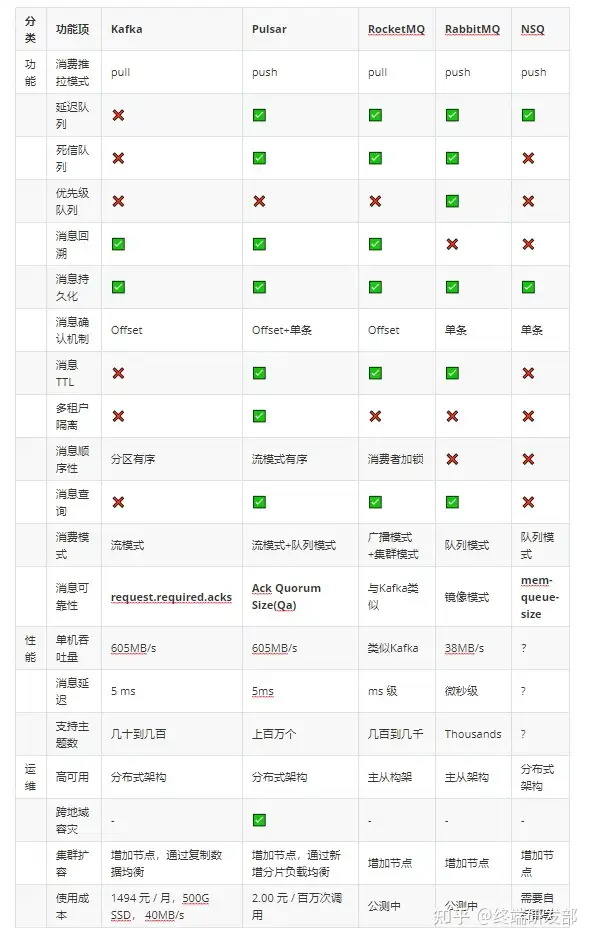
选型对比
2、基于流式传输框架进行数据传输
1)Apache Flink
Apache Flink的数据流编程模型在有限和无限数据集上提供单次事件(event-at-a-time)处理。在基础层面,Flink程序由流和转换组成。
Apache Flink的API:有界或无界数据流的数据流API、用于有界数据集的数据集API、表API。
数据流的运行流程:Flink程序在执行后被映射到流数据流,每个Flink数据流以一个或多个源(数据输入,例如消息队列或文件系统)开始,并以一个或多个接收器(数据输出,如消息队列、文件系统或数据库等)结束。Flink可以对流执行任意数量的变换,这些流可以被编排为有向无环数据流图,允许应用程序分支和合并数据流。
Flink的数据源和接收器:Flink提供现成的源和接收连接器,包括Apache Kafka、Amazon Kinesis、HDFS和Apache Cassandra等。
Flink程序可以作为集群内的分布式系统运行,也可以以独立模式或在YARN、Mesos、基于Docker的环境和其他资源管理框架下进行部署。
2)Spark Streaming
Spark Streaming是对核心Spark API的一个扩展,它能够实现对实时数据流的流式处理,并具有很好的可扩展性、高吞吐量和容错性。Spark Streaming支持从多种数据源提取数据,如:Kafka、Flume、Twitter、ZeroMQ、Kinesis以及TCP套接字,并且可以提供一些高级API来表达复杂的处理算法,如:map、reduce、join和window等。最后,Spark Streaming支持将处理完的数据推送到文件系统、数据库或者实时仪表盘中展示。实际上,你完全可以将Spark的机器学习(machine learning) 和 图计算(graph processing)的算法应用于Spark Streaming的数据流当中。
3)Apache Storm
Apache Storm是一个开源的分布式实时计算系统,用于处理大规模的实时数据流。它具有高可靠性、高吞吐量和低延迟的特点,适用于处理大量的实时数据。
输入数据速率是指进入Apache Storm系统的数据流的速度。它表示每秒钟进入系统的数据量。输入数据速率的高低直接影响到系统的处理能力和性能。
在Apache Storm中,输入数据速率的高低取决于以下几个因素:
数据源的产生速度:输入数据速率受到数据源产生数据的速度限制。如果数据源产生数据的速度很快,输入数据速率就会很高。
数据传输的带宽:输入数据速率还受到数据传输的带宽限制。如果数据传输的带宽较小,输入数据速率就会受到限制。
Apache Storm集群的处理能力:输入数据速率还受到Apache Storm集群的处理能力限制。如果集群的处理能力有限,无法及时处理进入系统的数据,输入数据速率就会受到限制。
为了应对高输入数据速率,可以采取以下策略:
增加集群规模:通过增加Apache Storm集群的节点数量,提高系统的处理能力,从而能够处理更高的输入数据速率。
使用分区和分片:将输入数据进行分区和分片,分散到不同的节点上进行处理,以提高并行处理能力,从而增加系统的处理能力。
优化数据传输:使用高带宽的网络传输数据,减少数据传输的延迟,提高输入数据速率。
数据预处理:对输入数据进行预处理,如过滤、压缩、聚合等,减少数据量,从而提高输入数据速率。
总结:
随着大数据的快速发展,各种大数据传输解决方案的出现为企业和组织提供了更多选择。根据不同的数据规模、传输时间和实时性等需求,选择合适的传输方案可以提高数据传输效率,提升数据处理能力。无论是批量传输方案、实时传输方案还是混合传输方案,都需要在实际应用中结合具体场景进行选择和优化,以满足大数据传输的需求。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31547898/viewspace-3024436/ ,如需转载,请注明出处,否则将追究法律责任。

