这篇文章是拖欠了很久很久的作业,在2022年的年终总结里就立过flag要写数据产品系列的文章:《纯文科女转战大数据的打怪升级之路》(现在回看觉得加了这么多tag:)实在是消极的心理暗示),然而一直拖欠到2024年春节才输出了第一篇。数据产品系列的第一篇文章,决定写偏技术一点的大数据平台框架。
这是大数据入门的基础,记得一年半前刚看入门知识的文章,看的头晕眼花,分不清Hadoop,HBase,Hive和一堆的组件具体的用途,每天都像在看天书。这篇文章也是参考了很多很多资料,拼拼凑凑写出来的。如有错漏,敬请斧正。
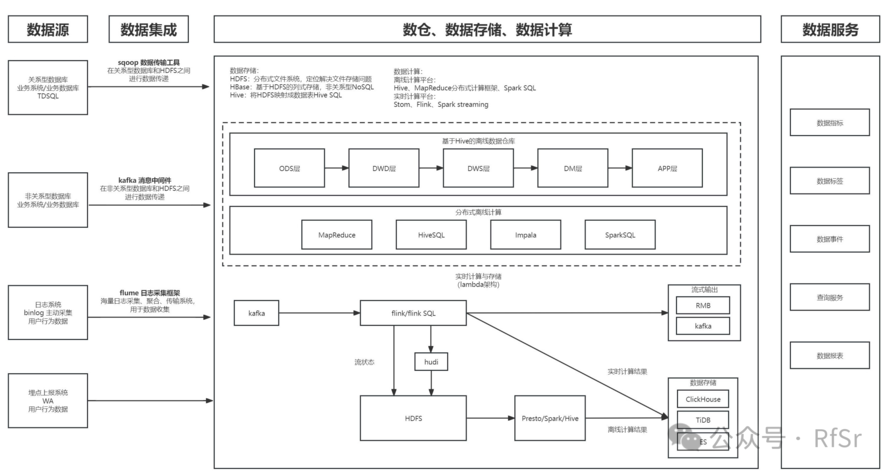
以这张图献上我理解的大数据平台框架。下文的每一部分都对应了这张图的一列内容。
01
数据源
简单把数据源类型划分为业务数据、日志数据、埋点数据和外部数据。前三者是企业内部运营过程中产生的数据,外部数据一般是采购的第三方数据。对数据源类型的定义可以参考:
业务数据:业务经营过程中产生的各类数据。
日志数据:指应用程序、系统或设备在运行过程中产生的记录信息,主要用于监控、跟踪、诊断和优化系统的运行。通常以原始日志形式存储,包含了用户的每一次请求记录。
埋点数据:在特定的事件或操作发生时捕获的数据(一般是浏览、点击等),通常用于跟踪用户行为和关键性能指标。前端埋点上报有漏损和误报的风险,对数据准确性要求高的一般采用业务系统上报事件的方式。埋点数据可以看作是日志数据的一个子集。
值得关注的是外部数据的接入,一般公司采购外部数据,对接方式会分为接口调用和批量文件接入两种。提供数据的厂商和接入的公司一般都有各自数据对接规范,视数据厂商实力强弱,决定是否配合接入公司进行对接规范的适配改造。
方式1、接口调用:接口分为联机接口和批量异步回调两种,联机接口又可以细分为联机点查和联机查多条。需要做的事情:
1)关注厂商提供的接口文档中的协议类型,厂商会提供接口文档和测试环境地址,如果公司内部有IT合作伙伴接入提单的流程,需要和开发、运维确认访问厂商测试环境的实例和ip地址,并把实例和ip地址提供给厂商进行加白操作,公司也需要开通防火墙。
2)评估业务场景,计算峰值的QPS/TPS,考虑一定的冗余,倒推厂商最高需要支持多少并发,目前厂商接口的性能是否满足业务时效预期。如超时的QPS/TPS会到多少。需要进行压测。
举例:页面A有企业列表,调用场景是坐席每次打开页面A,请求厂商企业列表中所有企业的资料信息,根据业务需求,需要实现秒级返回的时效。
需要统计业务系统每天的高峰使用时段,如电销业务系统每天高峰使用时段为9:00a.m.-12:00a.m.和2:00p.m.-6:00p.m.,调用峰值为1000次/分钟,页面A的企业列表平均企业数是10个,考虑单倍冗余。QPS = 1000(次/分钟)x 10(个)x 2(单倍冗余)/ 60(转换分钟为秒)= 333。进行梯度压测,统计RT响应时间是否能实现秒级内返回。计算最大能支持的并发数,是否大于业务系统的请求。
3)梳理系统间交互,业务系统调用前置区服务,前置区访问厂商。
方式2、批量文件接入:搭好SFTP服务器,对端开好白名单,双方约定数据文件上传时间,公司设定调度工作流和时间,根据约定时间点,发通知给前置区,访问SFTP服务器的约定目录下拉取文件入库。
在第二部分数据集成之前,我们需要了解一下Hadoop生态,后面的每一个环节都涉及Hadoop生态的组件。
Hadoop是用于大数据采集、存储、计算、分析的分布式存储系统和分布式计算框架。其中三个核心组件是HDFS分布式文件系统、HBase分布式数据库、MapReduce分布式计算框架。
Hadoop:开源分布式计算平台,核心是HDFS和MapReduce。
HDFS:Hadoop分布式文件系统,被设计为适合运行在通用和廉价硬件上的分布式文件系统。为处理大型数据集设计的,主要为达到高数据吞吐量设计,延迟时间在分钟乃至小时级别。
HBase:分布式、面向列的开源数据库,适合于非结构化数据存储的数据库。
数据采集组件:
Sqoop:SQL-to-Hadoop,用于Hadoop和关系数据库之间交换数据,通过Sqoop可以将数据从MySQL,Oracle,PostgreSQL等关系数据库中导入Hadoop,或者将数据从Hadoop导出到关系型数据库。
Flume:海量日志采集、聚合、传输系统,支持在日志系统中定制各类数据发送方用于收集数据,提供对数据进行简单处理并写到各种数据接收方的能力。
Kafka:分布式消息队列,用于发布订阅消息的系统,可用于完成实时数据的传输处理。
数据存储组件:
Hive:Hadoop的数仓框架,将存储在HDFS的文件映射成数据表,并提供类SQL(HiveSQL/HQL)语句进行数据表操作。
Redis:基于key-value的、可持久化的日志型内存数据库,可解决大数据量缓存问题,可将内存中的数据写入硬盘中做持久化的保存。
数据计算组件:
MapReduce:Hadoop体系中核心计算模块。
Spark:当前最流行的开源大数据内存计算框架,可以基于Hadoop上存储的大数据进行计算。相比于MapReduce主要处理离线数据,Spark可以进行实时流式数据的分析处理。当任务对实时性要求较高时,考虑选择Spark。
Storm:定位是分布式实时计算系统。
Flink:针对流数据+批数据的计算框架。
系统管理组件:
Zookeeper:分布式协调服务,为应用提供统一命名、配置维护、域名服务、分布式同步等一致性服务。
Yarn:Hadoop的集群资源管理工具。
02
数据集成
数据集成指的是将各种来源、类型的数据整合,纳入大数据平台。由于存储和计算的数据量巨大,超出业务系统数据库的能力范围,大数据平台有对应的存储、计算组件,需要把数据从业务系统的数据库导入到大数据平台中进行存储和计算。
数据分为关系型和非关系型两种,关系型数据通常存储在MySQL,Oracle等关系型数据库中,需要用大数据技术处理和存储关系型数据,需要将数据导入到HDFS,HBase等大数据存储系统中,通过MapReduce,Spark等分布式计算技术进行分析处理。与业务系统进行对接,需要将Hadoop大数据系统产生的数据导回关系型数据库中。
Hadoop生态针对关系型数据库的数据传输提供了Sqoop,针对非关系型数据库的数据传输提供了Flume。
总结不同类型数据的接入方式:
结构化数据:sqoop, kettle,talend,informatica,datastage
日志数据:flume,filebeats,logstash
IOT数据:kafka
文件数据:FTP,webdav协议
03
数据存储和数仓
数据大小可以参考这个转化公式:
KB>>>MB>>>GB>>>TB>>>PB>>>EB>>>ZB>>>YB>>>NB>>>DB
1Byte=88Bit
1K=1024Byte
1MB=1024K
1G=1024M
1T=1024G
1P=1024T
数据集成到大数据平台后,需要进行存储。在Hadoop生态中,常用的存储系统有分布式文件系统HDFS和分布式数据库系统HBase。HDFS适用于文件形式保存的数据,HBase适用于结构化和半结构化形式保存数据,HBase作为分布式列存储系统,构建在分布式文件系统HDFS之上。
提到数据存储就会提到数仓。数仓是数据输入和数据输出之间的中间整合过程,并不是数据的最终目的地,为数据应用做好清洗、计算等准备。数仓是基于大数据平台的存储引擎、存储格式,基于维度建模方法建设的结构化数据集合。
数仓的全称是数据仓库,分为贴源层ODS、数据明细层DWD、数据汇总层DWS、应用层APP。进行数仓分层可以减少重复开发,保障数据安全。当数据量很大时,查询速度会变慢,数仓分层可以通过对不同层级进行不同维度的抽象,提高查询速度。由于不同业务对指标的定义不一,建设数仓可以统一取数口径,降低取数门槛;按照既定主题汇总可以提高取数效率;数仓分层底层表切换或者变动可以减少对上层应用层表和应用服务的影响。
贴源层ODS直接接入的原始日期数据或者从业务库直接同步过来的数据,历史可追溯。
数据明细层DWD,依赖ODS层形成数据明细,保留数据的原始粒度,在贴源层基础上对数据进行加工和处理,包括去除空值、过滤无意义数据、异常值处理、进行一致性处理等数据清洗操作,及维度建模和脱敏。
数据汇总层DWS,依赖DWD层明细数据按需进行汇总,如按页面汇总访问日志,按天统计访问流量。
维度层DIM,保存一些企业常用的维度表。
应用层APP,面向具体应用的结果集,服务特定场景,复用性不强。
数据加工的流向必须是单向的,只能按数仓体系从低到高的顺序进行加工。不同的数据同步方式决定表的不同。
全量:每次同步源表所有数据,对应全量表,没有日期分区。
增量:首次全量抽取,之后每次只同步变更的数据。对应增量表,按天分区,每天分区只会存放当天产生的增量数据。
快照:在目标表中添加一个数据快照时间标识字段,区分数据加载时间。对应快照表,按天分区,每天分区都是截至到当天的全量数据。
覆盖:用最新的数据覆盖原有的旧数据,一般和全量同步一起使用。
另外还有流水表和中间表。
流水表:记录表的每一条修改,反应记录变化。
中间表:专门存放中间计算结果的数据表。
当数据量大到一定程度,系统的查询性能会下降,影响用户使用体验。冷热分离是一种常见的解决思路。在处理数据时将数据库分成冷库和热库,冷库存放走到终态、不常使用的数据,热库存放还需要修改、经常使用的数据。据统计在大部分储存系统中,经常被访问的热数据只占15%-25%,不经常被访问的冷数据占据了75%-85%。
04
数据计算
根据业务不同场景的需要,数据计算分为离线计算和实时计算两种。对于时效要求不高,T-1的任务,离线计算可满足需求。部分业务对时效要求很高,要求实时或者只能接受分钟级别的延迟,需要进行实时计算/准实时计算。
数据计算和数仓是紧密结合的。数仓为数据计算提供了稳定的数据存储和处理环境,为数据分析提供了丰富的数据源和灵活的数据查询方式,数据计算通过处理和分析数仓的数据,提取信息,支撑业务发展。
以下内容均来自公众号:一个数据人的自留地文章《离线数仓和实时数仓的区别》。
离线计算场景的数仓架构

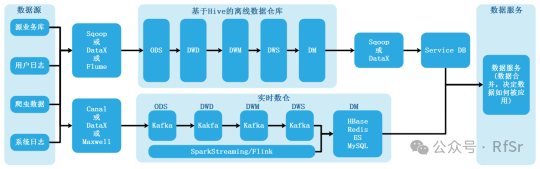
离线大数据架构不能处理实时的任务,产生了流式计算引擎,如Storm,Spark,Flink。分为lambda和kappa两种架构。
lambda架构:
数据集成后分成两条线进行计算。一条线进入流式计算平台(如storm,spark,flink)计算实时指标,保证实时性;另一条线进入批量离线计算平台(如MapReduce,Hive,Spark SQL)计算T+1的相关指标,保证数据准确有效。
模式1:离线数据+实时处理链路。没有构建实时数仓,没有分层,由离线数仓和实时业务处理部分组成。
模式2:离线数仓+实时数仓。每次批处理计算后会覆盖流处理的结果。
kappa架构:
基于流计算处理所有的数据。
数据计算组件:
MapReduce:Hadoop体系中核心计算模块。
Spark:当前最流行的开源大数据内存计算框架,可以基于Hadoop上存储的大数据进行计算。相比于MapReduce主要处理离线数据,Spark可以进行实时流式数据的分析处理。当任务对实时性要求较高时,考虑选择Spark。
Storm:定位是分布式实时计算系统。
Flink:针对流数据+批数据的计算框架。
05
提供数据服务
常见的数据服务包括指标、标签、事件、查询服务、报表等,会在后续的文章进行梳理和分享。后面第二篇打算写对数据产品经理的理解和需求的复盘。
06
参考
大数据技术原理与应用:概念、存储、处理、分析与应用(第三版)
大数据技术体系详解:原理、架构与实践
从程序员到架构师:大数据量、缓存、高并发、微服务、多团队协同等核心场景实战
一个数据人的自留地公众号
来自 “ RfSr RfSr ”, 原文作者:RfSr ;原文链接:https://mp.weixin.qq.com/s/FqdYEstnAhK1jKxDMXUM2g,如有侵权,请联系管理员删除。

