众所周知,Hadoop 中最核心的两大组件就是 HDFS 和 MapReduce。其中 HDFS 提供了承载海量数据存储的能力,而 MapReduce 则提供了海量数据并行计算的能力。
而本期文章,我将为大家介绍关于 MapReduce 的核心知识点。
MapReduce的原理
Hadoop 中 MapReduce 最核心的思想就是分而治之,通过 MapReduce 这个名字就可以看出,MapReduce 包含有 Map 和 Reduce 两个部分。它将一个大型的计算问题分解成一个个小的,简单的计算任务,交给 MapReduce 中的 Map 部分执行,随后 Reduce 部分会对 Map 部分输出的中间结果进行聚合计算,输出最终的统计结果。
为了方便大家理解,可以看下 MapReduce 的简要模型图:
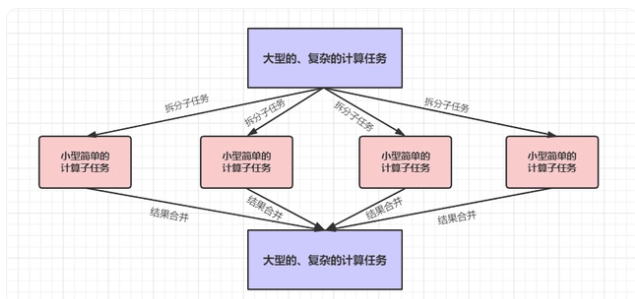
每个子任务在框架中都是高度并行计算的,然后 MapReduce 框架将各个计算子任务的计算结果进行合并,得出最终的计算结果。
每个子任务在 MapReduce 内部都是高度并行计算的,子任务的高度并行化极大地提高了 Hadoop 处理海量数据的性能。MapReduce 的并行计算模型如图所示:
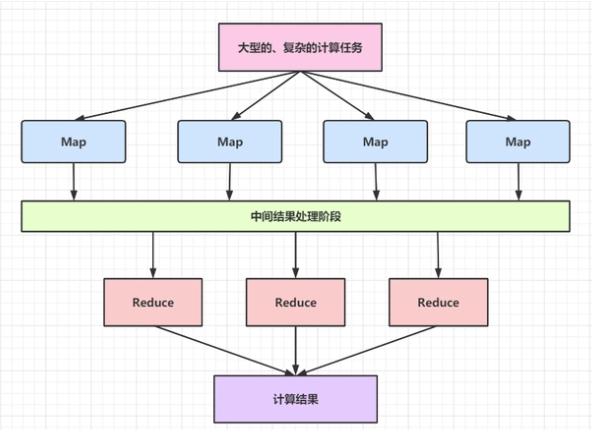
由图可知,MapReduce 框架将一个大型的计算任务拆分为多个简单的计算任务,交由多个 Map 并行计算,每个 Map 的计算结果经过中间结果处理阶段的处理后输入 Reduce 阶段,Reduce 阶段将输入的数据进行合并处理,输出最终的计算结果 。
同时,用户无须关心 MapReduce 底层各个节点之间的通信机制与通信过程,只需简单地编写 map() 函数和 reduce() 函数即可开发 Hadoop MapReduce 程度。
MapReduce的部署结构
MapReduce 框架由一个主节点(ResourceManager)、多个子节点(NodeManager)和每个执行任务的 MR AppMaster 共同组成 。通常会将 MapReduce 的计算节点和存储节点部署在同一台服务器上,如图所示:
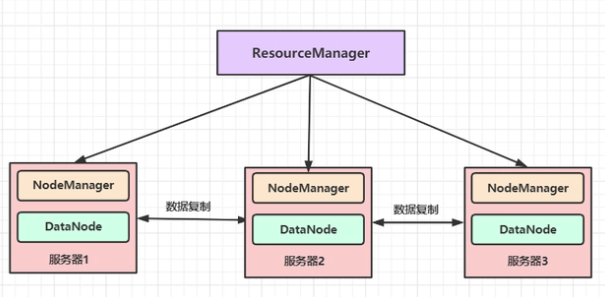
这种部署结构可以使 MapReduce 框架在已经存储好数据的节点上快速、高效地调度任务,尽可能地不用通过 RPC 从其他服务器上获取数据来执行任务,使整个集群的网络带宽被高效利用,极大地提升了处理任务的效率。
MapReduce 的运行流程
MapReduce 编程模型简化了分布式系统中并行计算的复杂度,开发人员能够不必关心 MapReduce 程序的底层实现细节,只专注于解决业务需求。
在 MapReduce 框架内部,整个运行流程可以分为如下四个阶段,其中每个阶段中的数据传输格式也不一样。
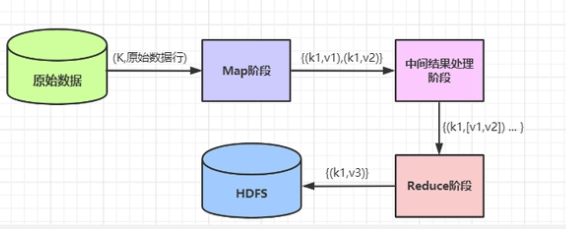
简单运行流程如下所示:
大致流程:
(1)原始数据经过 Hadoop 框架的处理,将 “(k,原始数据行)”格式的数据输入 Map 阶段,即 Map 阶段接收到的数据都是 “(k,元素数据行)”的。
(2)数据经过 Map 阶段处理之后,输出 “{(k1,v1),(k2,v2)}”格式的中间结果
(3)Map阶段输出的中间结果经由 Hadoop 的中间结果处理阶段(如聚合、排序等)之后,会形成 “ {(k1,[v1,v2]) …} ”格式的数据
(4)中间结果处理阶段形成的 “{(k1,[v1,v2]) …}”格式的数据会输入 Reduce 阶段进行处理。此时,key相同的数据会被输入进同一个 Reduce 函数进行处理(也可以由用户自定义数据分发规则)
(5)数据经过 Reduce 阶段处理之后,最终会形成“{(k1,v3)}” 格式的数据存入 HDFS 中
另外,如果觉得不够清晰,也可以参考下下面这个版本的 MapReduce 运行流程。

(1)原始数据被切分为多个小的数据分片输入 map() 函数,这些小的数据分片往往是原始数据的数据行,它们以 “(k,line)” 的格式输入 map() 函数,其中 k 表示数据的偏移量,line 表示整行数据。
(2)map() 函数并行处理输入的数据分片,根据具体的业务规则对输入的数据进行相应的处理,输出中间处理结果,这些中间处理结果往往以“{(k1,v1),(k2,v2)}” 的格式存在。
(3)中间处理阶段将 map() 函数输出的中间结果根据 key 进行聚合处理,输出聚合结果,这些聚合结果的格式为:“{(k1,[v1,v2])}”。
(4)中间处理阶段将输出的聚合结果输入 reduce () 函数进行处理( key相同的数据会被输入同一个 reduce()函数中,用户也可以自定义数据分发规则 ),reduce()函数对这些数据进行进一步聚合和计算等。
(5)reduce 函数将最终的结果以 “ (k,v) ”的格式输出到 HDFS 中。
MapReduce优化
关于 MapReduce 优化方法主要从以下6个方面进行考虑,分别是:数据倾斜、Map阶段、Reduce阶段、IO传输、数据倾斜问题和常用的调优参数。
1、数据输入
(1)合并小文件
(2)采用 CombineText InputFormat 来作为输入,解决输入端大量小文件场景。
2、Map阶段
(1)减少溢写(spill)次数
(2)减少合并(Merge)次数
(3)在 Map 之后,不影响业务逻辑前提下,先进行 Combine 处理,减少 I/O 。
3、Reduce 阶段
(1)合理设置 Map 和 Reduce 数
(2)设置 Map、Reduce 共存
(3)规避使用 Reduce
(4)合理设置 Reduce 端的 Buffer
4、I/O 传输
(1)采用 数据 压缩的方式,减少 网络 IO 的时间 。安装 Snappy 和 LZO 压缩编码器。
(2)使用 SequenceFile 二进制文件。
5、数据倾斜问题
1. 数据倾斜现象:
数据频率倾斜——某一个区域的数据量要远远大于其他的区域。
数据大小倾斜——部分记录的大小远远大于平均值
2.减少数据倾斜的方法:
方法1 :抽样和范围分区
方法2:自定义分区
方法3:Combine
方法4:采用 Map Join,尽量避免 Reduce Join
实际上,关于 MapReduce的内容还有很多,本期文章只是将比较重要核心的部分介绍了一下。其中,MapReduce的原理,运行流程,优化是面试中比较经常考察的点。
来自 “ 东软睿道 ”, 原文作者:东软睿道 ;原文链接:https://baijiahao.baidu.com/s?id=1742751381311976611&wfr=spider&for=pc,如有侵权,请联系管理员删除。

