前言
最近在学习K8S相关云原生技术,因为工作中正好接触到,便一直想找个机会深入学习一下这个方向的利用与防御,学习之后发现东西挺多。由于篇幅原因,决定将其整理成一个系列,拆分成几篇文章输出,本篇文章主要介绍K8s的搭建和概念的介绍,在理解概念之后,会逐步分享k8s中的攻击和防御措施。本系列文章主要为个人学习记录总结,若有错误,烦请斧正。
什么是Kubernetes?
随着微服务架构被越来越多的公司使用,大部分单体应用正逐步被拆解成小的、独立运行的微服务。微服务的优势这里不做探讨,但是其带来的服务维护问题大大增加,若想要在管理大量微服务的情况下还需要让资源利用率更多且硬件成本相对更低,那么基于容器部署的微服务的一些自动化设施的需求就这样诞生了,于是就有了Kubernetes(简称k8s),其提供的特性有:
服务发现和负载均衡
存储编排
自动发布和回滚
自愈
密钥及配置管理
通过下面架构图可以看到其有上下两部分对应的
Master&Node节点构成,这两种角色分别对应着控制节点和计算节点。
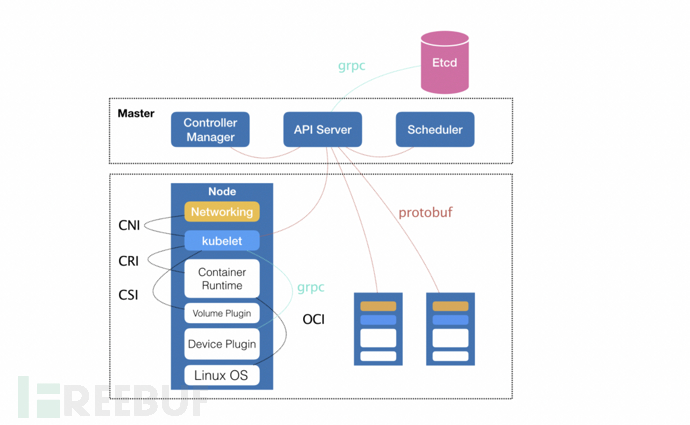
Master控制节点主要出发点在于如何编排、管理、调度用户提交的作业,一个k8s集群中至少要有一台master节点。
Kubernetes控制节点主要由以下几个核心组件组成:
etcd : 保存了整个集群的状态,它是一个高可用性键值存储,可以在多个节点之间分布。只有Kubernetes API服务器可以访问它,因为它可能具有一些敏感信息。这是一个分布式键值存储,所有人都可以访问。简而言之:存储节点信息
apiserver提供了资源操作的唯一入口,并提供认证、授权、访问控制、API注册和发现等机制,是读取与解析请求指令的中枢。
controller manager负责维护集群的状态,比如故障检测、自动扩展、滚动更新等,简而言之即维护k8s资源。
scheduler负责资源的调度,按照预定的调度策略将Pod调度到相应的机器上,即:负载均衡调度器。
对于计算节点:
kubelet 存在于每个node节点上,负责维护容器的生命周期,同时也负责Volume(CSI)和网络(CNI)的管理。
Container runtime负责镜像管理以及Pod和容器的真正运行(CRI)
kube-proxy负责为Service提供cluster内部的服务发现和负载均衡
K8s搭建
单机安装
关于单机安装
k8s,我使用的相关环境如下:
- macOS:Catalina 10.15.1
- Docker Desktop Vesion:3.0.2
- Kubernetes:1.19.3
由于镜像的下载涉及到网络原因,因此这里使用了开源项目
k8s-docker-desktop-for-mac来解决这个问题,需要注意的是要修改
images的相关镜像的版本,要和此时
Kubernetes配对上才行,比如我设置的是:
k8s.gcr.io/kube-proxy:v1.19.3=gotok8s/kube-proxy:v1.19.3
k8s.gcr.io/kube-controller-manager:v1.19.3=gotok8s/kube-controller-manager:v1.19.3
k8s.gcr.io/kube-scheduler:v1.19.3=gotok8s/kube-scheduler:v1.19.3
k8s.gcr.io/kube-apiserver:v1.19.3=gotok8s/kube-apiserver:v1.19.3
k8s.gcr.io/coredns:1.7.0=gotok8s/coredns:1.7.0
k8s.gcr.io/pause:3.2=gotok8s/pause:3.2
k8s.gcr.io/etcd:3.4.13-0=gotok8s/etcd:3.4.13-0
随后打开
Docker,进入设置界面,勾选
Enable Kubernetes即可:
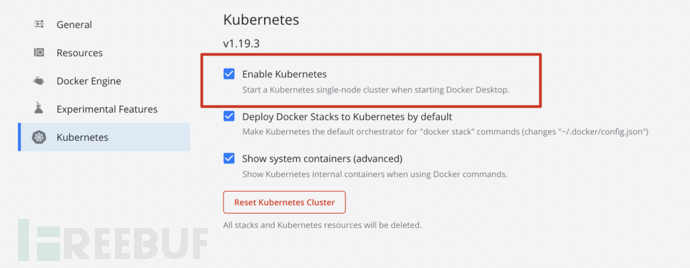
不出意外,界面左下角会出现
Kubernetes running的提示,这样就安装成功了。
如果状态一直处于
Kubernetes starting状态,可在终端执行以下命令然后重启
Docker:
rm -rf ~/.kube
rm -rf ~/Library/Group\\ Containers/group.com.docker/pki/
K8集群搭建
准备
准备三台机器:
10.206.32.6(2核4G):Master:
执行:
hostnamectl set-hostname masterecho "127.0.0.1 $(hostname)" >> /etc/hosts10.206.32.9(2核2G):Node01
执行:
hostnamectl set-hostname node01echo "127.0.0.1 $(hostname)" >> /etc/hosts110.206.32.13(2核2G):Node02
执行:
hostnamectl set-hostname node02echo "127.0.0.1 $(hostname)" >> /etc/hostsKubernetes版本:v1.19.3
Docker版本:19.03.12
开始前请检查以下事项:
CentOS 版本:>= 7.6
CPU:>=2
IP:互通
关闭 swap:
swapoff -a关闭防火墙:systemctl stop firewalld
将桥接的IPV4流量传递到iptables 的链:
cat > /etc/sysctl.d/k8s.conf << EOF
net.bridge.bridge-nf-call-ip6tables = 1
net.bridge.bridge-nf-call-iptables = 1
net.ipv4.ip_forward = 1
EOF
 sysctl --system
- 安装docker环境
配置国内kubernetes源:
cat > /etc/yum.repos.d/kubernetes.repo <<EOF
[kubernetes]
name=Kubernetes Repo
baseurl=https://mirrors.tuna.tsinghua.edu.cn/kubernetes/yum/repos/kubernetes-el7-x86_64/
gpgcheck=0
enabled=1
EOF
安装相关依赖工具:
# 安装kubelet 1.19.3
yum install -y kubelet-1.19.3 kubeadm-1.19.3 kubectl-1.19.3
#在交换分区的可以设置忽略禁止使用Swap的限制,不然无法启动Kubelet
view /etc/sysconfig/kubelet
KUBELET_EXTRA_ARGS="--fail-swap-on=false"
# 设置开机启动
systemctl enable kubelet.service && systemctl start kubelet.service
# 查看状态
systemctl status kubelet.service
初始化Master
在主节点(10.206.32.6)执行以下命令:
export MASTER_IP=10.206.32.6
export APISERVER_NAME=apiserver.demo
export POD_SUBNET=10.100.0.1/16
echo "${MASTER_IP}    ${APISERVER_NAME}" >> /etc/hosts
新建脚本
init_master.sh
vim init_master.sh
#!/bin/bash
# 只在 master 节点执行
# 脚本出错时终止执行
set -e
if [ ${#POD_SUBNET} -eq 0 ] || [ ${#APISERVER_NAME} -eq 0 ]; then
  echo -e "\033[31;1m请确保您已经设置了环境变量 POD_SUBNET 和 APISERVER_NAME \033[0m"
  echo 当前POD_SUBNET=$POD_SUBNET
  echo 当前APISERVER_NAME=$APISERVER_NAME
  exit 1
fi
# 查看完整配置选项 https://godoc.org/k8s.io/kubernetes/cmd/kubeadm/app/apis/kubeadm/v1beta2
rm -f ./kubeadm-config.yaml
cat <<EOF > ./kubeadm-config.yaml
apiVersion: kubeadm.k8s.io/v1beta2
kind: ClusterConfiguration
# k8s 版本
kubernetesVersion: v1.19.3
imageRepository: registry.aliyuncs.com/k8sxio
controlPlaneEndpoint: "${APISERVER_NAME}:6443"
networking:
  serviceSubnet: "10.96.0.0/16"
  podSubnet: "${POD_SUBNET}"
  dnsDomain: "cluster.local"
EOF
# kubeadm init
# 根据您服务器网速的情况,您需要等候 3 - 10 分钟
kubeadm config images pull --config=kubeadm-config.yaml
kubeadm init --config=kubeadm-config.yaml --upload-certs
# 配置 kubectl
rm -rf /root/.kube/
mkdir /root/.kube/
cp -i /etc/kubernetes/admin.conf /root/.kube/config
# 安装 calico 网络插件
# 参考文档 https://docs.projectcalico.org/v3.13/getting-started/kubernetes/self-managed-onprem/onpremises
echo "安装calico-3.13.1"
rm -f calico-3.13.1.yaml
wget https://kuboard.cn/install-script/calico/calico-3.13.1.yaml
kubectl apply -f calico-3.13.1.yaml
如果出错:
# issue 01
# [ERROR FileContent--proc-sys-net-bridge-bridge-nf-call-iptables]: /proc/sys/net/bridge/bridge-nf-call-iptables contents are not set to 1
# 所有机器执行
echo 1 > /proc/sys/net/bridge/bridge-nf-call-iptables
echo 1 > /proc/sys/net/bridge/bridge-nf-call-ip6tables
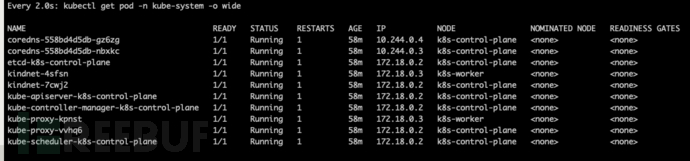
检查
master初始化结果:
# 直到所有的容器组处于 Running 状态
watch kubectl get pod -n kube-system -o wide
# 查看 master 节点初始化结果
kubectl get nodes -o wide
如下图:
获得join命令参数
直接在
master执行:
kubeadm token create --print-join-command
比如此时输出:
# 有效期两小时
kubeadm join apiserver.demo:6443 --token uysznt.3enu78oflli383zt     --discovery-token-ca-cert-hash sha256:345664bfbdfd9178ea69edf2469387d7d224121b208bb90bad5a2c1952bcb9f3
初始化Node
在所有
node执行:
export MASTER_IP=10.206.32.6
export APISERVER_NAME=apiserver.demo
echo "${MASTER_IP}    ${APISERVER_NAME}" >> /etc/hosts
# 替换为 master 节点上 kubeadm token create 命令的输出
kubeadm join apiserver.demo:6443 --token vh5hl9.9fccw1mzfsmsp4gh     --discovery-token-ca-cert-hash sha256:6970397fdc6de5020df76de950c9df96349ca119f127551d109430c114b06f40
检查初始化结果
在
master节点执行:
kubectl get nodes -o wide
输出结果如下:

Kubernetes Dashboard
Dashboard可以将容器化应用程序部署到
Kubernetes集群,对容器化应用程序进行故障排除,以及管理集群资源。
安装
安装命令如下:
wget <https://raw.githubusercontent.com/kubernetes/dashboard/v2.1.0/aio/deploy/recommended.yaml> -O recommended.yaml
kubectl apply -f recommended.yaml
kubectl get pods --namespace=kubernetes-dashboard -o wide
此处执行完会发现
STATUS都是
ContainerCreating,
kubectl describe pod dashboard-metrics-scraper-856586f554-tkm49 --namespace=kubernetes-dashboard
查看日志找找原因,发现是因为
metrics-scraper:v1.0.6镜像下载不下来,手动执行:
docker pull kubernetesui/metrics-scraper:v1.0.1拉下来之后就妥了。
最后我们需要将访问形式改为
NodePort访问:
kubectl --namespace=kubernetes-dashboard edit service kubernetes-dashboard
# 将里面的 type: ClusterIP 改为 type: NodePort
保存后,执行:
kubectl --namespace=kubernetes-dashboard get service kubernetes-dashboard
终端输出:
NAME TYPE CLUSTER-IP EXTERNAL-IP PORT(S) AGE kubernetes-dashboard NodePort 10.98.194.124 <none> 443:31213/TCP 107m
Token
在浏览器访问:
https://0.0.0.0:31213/:
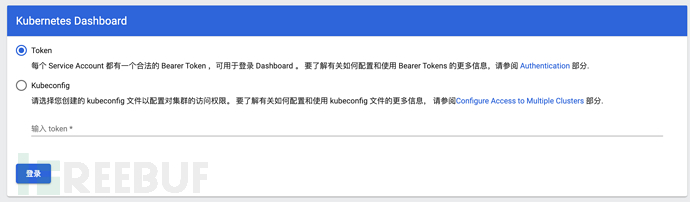
看界面需要生成
Token:
vim admin-user.yaml
# 输入
apiVersion: v1
kind: ServiceAccount
metadata:
  name: admin-user
  namespace: kubernetes-dashboard
# 保存退出
vim admin-user-role-binding.yaml
# 输入
apiVersion: rbac.authorization.k8s.io/v1
kind: ClusterRoleBinding
metadata:
  name: admin-user
roleRef:
  apiGroup: rbac.authorization.k8s.io
  kind: ClusterRole
  name: cluster-admin
subjects:
- kind: ServiceAccount
  name: admin-user
  namespace: kubernetes-dashboard
# 保存退出
# 执行命令加载配置
kubectl create -f admin-user.yaml
kubectl create -f admin-user-role-binding.yaml
# 若出现已存在
# 执行:kubectl delete -f xxx.yaml 即可
获取令牌:
kubectl -n kubernetes-dashboard describe secret $(kubectl -n kubernetes-dashboard get secret | grep admin-user | awk '{print $1}')
复制
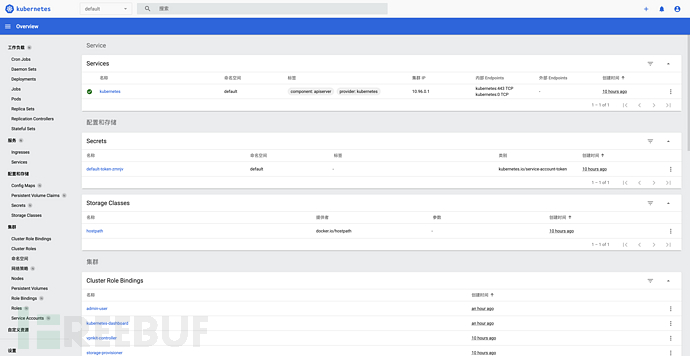
token到刚才的界面登录即可,登录后界面如下:
如果想延长
Token的有效时间:
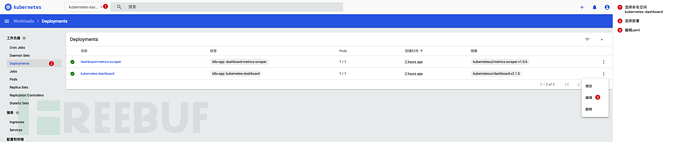
然后在
containners->args加上
--token-ttl=43200。
部署镜像
下拉一个你自己想部署的镜像,具体命令如下(主节点执行):
# 部署
kubectl run hello --image=xxx/hello --port=5000
# 列出 pod
kubectl get pods
# 创建一个服务对象
# NodePort 在所有节点(虚拟机)上开放一个特定端口,任何发送到该端口的流量都被转发到对应服务
kubectl expose po hello --port=5000 --target-port=5000 --type=NodePort  --name hello-http
# 列出服务
kubectl get services
概念理解
俗话说,磨刀不误砍柴工。上面我们成功搭建了k8s集群,接下来我们主要花时间了解一下k8s的相关概念,为后续掌握更高级的知识提前做好准备。
本文主要讲解以下四个概念:
PodDeploymentServiceNamespace
Deployment
让我们从使用
Deployment运行一个无状态应用来开始吧,比如运行一个
nginx Deployment(创建文件:
nginx-deployment.yaml):
apiVersion: apps/v1
kind: Deployment
metadata:
  name: nginx-deployment
  labels:
    app: nginx
spec:
  replicas: 1
  selector:
    matchLabels:
      app: nginx
  template:
    metadata:
      labels:
        app: nginx
    spec:
      containers:
      - name: nginx
        image: nginx:latest
        ports:
        - containerPort: 80
配置文件第二行,有个
kind字段,表示的是此时
yaml配置的类型,即
Deployment。什么是
Deployment?这里我先不做解释,让我们先实践,看能不能在使用过程中体会出这个类型的概念意义。
在终端执行:
kubectl apply -f ./nginx-deployment.yaml
# 输出
deployment.apps/nginx-deployment created
然后通过以下命令分别查看集群中创建的 Deployment 和 Pod 的状态:
# 查看 Deployment
kubectl get deployments
# 输出
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   1/1     1            1           27m
# 查看 Pod
kubectl get pods
# 输出
NAME                               READY   STATUS    RESTARTS   AGE
nginx-deployment-585449566-cl6rv   1/1     Running   0          27m
# 查看 Deployment 的信息
kubectl describe deployment nginx
# 删除 Deployment
kubectl delete deployment nginx-deployment
# 查看 Pod 的信息
# kubectl describe pod <pod-name>
# 这里的 <pod-name> 是某一 Pod 的名称
kubectl describe pod  nginx-deployment-585449566-cl6rv
# 进入容器
kubectl exec -it nnginx-deployment-585449566-cl6rv -- /bin/bash
此时我们已经成功在k8s上部署了一个实例的nginx应用程序。k8s中的应用程序是通过 Deployment来部署的,Deployment来指导k8s完成应用程序的部署和更新维护。比如说,当Deployment在部署应用时,master节点会选择最合适的节点创建包含相应Container(容器)的POD
又比如说,Deployment会监控应用程序实例,当运行应用程序的工作节点宕机时,它将会在判断集群中最适宜重新部署的工作节点,并在其上面重新创建新的实例(新创建的应用程序的POD ip和pod名会与之前的不同)。
但是,等等!我们好像又看到了一个新的名词
Pod,这又是什么?让我们带着疑问继续往下看吧。
Pod
在Kubernetes中,最小的管理元素不是一个个独立的容器,而是pod(目的在于解决容器间紧密协作关系的难题)
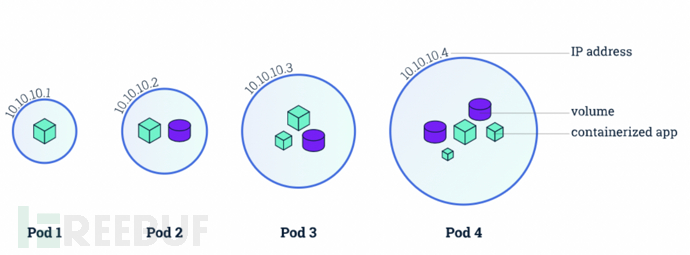
Pod是一组并置的容器,代表了
Kubernetes中的基本构建模块:
-
一个
Pod包含:
一个或多个容器(container)
容器(container)的一些共享资源:存储、网络等
-
一个
Pod的所有容器都运行在同一个节点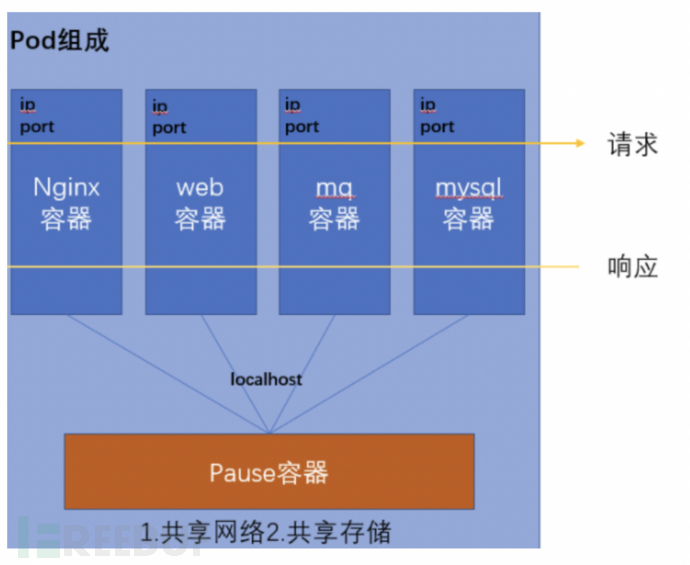
容器可以被管理,但是容器里面的多个进程实际上是不好被管理的,所以 容器被设计为每个容器只运行一个进程。
容器的本质实际上就是一个进程,
Namespace 做隔离,Cgroups 做限制,rootfs 做文件系统。在一个容器只能运行一个进程的前提下,实际开发过程中一个应用是由多个容器紧密协作才可以成功地运行起来。因此,我们需要另一种更高级的结构来将容器绑定在一起,并将它们作为一个单元进行管理,这就是
Pod出现的目的。
如何定义并创建一个Pod
创建文件
nginx-pod.yaml:
apiVersion: v1
kind: Pod
metadata:
  name: nginx
  labels:
    name: nginx
spec:
  containers:
  - name: nginx
    image: nginx:latest
    ports:
      - containerPort: 80
相关字段解释如下:
kind: 该配置的类型,这里是 Pod
metadata:元数据
- name:Pod的名称
- labels:标签
spec:期望Pod实现的功能
containers:容器相关配置
name:container名称
image:镜像
ports:容器端口
containerPort:应用监听的端口
运行:
# 创建
kubectl create -f nginx-pod.yaml
# 输出
pod/nginx created
# 查看
kubectl get pods
# 输出
NAME                               READY   STATUS    RESTARTS   AGE
nginx                              1/1     Running   0          10s
nginx-deployment-585449566-cl6rv   1/1     Running   0          33m
# 查看 Pod 完整的描述性文件
# yaml 是你想看的格式 也可以是 json
kubectl get po nginx -o yaml
# 删除 Pod
kubectl delete -f nginx-pod.yaml
这里简单介绍了用声明式API怎么创建
Pod,但从技术角度看,
Pod又是怎样被创建的呢?实际上
Pod只是一个逻辑概念,
Pod里的所有容器,共享的是同一个
Network Namespace,并且可以声明共享同一个
Volume。
Pod除了启动你定义的容器,还会启动一个
Infra容器,这个容器使用的就是
k8s.gcr.io/pause镜像,它的作用就是整一个
Network Namespace方便用户容器加入,这就意味着
Pod有以下特性:
内部直接使用
127.0.0.1通信,网络设备一致(Infra容器决定)只有一个IP地址
Pod的生命周期只跟Infra容器一致,而与用户容器无关
label
现在我们的集群里面只运行了一个
Pod,但在实际环境中,我们运行数十上百个
Pod也是一件很正常的事情,这样就引出了
Pod管理上的问题,我们可以通过标签来组织
Pod和所有其他
Kubernetes对象。
前面
nginx-pod.yaml里面就声明了
labels字段,标签为
name,相关操作记录如下:
`# 查看标签
kubectl get pods --show-labels
# 输出
NAME                               READY   STATUS    RESTARTS   AGE   LABELS
nginx                              1/1     Running   0          10m   name=nginx
nginx-deployment-585449566-cl6rv   1/1     Running   0          43m   app=nginx,pod-template-hash=585449566
# 增加标签
kubectl label pods nginx version=latest
# 输出
pod/nginx labeled
# 查看特定标签
kubectl get pods -l "version=latest" --show-labels
# 更新标签
kubectl label pods nginx version=1 --overwrite
# 删除标签
kubectl label pods nginx version-
Namespace
利用标签,我们可以将
Pod和其他对象组织成一个组,这是最小粒度的分类,当我们需要将对象分割成完全独立且不重叠的组时,比如我想单独基于
k8s搭建一套
Flink集群,我不用想让我的
Flink和前面搭建的
Nginx放在一起,这个时候,命名空间(namespace)的作用就体现出来了。
# 列出所有的命名空间
kubectl get ns
# 输出,我们目前都是在 default 命名空间中进行操作
NAME                   STATUS   AGE
default                Active   124m
kube-node-lease        Active   124m
kube-public            Active   124m
kube-system            Active   124m
kubernetes-dashboard   Active   37m
local-path-storage     Active   124m
让我们创建一个命名空间
vim cus-ns.yaml,输入:
apiVersion: v1
kind: Namespace
metadata:
  name: cus-ns
让我们在终端实践一番:
# 开始创建命名空间
kubectl create -f cus-ns.yaml
# 输出
namespace/cus-ns created
# 为新建资源选择命名空间
kubectl create -f nginx-pod.yaml -n cus-ns
#输出
pod/nginx created
这里我们可以暂时先做一个总结,如前面所说,
Pod可以表示
k8s中的基本部署单元。经过前面的讲解,你应该知道以下一些知识点:
手动增删改查
Pod让其服务化(Service)
但是在实际使用中,我们并不会直接人工干预来管理
Pod,为什么呢?当
Pod健康出问题或者需要进行更新等操作时,人是没有精力来做这种维护管理工作的,但我们擅长创造工具来自动化这些繁琐的事情,所以我们可以使用后面介绍的
Deployment。
外部访问
此时我们已经启动了一个
nginx,我们有哪些方法可以对
Pod进行连接测试呢?
可以使用如下命令:
kubectl port-forward nginx 8088:80
# 输出
Forwarding from 127.0.0.1:8088 -> 80
Forwarding from [::1]:8088 -> 80
# 再开一个终端访问测试或者打开浏览器
curl <http://0.0.0.0:8088/>
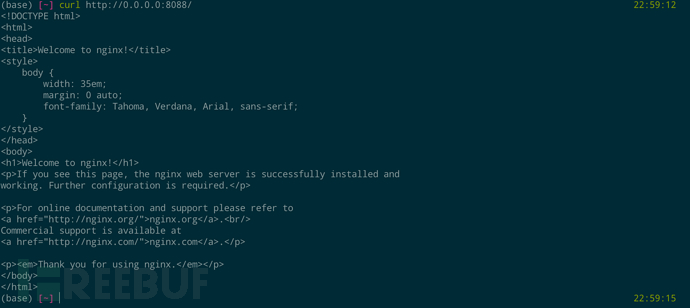
显然,成功访问,但是这个有个问题就是此端口不会长期开放,一旦一定时间内没有访问,就会自动断掉,我们需要其他的方式来进行访问,比如后面会提到的
Service,这里就简单运行个命令,大家感受一下:
# 创建一个服务对象
# NodePort 在所有节点(虚拟机)上开放一个特定端口,任何发送到该端口的流量都被转发到对应服务
kubectl expose po nginx --port=80 --target-port=80 --type=NodePort  --name nginx-http
# 输出
service/nginx-http exposed
# 查看服务
kubectl get svc
# 输出
NAME         TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE
kubernetes   ClusterIP   10.96.0.1       <none>        443/TCP        130m
nginx-http   NodePort    10.96.114.244   <none>        80:30236/TCP   21s
# 终端访问测试
curl <http://0.0.0.0:32220/>
# 输出 html, 表示成功端口成功开放给外部
Service
Service 服务的主要作用就是替代 Pod 对外暴露一个不变的访问地址
在本文中
Pod部分的
外部访问小节,就已经提到并演示了
Service,它很方便地将我们的服务端口成功开放给外部访问。
介绍
我们的
Pod是有生命周期的,它们可以被创建、销毁,但是一旦被销毁,这个对象的相关痕迹就没有了,哪怕我们用
ReplicaSet让他又复生了,但是新
Pod的
IP我们是没法管控的。
很显然,如果我们的后端服务的接口地址总是在变,我们的前端人员心中定然大骂,怎么办?这就轮到
Service出场了。
定义 Service
前面我们创建了一个名为
nginx-http的
Services,用的是命令行;接下来我们介绍一下配置文件的形式,在
nginx-deployment.yaml后面增加以下配置:
---
kind: Service
apiVersion: v1
metadata:
  name: nginx
spec:
  selector:
    app: nginx
  type:  NodePort
  ports:
    - nodePort: 30068
      port: 8068
      protocol: TCP
      targetPort: 80
相信上述配置,大部分的字段看起来都没什么问题了吧,先说一下端口这块的含义:
nodePort:通过任意节点的
30068端口来访问Serviceport:集群内的其他容器组可通过
8068端口访问ServicetargetPort:
Pod内容器的开发端口
这里我想强调的是
type字段,说明如下:
ClusterIP:默认类型,服务只能够在集群内部可以访问
NodePort:通过每个 Node 上的 IP 和静态端口(
NodePort)暴露服务LoadBalancer:使用云提供商的负载均衡器,可以向外部暴露服务。
关于
LoadBalancer,基本上是云商会提供此类型,如果是我们自行搭建的,就没有此类型可选,但是很多开源项目默认是启用这种类型,我们可以自行打一个补丁来解决这个问题:
kubectl patch svc {your-svc-name} -n default -p '{"spec": {"type": "LoadBalancer", "externalIPs":["0.0.0.0"]}}'
执行生效命令:
kubectl apply -f ./nginx-deployment.yaml
# 输出
deployment.apps/nginx-deployment unchanged
service/nginx created
# 查看服务
kubectl get services -o wide
# 输出
NAME         TYPE        CLUSTER-IP      EXTERNAL-IP   PORT(S)        AGE     SELECTOR
kubernetes   ClusterIP   10.96.0.1       <none>        443/TCP        134m    <none>
nginx-http   NodePort    10.96.114.244   <none>        80:30236/TCP   4m41s   name=nginx,version=latest
# 终端测试
curl <http://0.0.0.0:30068/>
除了前面提的两种方法(
NodePort、
LoadBalancer),还有另外一种方法——
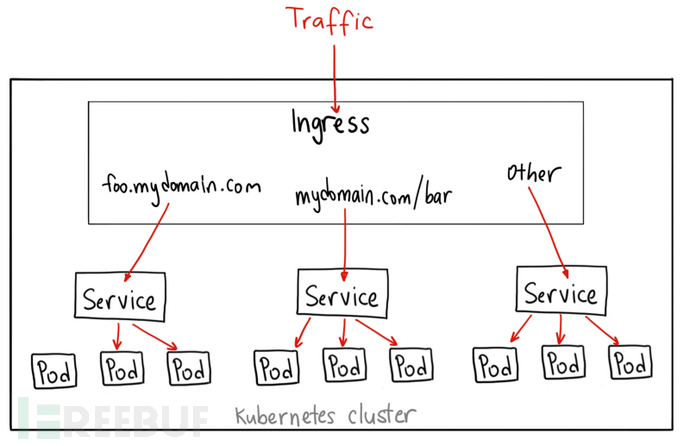
Ingress资源。我们为什么需要引入
Ingress,最主要的原因是
LoadBalancer需要公有的IP地址,自行搭建的就不要考虑了。
而
Ingress非常强大,它位于多个服务之前,充当集群中的
智能路由器或入口点:
窥一斑而知全豹,好好了解完
Pod之后,再继续了解
k8s的概念也就水到渠成了。我们一般不会直接创建
Pod,毕竟通过创建
Deployment资源可以很方便的创建管理
Pod(水平扩展、伸缩),并支持声明式地更新应用程序。
我们一开始就是以
Deployment举例,当时启动配置文件我们看到了一个
Deployment资源和一个
Pod,查看命令如下:
kubectl get deployments
# 输出
NAME               READY   UP-TO-DATE   AVAILABLE   AGE
nginx-deployment   0/1     1            0           4s
kubectl get pods
# 输出 如果名字有变化不用在意,只是我重新创建了一个 Deployment
NAME                               READY   STATUS    RESTARTS   AGE
nginx-deployment-585449566-mnrtn   1/1     Running   0          2m1s
这里我们再增加一条命令:
kubectl get replicasets.apps
# 输出
NAME                         DESIRED   CURRENT   READY   AGE
nginx-deployment-585449566   1         1         1       10m
嗯嗯~,让我们捋一捋,当我们创建一个
Deployment对象时,
k8s不会只创建一个
Deployment资源,还会创建另外的
ReplicaSet以及1个
Pod对象。所以问题来了,
ReplicaSet又是个是什么东西?
ReplicaSet
如果你更新了
Deployment的
Pod模板,那么
Deployment就需要通过滚动更新(rolling update)的方式进行更新。
而滚动更新,离不开
ReplicaSet,说到
ReplicaSet就得说到
ReplicationController(弃用)。
ReplicationController是一种k8s资源,其会持续监控正在运行的pod列表,从而保证Pod的稳定(在现有Pod丢失时启动一个新Pod),也能轻松实现Pod的水平伸缩
ReplicaSet的行为与
ReplicationController完全相同,但
Pod选择器的表达能力更强(允许匹配缺少某个标签的Pod,或包含特定标签名的Pod)。所以我们可以将
Deployment当成一种更高阶的资源,用于部署应用程序,并以声明的方式管理应用,而不是通过
ReplicaSet进行部署,上述命令的创建关系如下图:
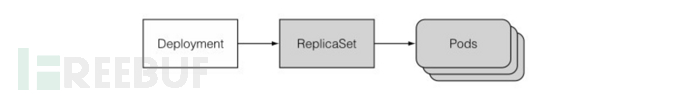
如上图,
Deployment的控制器,实际上控制的是
ReplicaSet的数目,以及每个
ReplicaSet的属性。我们可以说
Deployment是一个两层控制器:
Deployment–>ReplicaSet–>Pod
这种形式下滚动更新是极好的,但这里有个前提条件那就是
Pod是无状态的,如果运行的容器必须依赖此时的相关运行数据,那么回滚后这些存在于容器的数据或者一些相关运行状态值就不存在了,对于这种情况,该怎么办?此时需要的就是
StatefulSet(部署有状态的多副本应用)。
StatefulSet
如果通过
ReplicaSet创建多个
Pod副本(其中描述了关联到特定持久卷声明的数据卷),那么这些副本都将共享这个持久卷声明的数据卷。
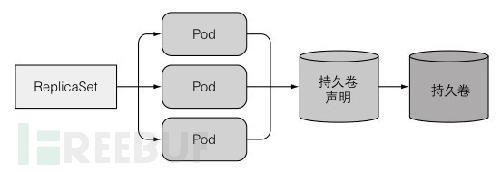
那如何运行一个pod的多个副本,让每个pod都有独立的存储卷呢?对于这个问题,之前学习的相关知识都不能提供比较好的解决方案。
k8s提供了
Statefulset资源来运行这类Pod,它是专门定制的一类应用,这类应用中每一个实例都是不可替代的个体,都拥有稳定的名字和状态。
对于有状态的应用(实例之间有不对等的关系或者依赖外部数据),主要需要对以下两种类型的状态进行复刻:
存储状态:应用的多个实例分别绑定了不同的存储数据,也就是让每个Pod都有自己独立的存储卷
拓扑状态:应用的多个实例之间不是完全对等的关系,各个Pod需要按照一定的顺序启动
来自 “ freebuf ”, 原文作者:Pamela@涂鸦智能安全实验室 ;原文链接:https://www.freebuf.com/articles/container/324421.html,如有侵权,请联系管理员删除。

