可观测性建设真正需要的,不是选择阵营,而是建立一条能够从业务现象追溯到应用、运行时、网络和内核的完整证据链。
近年来,市场上出现了一些声音,说 eBPF 是可观测性未来的技术,将逐步取代 APM 探针技术,并且宣称 eBPF 是 “ 零侵入 ” 技术,非常安全可靠。那么真实情况是什么样的呢?我们今天来详细拆解一遍。
TL;DR(太长不看版)
1. eBPF 探针技术和 APM/OTel 探针技术都是可观测性平台不可或缺的优质数据来源,各自都有自己的优势和劣势,并不存在谁取代谁的问题,而是应该在可观测性平台中发挥各自的作用,并融合贯通,为客户提供真正的可观测性价值;
2. eBPF 探针在当前技术的发展阶段,在端到端的全链路追踪、上下文传播和业务语义理解、根因定位及影响分析上还弱于基于 APM/ OTel 的探针技术;
3. 两类探针技术都存在风险, APM/OTel 探针可能影响应用而 eBPF 探针可能影响操作系统,重要的是如何准确和严格地进行探针变更风险评估和部署;
4. 而所谓 eBPF 探针的“零侵入”则看起来更像是一场有意误导的市场营销而非严谨的技术定义 。
两类探针技术的定义
首先我们来明确一下几种可观测性探针技术的定义。
APM 是应用性能管理这一类能力及产品的统称, APM 探针是这类产品的原始数据采集技术,通常是通过自动应用侧埋点技术,与被监控的应用运行在同一个应用进程内。 OpenTelemetry 是一套厂商中立的 API 、 SDK 、语义约定、协议和 Collector 的开源标准和生态, OpenTelemetry 也提供了官方开源的大量应用探针和 SDK 。虽然 APM 探针和 OpenTelemetry 探针并不是完全同一个概念,但在应用侧埋点、自动插桩、 上下文传播和链路数据生产上有很大交集和相似性。为方便讨论,本文把这部分统称为 APM/OTel 探针。
eBPF 则是 Linux 内核提供的可编程机制。程序经过校验后,可以附着到系统调用、内核函数、用户态函数、 tracepoint 和网络事件等位置。 eBPF 可观测性探针产品借此采集网络、系统调用、调度、 I/O ,以及一部分应用协议数据。
这两类方案不存在一条从 “落后”到“先进”的单向阶梯。观测位置不同,所得证据也不同。
现实运维场景的挑战
让我们从一个经常会遇到的日常运维场景开始。一场线上故障发生后,运维人员需要回答一连串的具体问题:问题的根因从哪里开始,该由谁来处理,如何修复,修复后又如何确认业务已经恢复,故障期间哪些业务受影响,影响了多少用户?
及时发现故障并快速完成问题定界,以及更进一层的根因定位,都是可观测性平台基本的能力要求。而在这些层级中, APM/OTel 探针和 eBPF 探针在其中发挥着不同的作用。
问题发现
故障首先要做到的是 “第一时间被发现”。这一阶段,更关注的是系统是否出现异常,通常通过指标或日志的异常告警来达成,因此需要覆盖足够广的被观测实体,以尽量减少故障漏报。 APM/OTel 探针长期运行于应用内部,能够持续采集接口响应时间、错误率、吞吐量、数据库调用、缓存访问、消息队列等性能指标,甚至业务交易金额或交易量等业务指标,并结合 SLI 、 SLO 和告警策略,在用户真正感知之前及时发现业务性能下降或异常波动。而 eBPF 探针则补充了应用之外的可见性,从内核实时获取 CPU 、内存、磁盘 I/O 、网络延迟、 TCP 重传、 DNS 、系统调用等底层运行状态。当应用指标和系统指标同时出现异常时,平台不仅能够更早发现问题,还能够判断异常更可能来自应用逻辑还是基础设施层面,实现从业务到系统的全栈监测,让故障发现更加及时、更加全面。
快速定界
发现异常之后,更重要的是尽快确认 “问题到底发生在哪里”。这一阶段的目标不是立即找到根因,而是尽快缩小排查范围,确定该由哪个团队来处理故障。 eBPF 探针所提供的监控数据可以快速确定问题是出现在网络层、容器层、进程或端口层面,还是主机系统层,而 APM/OTel 探针的数据可以快速定位是哪个服务、哪个实例或哪个 API 接口出现了延迟或错误。有效结合两类探针的数据,可以快速判断问题属于应用、运行时、中间件、数据库、网络、容器还是操作系统,快速确定需要负责的团队,大幅减少跨团队反复确认和逐层排查的时间。
根因分析
在故障解决和恢复的过程中,特别是故障恢复之后的事后复盘过程中,真正困难的已经不是知道哪里出了问题,而是需要解释 “为什么会出问题”,确定故障的根本原因,并将故障根因及其传播证据链完整地拼接起来。
根因分析需要更深层次的数据支撑。 APM/OTel 探针能够深入应用内部,分析一次请求在各个方法、 SQL 、 RPC 调用上的耗时分布,定位慢 SQL 、线程阻塞、异常堆栈、锁竞争、 GC 停顿、代码热点等应用内部原因。而 eBPF 探针则能够继续向下观察操作系统层面的运行状态,例如 CPU 调度延迟、内核锁竞争、 Page Cache 命中率、文件系统 I/O 等待、 TCP 重传、 Socket 阻塞、 DNS 查询耗时、内核函数执行路径等传统 APM 无法获取的信息。当应用调用链和内核执行链共同构建完整证据链时,平台不仅能够告诉用户“哪里出了问题”,更能够解释问题是如何一步步传播形成最终故障的。
业务及⽤户影响评估
一次技术故障最终可能会影响业务或用户体验,因此故障处理的事后复盘阶段,最后需要回答的是 “故障影响了什么业务,影响了多少用户”。 APM/OTel 探针天然拥有业务上下文,特别是结合全自动的自定义实时应用内埋点技术,能够基于调用链关联订单、支付、登录、搜索等具体业务流程,统计失败请求数量、受影响接口、异常事务以及用户访问情况。并可以通过端到端的 全链路追踪能力,进一步分析不同地区、运营商、租户、渠道或版本的影响范围,帮助业务部门快速评估损失。而 eBPF 探针虽然也可以通过对流量包的解析识别出一部分的业务信息,例如请求头或请求体内全局统一流水号,但是由于缺乏应用内部丰富的上下文信息和有效的上下文传播方案,因此无法真正实现从技术指标到业务价值的完整闭环。
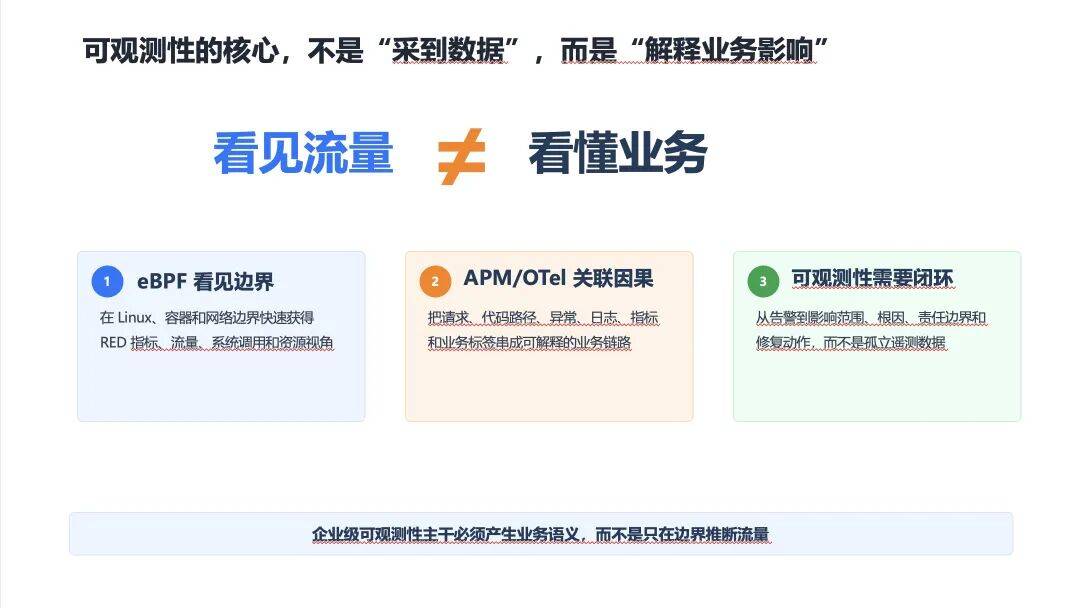
图 1 :看⻅流量与看懂业务不是⼀回事
围绕 APM 、 OpenTelemetry 与 eBPF 探针技术在过去几年存在很多争论,有人把应用探针说成笨重的旧技术,也有人把 eBPF 当成只能看网络的辅助工具。而这些争论恰恰绕开了可观测性的最终目的:“服务于业务,以业务和用户体验为中心”。更理性的结论是: APM/OTel 探针和 eBPF 探针处在不同的观测位置,擅长回答不同问题。成熟的可观测性体系需要把两类技术接起来,而不是选一边站队。
APM/OTel 靠近业务,eBPF 靠近系统边界
应用侧的 APM/OTel 探针运行在进程内,或者在应用 启动、构建和发布环节接入。它理解框架、库、异常对象、线程或协程上下文,也能读取开发者明确写入的业务属性。一次支付 失败可以带上订单阶段、支付渠道、错误类型和用户分群。自定义的业务埋点 Span 还能标出“库存锁定”“风控拒绝”“优惠计算”这类只存在于业务代码里的动作。
eBPF 从内核、网络和用户态边界观察系统。它不要求业务团队先改代码,适合快速发现服务、建立 RED 指标、梳理网络依赖,也能看到 TCP 、 DNS 、调度、 I/O 和未插桩进程。对于闭源组件、遗留服务、语言栈混杂的 Kubernetes 集群,这种覆盖能力很有价值。
它们的差别可以简化成一句话: APM/OTel 更擅长解释“这次请求在业务里经历了什么”, eBPF 更擅长说明“这台机器和这段通信实际发生了什么”。
这不是高下之分。只看应用层,可能错过网络抖动、 DNS 延迟和内核资源争用;只看边界事件,又可能知道某个接口慢,却不知道慢的是登录、下单还是后台对账。
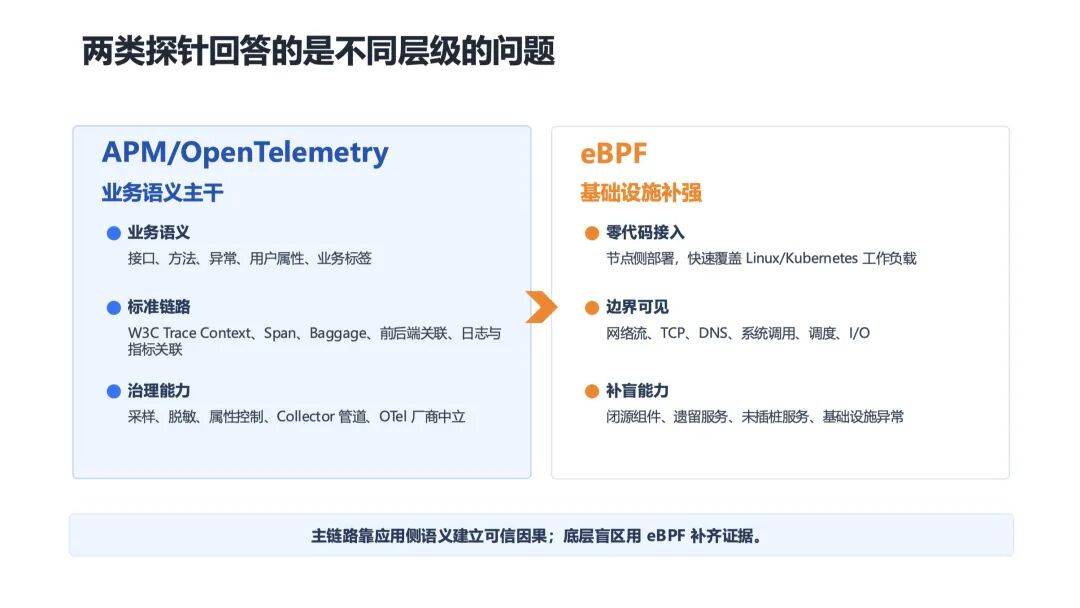
图 2 :应⽤侧探针建⽴语义主⼲
eBPF 补⻬基础设施证据
为什么 eBPF 很难独自承担核心链路追踪
在可观测性的核心能力中,分布式追踪技术是最为重要的可观测性技术之一,而 APM/OTel 探针技术正是这项技术当前最成熟、语义最完整的主要技术路线,通过该技术才能真正实现将指标、链路追踪和日志有机地关联和利用起来。反观 eBPF 探针技术,虽然也可以实现一定程度的分布式追踪,但是有很多的限制。希望把网络连接或系统调用还原成可信业务链路,要跨过几道很现实的坎。
首先是异步模型。异步模型仍然是 eBPF 链路关联面临的重要难点。当前部分实现已经针对 Go goroutine 、 Node.js async hooks 、 Java 线程池和 Python asyncio 等常见运行时增加了专门的关联机制,但在自定义调度器、任意框架队列、后台任务以及多路复用场景中,仍可能无法稳定恢复应用框架维护的逻辑上下文。因此, eBPF 可以实现一定程度的上下文传播和分布式追踪,但尚难在所有运行时和协议场景中做到稳定、完整和无条件覆盖。
其次是业务语义。订单号、租户、风控结果、功能开关和业务阶段不会凭空出现在内核事件中。 eBPF 探针技术可以根据协议、端口、进程和符号推断一部分含义,推断仍不等于应用明确提供的事实。
最后是加密通信与上下文传播。 分布式追踪需要在服务之间持续传递 W3C Trace Context (如 traceparent ),才能将一次跨服务请求关联为同一条 Trace 。在 TLS 加密环境下,这些 Header 会随应用数据一起被加密,网络侧既无法直接读取,也无法安全地修改。因此,仅依赖网络流量分析,很难完成完整的 Trace Context 注入与传播。
为了突破这一限制,部分基于 eBPF 的实现(例如 OpenTelemetry OBI )会在应用进程内部介入,在数据进入 TLS 加密之前或解密之后,通过 uprobe 等机制定位运行时函数,并利用 bpf_probe_write_user 将 Trace Context 写入用户态内存,再由应用继续完成后续通信。 OpenTelemetry OBI 官方文档也明确指出,该能力依赖 bpf_probe_write_user ,并受到 Linux capability 、内核版本以及 Lockdown 模式等因素限制。
这说明, TLS 并没有让 eBPF 探针技术无法实现上下文传播,而是改变了实现路径。为了获得与 APM 类似的传播能力, eBPF 已经不能仅依赖网络旁路观测,而需要主动介入应用进程的运行过程。这也解释了为什么 OpenTelemetry 同时保留零代码和代码埋点两条路线。官方文档明确写着,两种方式可以同时使用。自动采集解决覆盖问题,代码埋点补充应用特有的语义,二者并不冲突。
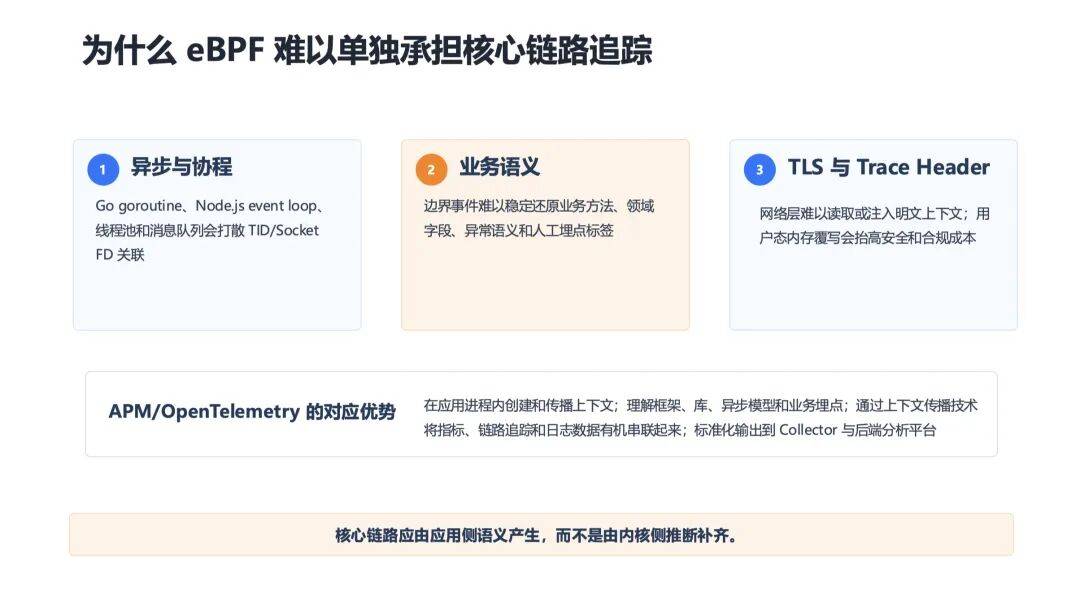
图 3 : eBPF 技术处理核⼼链路追踪的技术难题
同时,这也是 eBPF 探针技术在复杂应用场景下越来越多采用 “ 运行时协作 ”而不仅仅是 “ 网络旁路分析 ”的重要原因。这就引出了我们下面要讨论的最具争议的一个问题:“什么是零侵入?”
“非侵入”到底指什么
很多争议其实都源于一个词被反复换义。
在应用可观测性领域, “零代码( Zero-Code )” 和 “非侵入( Non-Intrusive )” 本来就是两个不同的概念,却经常被混为一谈。
零代码强调的是开发方式 ——无需修改业务源码即可接入可观测能力。 OpenTelemetry 对 Zero-Code 的定义十分明确,它通常通过 Java Agent 、 Hook 、 Python Monkey Patching 、 eBPF 等自动插桩技术完成接入。虽然开发者无需修改一行业务代码,但运行时仍然会发生字节码增强、函数 Hook 、 Monkey Patch 或 eBPF 挂载等动作。因此,零代码从来不意味着零运行时介入,更不意味着应用的执行过程没有发生任何变化。
而传统 Agentless 或黑盒监控所说的非侵入,强调的是另一层含义——目标侧无需部署新的第三方探针,仅依赖网络流量、系统已有接口或外部采集能力完成观测。这种方式通常对目标环境的介入更少,但相应地,可获得的信息也更加有限,观测深度往往不及应用内部插桩。
真正容易引起误解的,正是这两种概念之间的偷换。营销宣传往往先利用 “ 无需修改业务源码 ”证明产品实现了 Zero-Code ,随后又将这一结论进一步扩展为 “ 完全非侵入 ”、“不会改变执行过程”、“无需特殊权限”甚至 “ 没有额外运行风险 ”。然而,这些结论之间并不存在必然的逻辑关系。“不修改源码”只能说明开发方式足够友好,并不能证明运行时没有介入,更不能证明不存在性能开销、权限要求或执行路径变化。
从目前 eBPF 技术的实现来看,真正接近或类似传统 Agentless 或黑盒监控意义上 “ 零侵入 ”的,主要还是网络层和基础系统层的旁路观测能力,例如网络连接、 TCP 状态、流量统计以及部分协议分析。这类能力主要依赖内核事件和网络数据,不需要主动介入应用运行时。然而,当 eBPF 希望进一步获得应用级可观测能力时,情况就发生了变化。无论是 TLS 流量解析、 Trace Context 注入与传播、持续代码剖析( Continuous Profiling ),还是用户态函数、内核函数和系统调用观测,都需要借助 uprobe 、 kprobe 、 USDT 、 perf event 、运行时符号解析甚至用户态内存读写等机制参与程序执行。不同的应用级观测能力会使用不同的运行时机制。例如, TLS 明文观测和部分库级上下文传播可能依赖 uprobe 与用户态内存访问;持续剖析通常依赖 perf event 和栈回溯;内核函数与系统调用观测则可能使用 tracepoint 、 fentry/fexit 或 kprobe 。这些机制都会增加一定的运行时工作,但介入位置、权限要求和对目标程序的影响并不相同。也就是说,当前 eBPF 的发展路径实际上呈现出一个连续的能力谱系:观测能力越深入应用内部,对运行时的参与程度通常也越高。真正能够完全依靠 “ 站在程序外面观察 ”完成的应用级可观测能力,其实并不多。
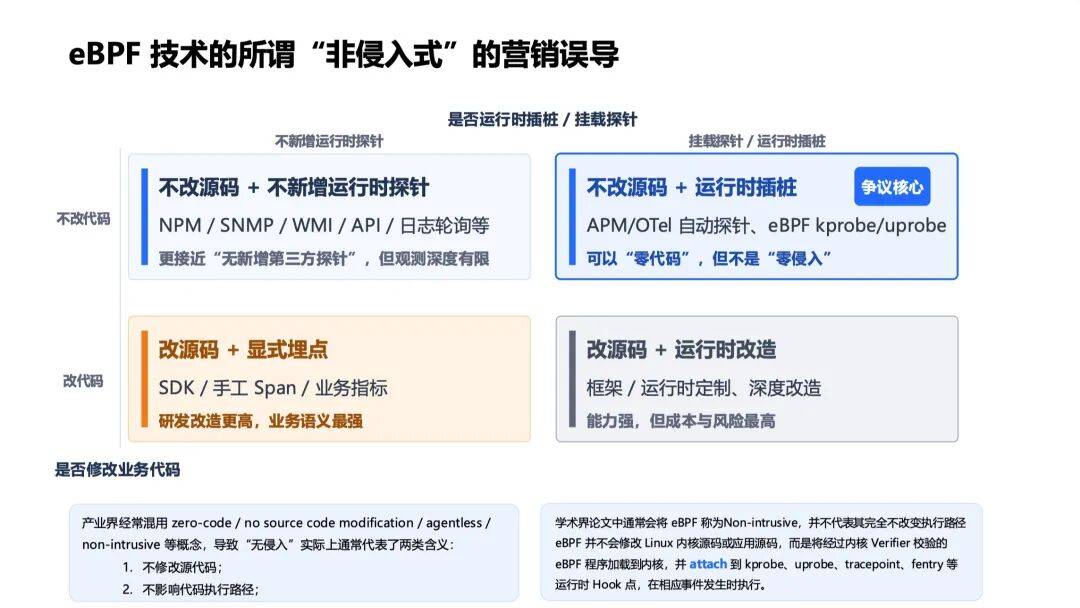
图 4 : “ 是否改源码 ” 和 “ 是否增加运⾏时探针 ”
是两条独⽴技术路径
因此,描述 eBPF 可观测性时,更准确的词是“零代码接入”“无需修改应用源码”或“节点侧自动观测”。如果一定要使用“零侵入”,就必须补全限定条件,例如“对应用源码和发布包零改动”。不加限定的“零侵入”容易误导采购者和用户。
三句不能放过的营销谎言
批评营销误导,并不等于否定 eBPF 的技术价值。 eBPF 在网络观测、系统分析、持续剖析和自动化可观测性方面都带来了重要进步。真正需要警惕的,是把一项有边界、有成本、有前提条件的技术,包装成“完全无侵入、绝对无风险、可以取代一切”的万 能方案。
下面三类说法,并不是技术路线之争,而是可以被官方文档、公开实现和实际案例直接否定的过度承诺。
1.“eBPF 完全不进⼊运⾏时,也不改变执⾏路径 ”
这是对 eBPF 工作原理的错误描述。
eBPF 程序需要先被加载到内核,并挂载到 kprobe 、 uprobe 、 tracepoint 、 TC 、 XDP 、 perf event 等挂载点或 Hook 。当对应事件发生时,内核会额外执行相关的 eBPF 程序。换句话说,原本经过这些事件点的执行过程,现在增加了一段观测逻辑。这意味着系统执行了额外工作,并不等同于业务程序的控制流或计算结果一定发生改变;具体影响取决于挂载位置、程序类型和所使用的 helper 。
这并不意味着 eBPF 会修改应用源码,也不意味着它一定会重写应用二进制。大多数可观测性产品中的 eBPF 程序也以读取、统计和采集数据为主。但“不修改源码”与“不介入运行过程”是两件不同的事。
部分 eBPF helper 还具备更强的能力,例如写入用户态内存、在受支持的特定内核函数和程序类型上覆盖返回值,或者改变网络数据包的处理路径。可观测性产品未必默认使用这些能力,但这些能力本身足以说明, eBPF 并不是一个永远只能在系统外部被动观察的机制。
更准确的说法应当是:
eBPF 通常不要求修改应用源码,也不一定需要修改应用二进制,但它会在系统运行期间挂载探针,并在特定事件发生时执行额外的观测逻辑。
因此, eBPF 可以是 Zero-Code ,却不能因此被简单等同于“零运行时介入”或“完全不改变执行过程”。
2.“eBPF 零开销、零风险,装上就不会影响业务 ”
这同样是不成立的。
任何可观测性采集都会消耗资源。 eBPF 也需要占用 CPU 、内存、 BPF Map 、 ring buffer 、 perf buffer 以及数据导出带宽。合理设计的 eBPF 程序可以把开销控制得很低,但“低开销”不等于“零开销”,更不意味着开销可以不经过测试和评估。
风险也不仅来自性能。 eBPF 的运行依赖 Linux 内核版本、 BTF 信息、内核符号、 verifier 行为以及主机安全策略。不同能力还可能需要 CAP_BPF 、 CAP_PERFMON 、 CAP_SYS_PTRACE 、 CAP_NET_ADMIN ,某些环境下甚至仍需 CAP_SYS_ADMIN 或特权容器。这些权限并不是无关紧要的安装细节,而是部署方案必须评估的安全边界。
兼容性问题也不是理论上的假设。 Datadog 在官方工程博客 “ Hardening eBPF for Runtime Security ” 中公开分享过一个真实案例:其 Workload Protection 产品和 Cilium 都使用 eBPF TC Classifier ( SCHED_CLS )挂载到 Linux Traffic Control ( TC )的 clsact hook 。由于双方在相同内核资源上的 filter 管理发生竞态, Datadog Agent 在资源清理过程中误删了 Cilium 的 TC filter ,最终导致部分 Pod 网络连接中断。 Datadog 将这一案例总结为 “多个基于 eBPF 的工具共享内核资源时可能发生冲突”,并据此调整了默认优先级、资源清理策略以及与 Cilium 的兼容方案。
这个案例不能被扩大解释为 “所有 eBPF 产品都会导致断网”,也不能证明 Datadog 或 Cilium 本身必然存在问题;但它足以说明,当多个内核级组件共享并修改同一个网络挂载点时,确实可能产生真实的生产兼容性风险。因此,“ eBPF 绝不会影响生产”并不是一个经得起事实检验的承诺。
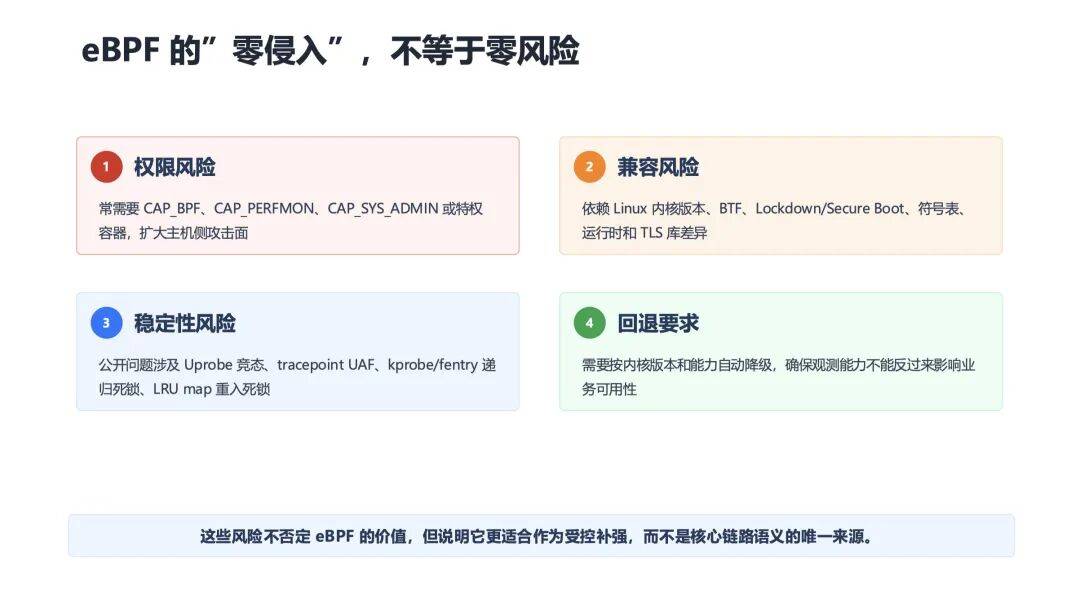
图 5 :部署 eBPF 探针,权限、兼容性、稳定性
和回退能⼒都应进⼊变更评审
安全边界同样不能被 “零侵入”三个字掩盖。 USENIX Security 2023 的研究展示了共享内核容器环境中, eBPF 权限可能带来的跨容器攻击面; OSDI 2024 的研究则进一步说明, eBPF verifier 本身也是需要持续验证和加固的重要安全边界。
这些研究针对的是特定威胁模型,不能被夸张为 “只要使用 eBPF 就一定会被攻击”。但它们支持一个非常朴素的工程结论:
任何高权限、内核级组件,都必须遵循最小权限、版本基线、安全审计、灰度发布和快速回退原则,不能因为宣传材料写了“零侵入”,就跳过正常的安全和变更评审。
3.“eBPF 可以完整取代 APM”
这仍然是一个错误结论,因为它把 “能够采集一些相同的数据”,偷换成了“拥有相同的语义理解能力”。
eBPF 确实可以在不修改业务源码的情况下采集大量指标、调用信息和 Trace 数据,而且能力边界还在快速扩展。 OpenTelemetry OBI 已经能够覆盖 HTTP 、 gRPC 、多种数据库和消息系统。这些进展非常重要,也说明 eBPF 已经不只是网络流量监控工具。
但覆盖更多协议,并不等于能够完整理解应用。
eBPF 的应用级观测通常依赖协议格式、运行时版本、符号信息、连接建立时机、 TLS 实现方式以及载荷是否可解析。 OpenTelemetry OBI 的兼容性文档也明确列出了 HTTP/2 上下文传播、既有长连接、压缩载荷、预先建立连接等场景中的限制。
更重要的是,很多业务语义并不存在于内核事件或网络协议中。例如:
- 当前请求属于哪个业务流程;
- 订单、租户、用户和渠道分别是什么;
- 某段代码为什么主动创建一个 Span;
- 某个业务方法返回值或返回对象的状态变化意味着成功还是失败;
- 哪些属性需要被人工标记和关联。
这些信息往往只有应用本身知道,仍然需要 APM 探针、 OpenTelemetry SDK 、自动插桩或人工埋点提供。
因此, eBPF 可以补充甚至替代一部分传统探针能力,却很难完整取代应用侧可观测性。它更擅长提供内核、网络、运行时和未插桩组件的证据; APM 和 OpenTelemetry 则更擅长提供调用链、应用上下文和业务语义。
反过来说, “有了 APM 就不需要 eBPF ”同样不成立。应用探针很难完整覆盖内核调度、网络路径、系统调用、未插桩进程以及底层资源竞争等信息。
更符合技术现实的判断是:
eBPF、APM 和 OpenTelemetry 之间不是简单的替代关系,而是能力边界不断重叠、但观测视角仍然不同的互补关系。把任何一方宣传成万 能替代品,都是在销售一个并不存在的简单答案。
两类探针都有风险,只是风险落点和故障半径不同
客观比较 eBPF 与 APM/OTel 探针,不能只讨论 eBPF 的风险,而把应用探针描述成天然安全。任何能够提供深度可观测性的探针,都会在系统运行过程中增加额外工作,只是介入的位置、使用的机制以及可能造成的影响不同。
APM/OTel 自动探针运行在应用进程内部。为了完成一次请求的追踪,它需要创建和结束 Span 、提取并传播 Trace Context 、采集属性与异常、执行采样、聚合数据并将其批量导出。这些操作都会消耗 CPU 、内存和网络资源。字节码增强、 Monkey Patching 、框架插件以及语言运行时之间也可能出现版本兼容或执行顺序问题。当采样比例过高、属性数量失控、插件配置不当、导出端阻塞或组件适配冲突时,应用探针可能增加响应延迟和内存占用,严重时甚至拖慢对应服务,最严重的情况下可能会导致应用程序出错甚至崩溃。
eBPF 探针同样会增加运行时工作,但风险更多集中在操作系统和共享基础设施层。它需要加载内核程序、挂载 Hook 、维护 BPF Map 和缓冲区,并可能依赖内核版本、 BTF 、符号、权限、安全策略以及 TC 、 CNI 等网络组件。若出现程序缺陷、资源耗尽或挂载点冲突,影响可能不只停留在一个进程,而是扩展到同一节点上的多个容器、工作负载,甚至网络路径,最严重的情况下可能导致这个操作系统内核崩溃,整个主机或节点挂掉。
因此,两类探针最值得比较的,并不是谁 “有风险”、谁“没有风险”,而是 风险首先出现在哪里,以及故障可能扩散到多大范围 。
APM/OTel 探针的问题通常首先发生在应用进程、语言运行时或单个服务中,常见影响范围是某个实例、 Deployment ,或者使用同一语言和插件版本的一批工作负载。 eBPF 探针的问题则更可能发生在节点、内核能力、网络 Hook 、 TC/CNI 或安全权限边界上,其故障半径可能沿宿主机或网络层向多个工作负载扩散。
这并不意味着 eBPF 必然比应用探针更危险,也不意味着 APM/OTel 探针天然安全。它真正说明的是:两类探针需要采用不同的风险治理方式。应用探针更应关注语言版本、框架兼容性、采样策略和单服务性能回退; eBPF 探针则更应关注内核与发行版兼容矩阵、节点级灰度、权限控制、 CNI/TC 共存测试以及快速卸载和回退能力。
归根结底,探针风险不能只看平均开销,还要同时评估介入位置、共享资源、故障传播路径和回退难度。只有把这些因素纳入变更评审,所谓 “低侵入”才是可验证的工程结论,而不是一句营销承诺。
各自的生态位在哪里
需要快速覆盖 Linux/Kubernetes 工作负载、观察网络和系统资源、发现未插桩服务,或排查 DNS 、 TCP 、调度和 I/O 问题时, eBPF 往往是合适的入口。它也适用于闭源软件、遗留系统和多语言环境,因为接入不依赖各应用团队同步改造。
需要可信的跨服务链路、应用异常、方法与框架语义、用户上下文、业务标签和治理闭环时,应以 APM/OTel 应用侧探针或 SDK 为主。自动插桩可先覆盖常用框架,再通过少量手工 Span 和指标补足核心业务步骤。
当目标设备不适合安装第三方探针,或只需要可用性、资产、基础指标或网络数据包时, SNMP 、 API 、日志和 NPM 等被动流量依然有很价值。可观测性并不是越靠近内核越高级,也不是埋点越多越完整。选型的关键,是问题发生在哪一层、需要多深的语义,以及团队愿意承担哪类变更风险。
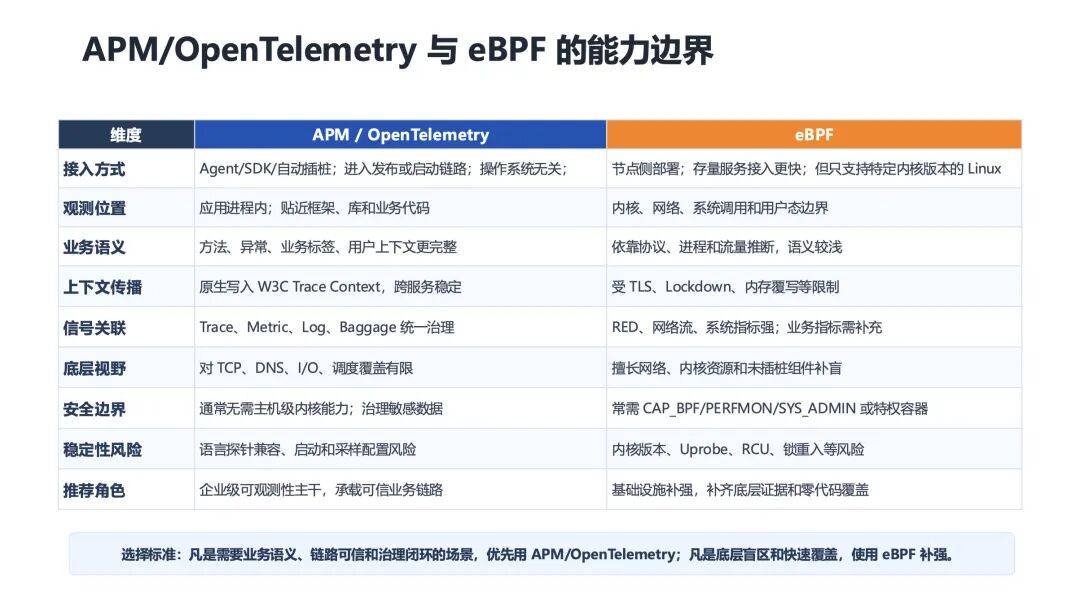
图 6 : APM/OTel 探针与 eBPF 探针技术
的能⼒边界
端到端规划和建设全面覆盖的可观测性平台
真正的融合,不是把不同来源的数据汇聚到一起,而是让它们描述同一件事情。要做到这一点,必须建立一条稳定的关联主线。应用侧通过 W3C Trace Context 、 Trace ID 、 Resource Attributes 和业务标识建立完整的调用语义; eBPF 提供节点、进程、 Pod 、网络、内核等运行时证据;日志、指标、真实用户监测( RUM )和 Profiling 再围绕同一组实体、上下文和 Trace 建立关联。 OpenTelemetry Collector 可以作为统一的数据接收、处理和导出管道,但数据进入同一个 Collector ,并不意味着语义已经统一,更不代表能够完成自动关联。
落地时可以遵循 “覆盖优先、语义增强、分层治理”的思路:
1. 优先建立标准端到端链路覆盖 。利用 APM/OTel 自动探针建立标准调用链,同时结合 RUM 技术完成端到端的完整覆盖,并在订单、支付、风控等核心业务路径上可选补充少量自动埋点或人工 Span 和业务属性,完善应用语义。
2. 再补充网络盲点覆盖。 利用 eBPF 技术覆盖节点、网络、服务发现和基础 RED 指标,覆盖部分闭源或无法安装软件探针的遗留系统,并消除系统和基础设施的观测盲区。
3. 分别管理生命周期 。 eBPF 重点维护内核版本、 Secure Boot、 Capability、BTF、 CNI 的兼容矩阵;应用探针重点维护语言、运行时、框架和 Agent 的兼容矩阵,避免相互耦合。
4. 按风险半径灰度发布 。 eBPF 以节点池为灰度单位逐步启用;应用探针以服务、 Deployment 或应用实例为灰度单位逐步推广,使发布范围与潜在影响范围保持一致。
5. 持续观测探针自身 。 将探针也纳入可观测体系,持续监控 CPU 、内存、事件丢失、 PF Map 内存占用、条目数、更新失败情况和队列积压、导出失败率和采样效果,并始终保留一键停用和快速回退能力。
6. 能力按需开启 。 将网络 TC 、 TLS 场景下的 Trace Context 传播或写入、深度 uprobe 、高频事件采集等高风险能力与基础观测解耦,通过独立开关按需启用,而不是默认全部开启。
结语
eBPF 为可观测性补上了过去难以低成本获取的底层视角,尤其适合云原生、遗留系统和多语言环境。 APM 与 OpenTelemetry 应用侧探针则更贴近应用和业务语义,能够把请求、异常、日志、指标与业务属性串联成可解释的关联证据链。
两类技术都不是零成本,也都不是万 能方案。把它们简单对立起来,团队往往会在两个方向上付出代价:要么采集了大量网络和内核数据,却无法解释业务为何受影响;要么拥有完整的应用调用链,却看不到故障在网络、操作系统和未插桩组件中的真实来源。
因此,对 eBPF 厂商营销最基本的要求并不苛刻:明确列出所需权限和支持范围,说明性能测试的环境与条件,如实披露已知冲突,并提供可执行的灰度方案和回退路径。如果一边挂载内核及用户态探针、申请主机级权限,一边仍宣称“绝对零侵入、零风险、可以完全替代应用探针”,那就不再只是术语定义不同,而是可能误导生产选型和变更决策的虚假承诺。
可观测性建设真正需要的,不是选择阵营,而是建立一条能够从业务现象追溯到应用、运行时、网络和内核的完整证据链。
参考资料:
1. [OpenTelemetry:Zero-code instrumentation](https://opentelemetry.io/docs/concepts/instrumentation/zero-code/)
2. [OpenTelemetry:Instrumentation](https://opentelemetry.io/docs/concepts/instrumentation/)
3. [OpenTelemetry:Library](https://opentelemetry.io/docs/concepts/instrumentation/libraries/)
4. [eBPF.io:What is eBPF?](https://ebpf.io/what-is-ebpf/)
5. [OpenTelemetry OBI:Security, permissions, and capabilities](https://opentelemetry.io/docs/zero-code/obi/security/)
6. [OpenTelemetry OBI:Distributed traces and context propagation](https://opentelemetry.io/docs/zero-code/obi/distributed-traces/)
7. [OpenTelemetry OBI:Instrumentation compatibility](https://opentelemetry.io/docs/zero-code/obi/configure/export-data/)
8. [Linux capabilities(7)](https://man7.org/linux/man-pages/man7/capabilities.7.html)
9. [Datadog:Troubleshooting Workload Protection](https://docs.datadoghq.com/security/workload_protection/troubleshooting/threats/)
10. [Datadog: Hardening eBPF for runtime security: Lessons from Datadog Workload Protection](https://www.datadoghq.com/blog/engineering/ebpf-workload-protection-lessons/)
11. [USENIX Security 2023:Cross Container Attacks: The Bewildered eBPF on Clouds](https://www.usenix.org/conference/usenixsecurity23/presentation/he)
12. [OSDI 2024:Validating the eBPF Verifier via State Embedding](https://www.usenix.org/system/files/osdi24-sun-hao.pdf)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31545808/viewspace-3177266/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 向AI-Native跃迁,天翼云TeleDB重新定义数据底座
- 从Neoverse CSS N4到AGI CPU:Arm云AI重构智能体时代基础设施
- 探展2026华为坤灵新品发布会智能医疗展台:不堆设备,只解决问题
- 当 Agent 成为数据库的主要用户,数据底座该如何重写?
- Agent-Native是这个时代的“必修课”
- 应对Agent“未知”,腾讯云数据库解读AI原生数据库“变道”逻辑
- 中国移动改革前沿:HaishanDB打造AI时代数据底座
- 拆解OceanBase AI湖库,打造Agent友好的数据基础设施
- 金篆信科屠要峰:核心筑基稳生存,智融双向拓发展
- 性能硬实力,AI新底座:达梦数据库一体机进化之路
