在数据分析业务中,经常要把Excel 文件数据结构化解析以后再进行计算或导入关系数据库,但许多 Excel 文件的格式并不规整,而且文件结构也多种多样,导致编程进行结构化的工作量会比较大,而且很难通用,每次都要针对文件格式进行分析后再进行开发。
本文将介绍如何进行各种格式的 Excel 文件结构化解析,如普通行式、复杂表头、自由格式、交叉表、主子表、大文件等,并提供用 esProc SPL 编写的代码示例。 esProc 是专业的数据计算引擎,其采用的 SPL 中有完善的 Excel 文件处理函数,进行结构化解析及后续的计算、入库等操作非常方便。
1.普通行式
这是一种最简单的文件格式,文件中每行都是一条数据记录,更常见的是第一行是列标题。
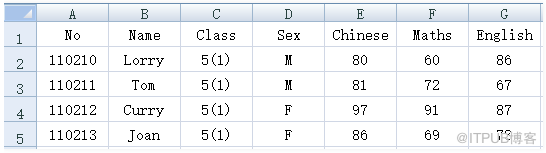
示例:在学生成绩文件scores.xlsx 中,查询各班语文平均成绩。部分数据如下图:
esProc SPL
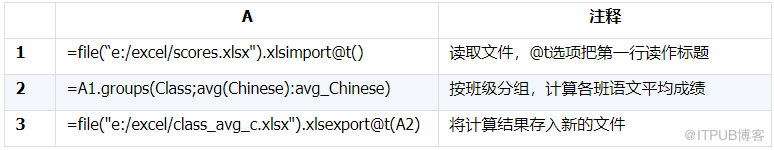
脚本如下:
2.复杂表头
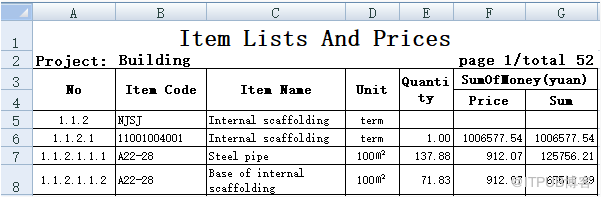
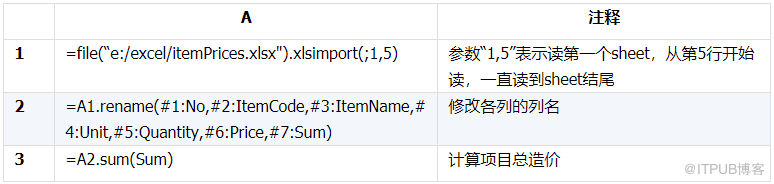
多数时候,Excel 文件的表头格式并不简单,往往是由多行构成的,比如有表标题、项目名称、填表人、填写日期、页码等信息。解析这种格式的文件时,需要跳过复杂的表头,指定从数据行的位置开始读取,然后指定结构化后的数据各列的列名。
示例:在项目造价文件itemPrices.xlsx 中,计算项目总造价,部分数据如下图:
esProc SPL 脚本如下:
3.自由格式
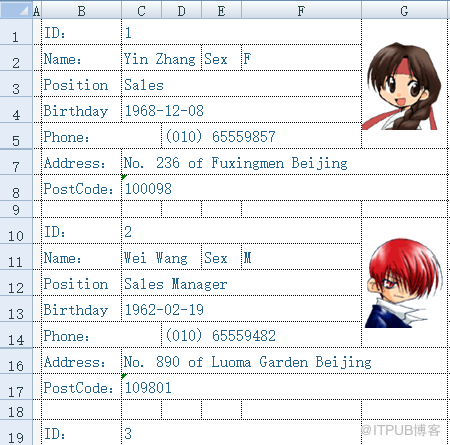
一条数据记录分散在多行,字段列值单元格紧跟在列名单元格后面或下面,可能有跨列或跨行的合并单元格。但每条记录所占的行数以及对应行结构是相同的。循环读取时要以每条记录所占行数为单位组成一条记录。
示例:把自由格式的员工信息文件employee.xlsx 存入到数据库表 employee 中,部分数据如下图:
esProc SPL 脚本如下:
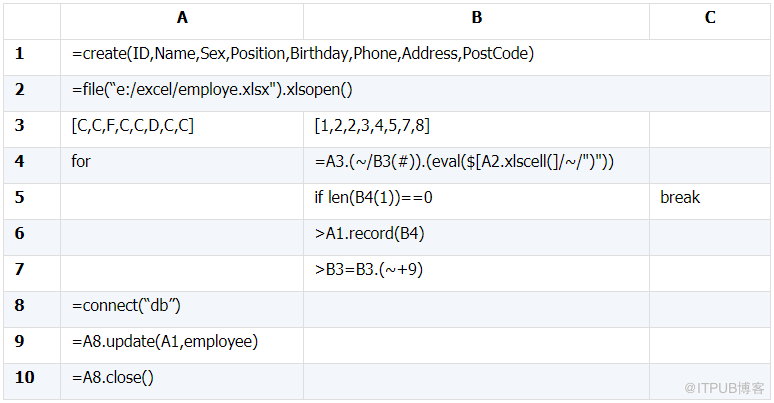
A1 创建列名为 “ID 、 Name 、 Sex 、 Position 、 Birthday 、 Phone 、 Address 、 PostCode” 的空序表
A2 打开 Excel 数据文件
A3 定义雇员信息所在单元格列号序列
B3 定义雇员信息所在单元格行号序列
A4 用 for 循环读取每个雇员信息
B4 A3.(~/B3(#)) 先算出当前雇员单元格编号序列 , 再读出这些单元格值组成雇员信息序列。第一次循环时为 [C1,C2,F2,C3,C4,D5,C7,C8] ,第二次循环时为 [C10,C11,F11,C12,C13,D14,C16,C17]…… 每次行号加 9 。 $[A2.xlscell(] 与 "A2.xlscell(" 相同,都是表示一个字符串,它的好处是在 IDE 中编写程序时,如果 A2 单元格的编号发生了变化, $[A2.xlscell(] 中的 A2 会自动变化,比如在 A2 前插入了一行,这个表达式就会变成 $[A3.xlscell(] ,而用引号的话,就不会自动变了。
B5 判断雇员 ID 值是否为空,为空则退出循环,结束读数
B6 将一条雇员信息存入 A1 序表尾
B7 让雇员信息的行号序列都加上 9 ,读取下一条雇员信息
A8-A10 连接数据库,将雇员信息存入数据库表 employee ,关闭数据库
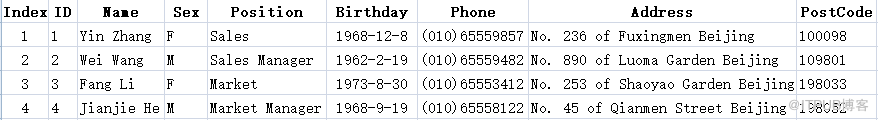
读取出来的A1 单元格数据如下图所示:
4.交叉表
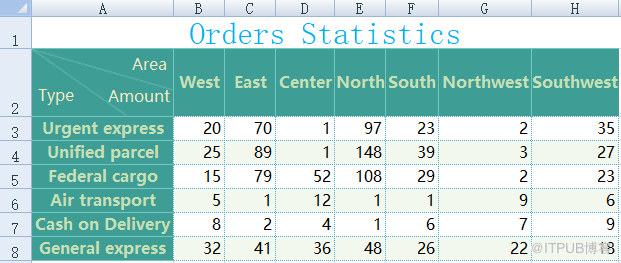
交叉表是统计学中常见的一种矩阵式表格,可以清晰地表达两个变量间的数量关系。交叉表数据逐行读入后,需要以某个列变量为基准,另一个变量及交叉值进行行转置;或者以某个行变量为基准,另一个变量及交叉值进行列转置。
示例:将订单地区与货运方式交叉表cross.xlsx 文件解析成结构化数据,文件数据如下图所示。
esProc SPL 脚本如下:
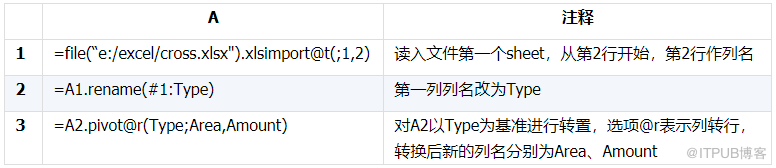
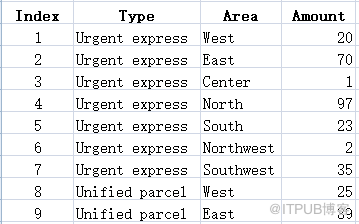
A3
格的部分数据如下图所示:
5. 主子表
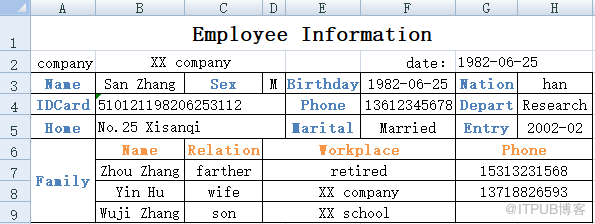
每个sheet 是一条主表记录,同时 sheet 中也包含 N 条子表记录。文件中有多少主表记录,就有多少个 sheet 。对这种主子表结构的数据,需要创建两个数据表分别保存主表和子表的记录。
示例:在员工信息登记表文件staff.xlsx 中,每个 sheet 有员工信息及他的家庭成员信息,请将员工信息及家庭成员信息分别解析成两个结构化数据表。其中一个 sheet 如下图:
esProc SPL 脚本如下:
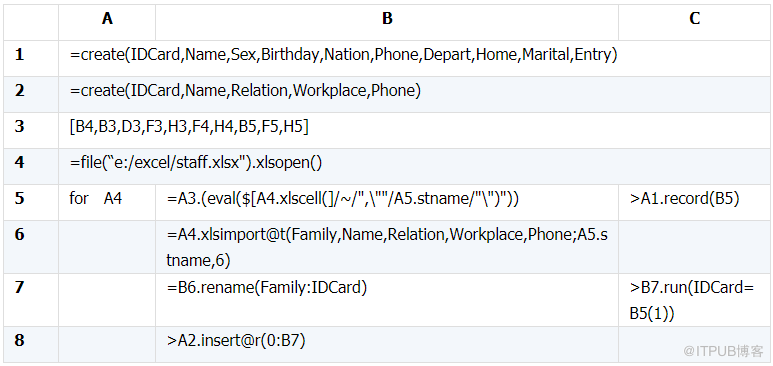
A1 创建列名分别为 IDCard 、 Name 、 Sex 、 Birthday 、 Nation 、 Phone 、 Depart 、 Home 、 Marital 、 Entry 的空序表,用于保存主表员工信息
A2 创建列名分别为 IDCard 、 Name 、 Relation 、 Workplace 、 Phone 的空序表,用于保存子表员工家庭成员信息
A3 定义主表员工信息所在单元格序列
A4 打开 Excel 数据文件
A5 循环读取 Excel 文件各 sheet 数据
B5 读取员工信息序列
C5 将 B5 读取的员工信息保存到序表 A1
B6 从第 6 行开始读取员工家庭成员信息,只读指定的 5 列 Family 、 Name 、 Relation 、 Workplace 、 Phone
B7 将 B6 序表的 Family 列改名为 IDCard
C7 为 B7 序表的 IDCard 列赋值为员工信息中的 IDCard
B8 将 B7 中的员工家庭成员信息追加到序表 A2
A1 读到的部分数据如下:

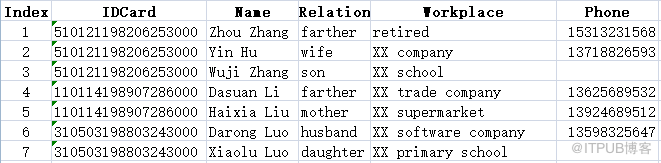
A2 读到的部分数据如下:
6. 大文件
大文件结构化解析及计算的相关原理可参看《 大文件上的结构化数据计算示例 》,那篇文章是以文本文件为例,本文在此以Excel 文件为例再作示范。
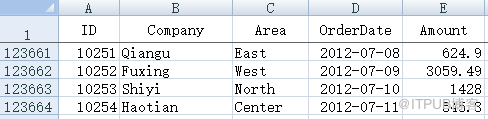
示例:在订单信息大数据文件orders.xlsx 中,统计各地区的订单金额总和。部分数据如下图:
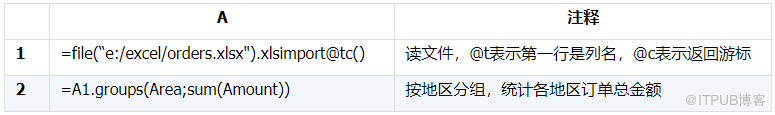
esProc SPL 脚本如下:
《 SPL CookBook 》中有更多敏捷计算示例。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31543054/viewspace-2737041/ ,如需转载,请注明出处,否则将追究法律责任。

