好程序员大数据学习路线 hbase 快速入门 Hbase 简介
1.Hbase 是什么
Apache HBase是Hadoop数据库,一个分布式的、可伸缩的大数据存储。
当您需要对大数据进行随机的、实时的读 /写访问时,请使用Apache HBase。这个项目的目标是在商品硬件的集群上托管非常大的表——数十亿行百万列的列。Apache HBase是一个开源的、分布式的、版本化的、非关系的数据库,它模仿了Google的Bigtable:一个结构化数据的分布式存储系统,就像Bigtable利用Google文件系统提供的分布式数据存储一样,Apache HBase在Hadoop和HDFS上提供了类似于bigtable的功能
1).Hbase 的特点
大:一个表可以有数十亿行,上百万列;
无模式:每行都有一个可排序的主键和任意多的列,列可以根据需要动态的增加,同一张表中不同的行可以有截然不同的列;
面向列:面向列(族)的存储和权限控制,列(族)独立检索;
稀疏:对于空( null)的列,并不占用存储空间,表可以设计的非常稀疏;
数据多版本:每个单元中的数据可以有多个版本,默认情况下版本号自动分配,是单元格插入时的时间戳;
数据类型单一: Hbase中的数据都是字符串,没有类型。
2).Hbase 与关系型数据库的对比
传统行式数据库:
数据是按行存储的
没有索引的查询使用大量 I/O
建立索引和物化视图需要花费大量时间和资源
面向查询的需求,数据库必须被大量膨胀才能满足性能要求
列式数据库 :
数据是按列存储 -每一列单独存放
数据即是索引
指访问查询涉及的列 -大量降低系统I/O
每一列由一个线索来处理 -查询的并发处理
数据类型一致,数据特征相似 -高效压缩
3).Hbase 与 HDFS 的对比
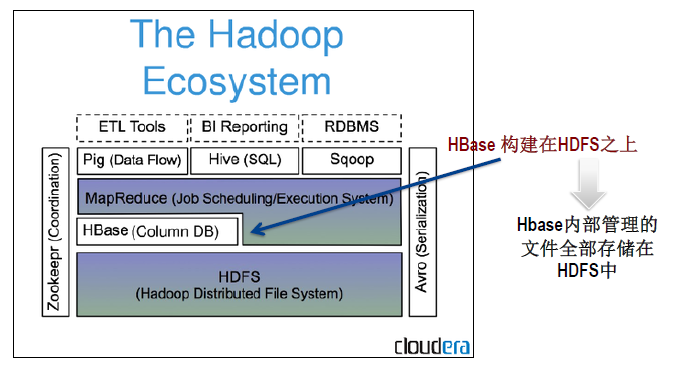
两者都具有良好的容错性和扩展性,都可以扩展到成百上千个节点;
HDFS适合批处理场景
不支持数据随机查找
不适合增量数据处理
不支持数据更新
2.Hbase 的体系结构
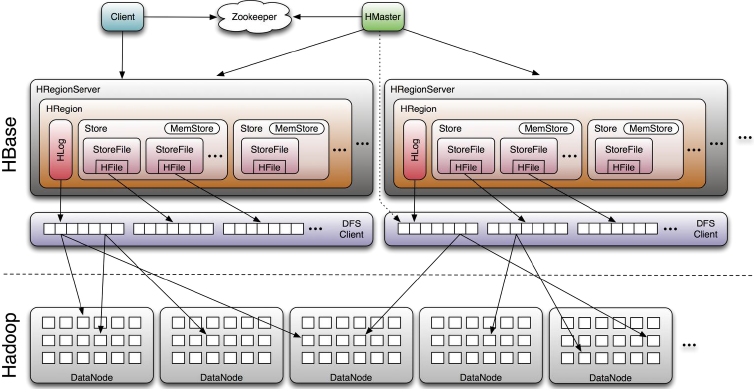
1).Client
HBase Client 使用 HBase的 RPC 机制与 HMaster 和 HRegionServer 进行通信,对于管理类操作, Client与HMaster进行RPC;对于数据读写类操作,Client与HRegionServer进行RPC。
2).Zookeeper
Zookeeper Quorum中除了存储了 -ROOT- 表的地址和 HMaster 的地址, HRegionServer也会把自己以 Ephemeral 方式注册到 Zookeeper中,使得HMaster可以随时感知到各个HRegionServer的健康状态。此外,Zookeeper也避免了HMaster的单点问题。
3).Hmaster
- 管理用户对 Table的增、删、改、查操作;
- 管理 HRegion Server的负载均衡,调整Region分布;
- 在 Region Split后,负责新Region的分配;
- 在 HRegion Server停机后,负责失效HRegion Server 上的Regions迁移。
4).Region
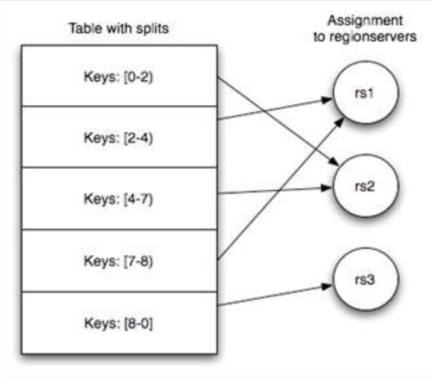
当表的大小超过设置值的时候, HBase 会自动地将表划分为不同的区域,每个区域包含所有行的一个子集。对用户来说,每个表是一堆数据的集合,靠主键来区分。从物理上来说,一张表被拆分成了多块,每一块就是一个 Region。我们用表名 + 开始 / 结束主键,来区分每一个 Region,一个Region会保存一个表里面某段连续的数据,从开始主键到结束主键,一张完整的表格是保存在多个Region上面。
5).HRegion Server
所有的数据库数据一般是保存在 Hadoop HDFS 分布式文件系统上面,用户通过一系列 HRegion Server获取这些数据,一台机器上面一般只运行一个HRegion Server,且每一个区段的HRegion也只会被一个HRegion Server维护。下面是HRegion Server数据存储关系图。
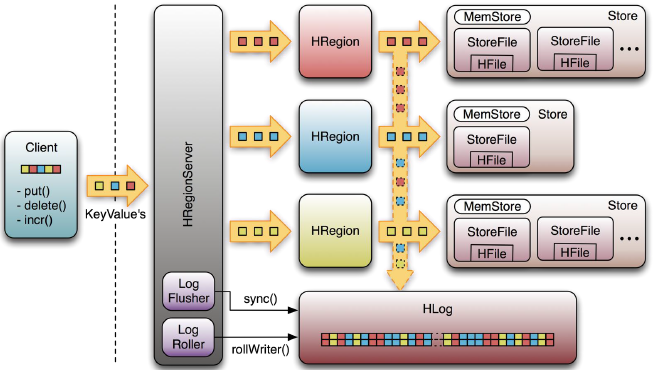
HRegion Server 主要负责响应用户 I/O 请求,向 HDFS文件系统中读写数据,是 HBase 中最核心的模块。
HRegion Server 内部管理了一系列 HRegion对象,每个 HRegion 对应了 Table 中的一个 Region , Region 中由多个 Store 组成。每个 Store 对应了 Table中的一个 Column Family 的存储,可以看出每个 Column Family 其实就是一个集中的存储单元,因此最好将具备共同 IO特性的column放在一个Column Family中,这样最高效。
Store 存储是 HBase存储的核心了,其中由两部分组成,一部分是 MemStore ,一部分是 StoreFiles 。 MemStore 是 Sorted Memory Buffer,用户写入的数据首先会放入MemStore,当MemStore满了以后会Flush成一个 StoreFile (底层实现是 HFile ), 当 StoreFile文件数量增长到一定阈值,会触发 Compact 合并操作,将多个 StoreFiles 合并成一个 StoreFile ,合并过程中会进行版本合并和数据删除,因此可以看出 HBase 其实只有增加数据,所有的更新和删除操作都是在后续的 compact 过程中进行的,这使得用户的写操作只要进入内存中就可以立即返回,保证了 HBase I/O的高性能。当StoreFiles Compact后,会逐步形成越来越大的StoreFile,当单个 StoreFile 大小超过一定阈值后,会触发 Split 操作,同时把当前 Region Split 成 2 个 Region ,父 Region会下线,新Split出的2个孩子Region会被HMaster分配到相应的HRegionServer 上,使得原先1个Region的 压力得以分流到 2个Region上。下图描述了Compaction和Split的过程。

图 Compaction和Split的过程
在理解了上述 HStore的基本原理后,还必须了解一下 HLog 的功能,因为上述的 HStore在系统正常工作的前提下是没有问题的,但是在分布式系统环境中,无法避免系统出错或者宕机,因此一旦HRegion Server意外退出,MemStore中的内存数据将会丢失,这就需要引入HLog了。每个HRegion Server中都有一个HLog对象,HLog是一个实现 Write Ahead Log 的类,在每次用户操作写入 MemStore 的同时,也会写一份数据到 HLog 文件中( HLog文件格式见后续), HLog 文件定期会滚动出新的,并删除旧的文件(已持久化到 StoreFile中的数据)。当 HRegion Server 意外终止后, HMaster 会通过 Zookeeper 感知到, HMaster首先会处理遗留的 HLog 文件,将其中不同 Region 的 Log数据进行拆分,分别放到相应region的目录下,然后再将失效的region重新分配,领取到这些region的HRegion Server在Load Region的过程中,会发现有历史HLog需要处理,因此会 Replay HLog 中的数据到 MemStore中,然后flush到StoreFiles,完成数据恢复。
6).Hbase 的存储格式
HBase中的所有数据文件都存储在Hadoop HDFS文件系统上为例,主要包括上述提出的两种文件类型:HFile, HBase中KeyValue数据的存储格式,HFile是Hadoop的二进制格式文件,实际上StoreFile就是对HFile做了轻量级包装,即StoreFile底层就是HFile。HLog File,HBase中WAL(Write Ahead Log) 的存储格式,物理上是Hadoop的Sequence File。
7).ROOT 表和 META 表
用户表的 Regions元数据被存储在.META.表中,随着Region的增多,.META.表中的数据也会增大,并分裂成多个Regions。为了定位.META.表中各个Regions的位置,把.META.表中所有Regions的元数据保存在-ROOT-表中,最后由ZooKeeper记录-ROOT-表的位置信息。所有客户端访问用户数据前,需要首先访问ZooKeeper获得-ROOT-的位置,然后访问-ROOT-表获得.META.表的位置,最后根据.META.表中的信息确定用户数据存放的位置,如下图所示。

-ROOT-表永远不会被分割,它只有一个Region,这样可以保证最多需要三次跳转就可以定位任意一个Region。为了加快访问速度,.META.表的Regions全部保存在内存中。客户端会将查询过的位置信息缓存起来,且缓存不会主动失效。如果客户端根据缓存信息还访问不到数据,则询问只有相关.META.表的Region服务器,试图获取数据的位置,如果还是失败,则询问-ROOT-表相关的.META.表在哪里。最后,如果前面的信息全部失效,则通过ZooKeeper重新定位Region的信息。所以如果客户端上的缓存全部是失效,则需要进行6次网络来回,才能定位到正确的Region。

8).MapReduce On HBase
在 HBase系统上运行批处理运算,最方便和实用的模型依然是MapReduce,如下图:

HBase Table和Region的关系,比较类似HDFS File和Block的关系,HBase提供了配套的TableInputFormat和TableOutputFormat API,可以方便的将HBase Table作为Hadoop MapReduce的Source和Sink,对于MapReduce Job应用开发人员来说,基本不需要关注HBase系统自身的细节。
3.HBase 数据模型
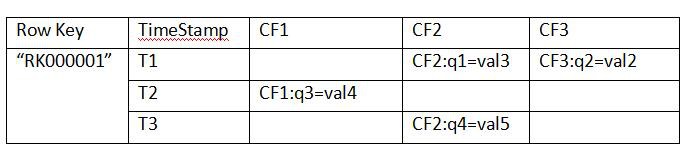
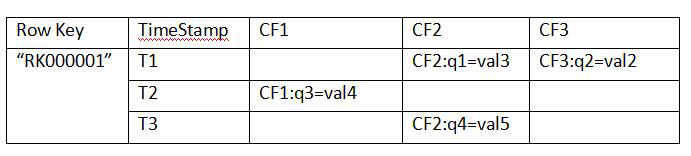
以关系型数据的思维下会感觉,上面的表格是一个 5列4行的数据表格,但是在HBase中这种理解是错误的,其实在HBase中上面的表格只是一行数据;
1).Row Key:
– 决定一行数据的唯一标识
– RowKey是按照字典顺序排序的。
– Row key最多只能存储64k的字节数据。
2).Column Family 列族( CF1 、 CF2 、 CF3 ) & qualifier 列:
– HBase表中的每个列都归属于某个列族,列族必须作为表模式(schema) 定义的一部分预先给出。如create ‘test’, ‘course’;
– 列名以列族作为前缀,每个“列族”都可以有多个列成员(column,每个列族中可以存放几千~上千万个列);如 CF1:q1, CF2:qw,
新的列族成员(列)可以随后按需、动态加入, Family下面可以有多个Qualifier,所以可以简单的理解为,HBase中的列是二级列,
也就是说 Family是第一级列,Qualifier是第二级列。两个是父子关系。
– 权限控制、存储以及调优都是在列族层面进行的;
– HBase把同一列族里面的数据存储在同一目录下,由几个文件保存。
– 目前为止HBase的列族能能够很好处理最多不超过3个列族。
3).Timestamp 时间戳:
– 在HBase每个cell存储单元对同一份数据有多个版本,根据唯一的时间 戳来区分每个版本之间的差异,不同版本的数据按照时间倒序排序,
最新的数据版本排在最前面。
– 时间戳的类型是64位整型。
– 时间戳可以由HBase(在数据写入时自动)赋值,此时时间戳是精确到毫 秒的当前系统时间。
– 时间戳也可以由客户显式赋值,如果应用程序要避免数据版本冲突, 就必须自己生成具有唯一性的时间戳。
4).Cell 单元格:
– 由行和列的坐标交叉决定;
– 单元格是有版本的(由时间戳来作为版本);
– 单元格的内容是未解析的字节数组(Byte[]),cell中的数据是没有类型的,全部是字节码形式存贮。
• 由{row key,column(= +),version}唯一确定的单元。
4.Hbase 应用介绍
- –列族结构经常调整
- –高并发写入
- –结构化数据、半结构化数据存储
- –Key-Value存储
- –有序存储
- –固定集合(多版本)
- –定时删除记录(TTL)
来自 “ ITPUB博客 ” ,链接:http://blog.itpub.net/69913892/viewspace-2652097/,如需转载,请注明出处,否则将追究法律责任。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31537575/viewspace-3140127/ ,如需转载,请注明出处,否则将追究法律责任。

