今天我将详细的为大家介绍 MySQL 的 MVCC 相关知识,希望大家能够从中收获多多!如有帮助,请点在看、转发支持一波!!!
什么是 MVCC
MVCC ( Multi-VersionConcurrency Control) (注:与MVCC相对的,是基于锁的并发控制,Lock-Based Concurrency Control)是一种基于多版本的并发控制协议,只有在InnoDB引擎下存在。MVCC是为了实现事务的隔离性,通过版本号,避免同一数据在不同事务间的竞争,你可以把它当成基于多版本号的一种乐观锁。当然,这种乐观锁只在事务级别提交读和可重复读有效。MVCC大的好处,相信也是耳熟能详:读不加锁,读写不冲突。在读多写少的OLTP应用中,读写不冲突是非常重要的,极大的增加了系统的并发性能。
不仅是MySQL,包括Oracle,PostgreSQL等其他数据库系统也都实现了MVCC,但各自的实现机制不尽相同,因为MVCC没有一个统一的实现标准。
可以认为MVCC是行级锁的一个变种,但是它在很多情况下避免了加锁操作,因此开销更低。虽然实现机制有所不同,但大都实现了非阻塞的读操作,写操作也只锁定必要的行。
MVCC的实现方式有多种,典型的有乐观(optimistic)并发控制 和 悲观(pessimistic)并发控制。
MVCC 只在 READ COMMITTED 和 REPEATABLE READ 两个隔离级别下工作。其他两个隔离级别和MVCC不兼容,因为 READ UNCOMMITTED 总是读取新的数据行,而不是符合当前事务版本的数据行。而 SERIALIZABLE 则会对所有读取的行都加锁。更多关于MySQL学习的文章,请参阅:死磕数据库系列之 MySQL ,本系列持续更新中。
MVCC 的实现机制
InnoDB 在每行数据都增加三个隐藏字段,一个行号,一个记录创建的版本号,一个记录回滚的版本号。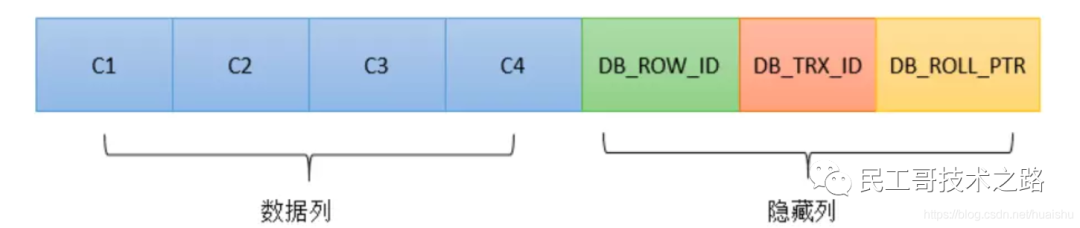 在多版本并发控制中,为了保证数据操作在多线程过程中,保证事务隔离的机制,降低锁竞争的压力,保证较高的并发量。在每开启一个事务时,会生成一个事务的版本号,被操作的数据会生成一条新的数据行(临时),但是在提交前对其他事务是不可见的,对于数据的更新(包括增删改)操作成功,会将这个版本号更新到数据的行中,事务提交成功,将新的版本号更新到此数据行中,这样保证了每个事务操作的数据,都是互不影响的,也不存在锁的问题。
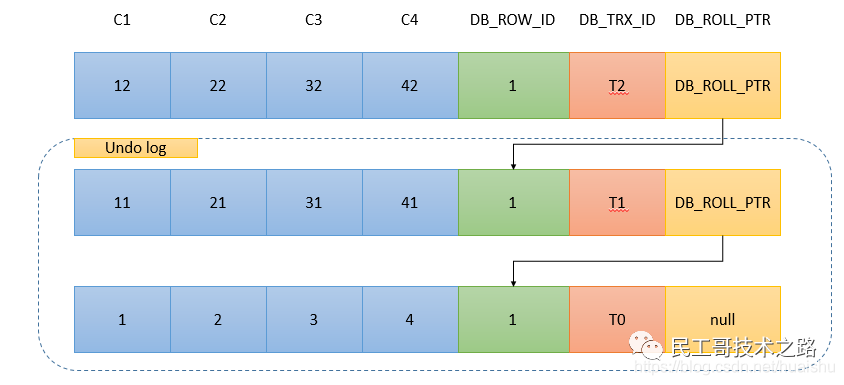
undo-log
undo log是为回滚而用,具体内容就是copy事务前的数据库内容(行)到undo buffer,在适合的时间把undo buffer中的内容刷新到磁盘。undo buffer与redo buffer一样,也是环形缓冲,但当缓冲满的时候,undo buffer中的内容会也会被刷新到磁盘;与redo log不同的是,磁盘上不存在单独的undo log文件,所有的undo log均存放在主ibd数据文件中(表空间),即使客户端设置了每表一个数据文件也是如此。
InnoDB 存储引擎在数据库每行数据的后面添加了三个字段
6字节的事务ID(DB_TRX_ID)字段:用来标识近一次对本行记录做修改(insert|update)的事务的标识符,即后一次修改(insert|update)本行记录的事务id。至于delete操作,在innodb看来也不过是一次update操作,更新行中的一个特殊位将行表示为deleted,并非真正删除。 7字节的回滚指针(DB_ROLL_PTR)字段:指写入回滚段(rollback segment)的 undo log record (撤销日志记录记录)。如果一行记录被更新, 则 undo log record 包含 ‘重建该行记录被更新之前内容’ 所必须的信息。 6字节的DB_ROW_ID字段:包含一个随着新行插入而单调递增的行ID,当由innodb自动产生聚集索引时,聚集索引会包括这个行ID的值,否则这个行ID不会出现在任何索引中。
结合聚簇索引的相关知识点,如果表中没有主键或合适的索引,也就是无法生成聚簇索引的时候,InnoDB会帮我们自动生成聚集索引,但聚簇索引会使用DB_ROW_ID的值来作为主键;如果有主键或者合适的索引,那么聚簇索引中也就不会包含 DB_ROW_ID了 。更多关于MySQL学习的文章,请参阅:死磕数据库系列之 MySQL ,本系列持续更新中。
Read View 和快照 Snapshot
事务快照是用来存储数据库的事务运行情况。一个事务快照的创建过程可以概括为:
查看当前所有的未提交并活跃的事务,存储在数组中 选取未提交并活跃的事务中小的XID,记录在快照的xmin中 选取所有已提交事务中大的XID,加1后记录在xmax中
Read View (主要是用来做可见性判断的):创建一个新事务时,copy一份当前系统中的活跃事务列表。意思是,当前不应该被本事务看到的其他事务id列表。
对于Read View快照的生成时机,也非常关键,正是因为生成时机的不同,造成了RC,RR两种隔离级别的不同可见性;
在innodb中(默认repeatable read级别),事务在begin/start transaction之后的条select读操作后,会创建一个快照(Read View),将当前系统中活跃的其他事务记录记录起来 在innodb中(read committed级别),事务中每条select语句都会创建一个快照(Read View)
RC 是语句级多版本(事务的多条只读语句,创建不同的ReadView,代价更高),RR是事务级多版本(一个ReadView);
read committed 总是读新一份快照数据,而repeatable read 读事务开始时的行数据版本。

read Commited隔离级别判断算法在每次语句执行的过程中,都关闭read_view, 重新创建当前的一份新的read_view。

read view中事务id  T_min~T_max,当前事务T1。
...执行sql,创建一份新的read_view;
...T1<T_min,说明T1事务比较早,该行对当前事务T1可见。
...T1 > T_max,说明T1比较晚,该行对当前事务不可见,根据DB_ROLL_PTR找到上一个判断再次判断。
...T_min <= T1 <= T_max,如果read_view中有该事务,则不可见,找上一个版本。如果不在则可见(在read commited下)。

repeatable read各级离别下判断算法:创建事务trx结构的时候,就生成了当前的global read view。
...trx_id_1< trx_id_min那么表明该行记录所在的事务已经在本次新事务创建之前就提交了,所以该行记录的当前值是可见的。
...trx_id_1>trx_id_max的话,那么表明该行记录所在的事务在本次新事务创建之后才开启,所以该行记录的当前值不可见。通过DB_ROLL_PTR找到上一版数据判断
...trx_id_min<=trx_id_<=trx_id_max, 那么表明该行记录所在事务在本次新事务创建的时候处于活动状态,从trx_id_min到trx_id_max进行遍历,如果trx_id_1等于他们之中的某个事务id的话,那么不可见。通过DB_ROLL_PTR找到上一版数据判断`
简单的小例子
create table yang(
    id int primary key auto_increment,
    name varchar(20));
}
假设系统的版本号从1开始.
INSERT
InnoDB为新插入的每一行保存当前系统版本号作为版本号,个事务ID为1;
start transaction; insert into yang values(NULL,'yang') ; insert into yang values(NULL,'long'); insert into yang values(NULL,'fei'); commit;
对应在数据中的表如下(后面两列是隐藏列,我们通过查询语句并看不到)
SELECT
InnoDB会根据以下两个条件检查每行记录:
a.InnoDB只会查找版本早于当前事务版本的数据行(也就是,行的系统版本号小于或等于事务的系统版本号),这样可以确保事务读取的行,要么是在事务开始前已经存在的,要么是事务自身插入或者修改过的. b.行的删除版本要么未定义,要么大于当前事务版本号,这可以确保事务读取到的行,在事务开始之前未被删除.
只有a,b同时满足的记录,才能返回作为查询结果.
DELETE
InnoDB会为删除的每一行保存当前系统的版本号(事务的ID)作为删除标识. 看下面的具体例子分析:
第二个事务,ID为2;
start transaction;
select * from yang;
//(1) select * from yang;
//(2) commit;
假设1
假设在执行这个事务ID为2的过程中,刚执行到(1),这时,有另一个事务ID为3往这个表里插入了一条数据; 第三个事务ID为3;
start transaction;
insert into yang values(NULL,'tian');
commit;
这时表中的数据如下: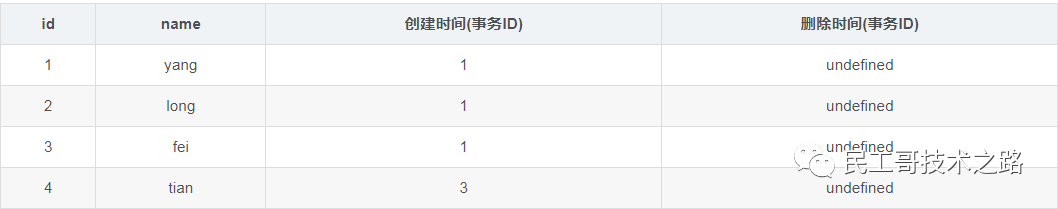 然后接着执行事务2中的(2),由于id=4的数据的创建时间(事务ID为3),执行当前事务的ID为2,而InnoDB只会查找事务ID小于等于当前事务ID的数据行,所以id=4的数据行并不会在执行事务2中的(2)被检索出来,在事务2中的两条select 语句检索出来的数据都只会下表:

假设2
假设在执行这个事务ID为2的过程中,刚执行到(1),假设事务执行完事务3后,接着又执行了事务4; 第四个事务:
start   transaction;
delete from yang where id=1;
commit;
此时数据库中的表如下: 接着执行事务ID为2的事务(2),根据SELECT 检索条件可以知道,它会检索创建时间(创建事务的ID)小于当前事务ID的行和删除时间(删除事务的ID)大于当前事务的行,而id=4的行上面已经说过,而id=1的行由于删除时间(删除事务的ID)大于当前事务的ID,所以事务2的(2)
select * from yang也会把id=1的数据检索出来.所以,事务2中的两条select 语句检索出来的数据都如下:
UPDATE
InnoDB执行UPDATE,实际上是新插入了一行记录,并保存其创建时间为当前事务的ID,同时保存当前事务ID到要UPDATE的行的删除时间.
假设3
假设在执行完事务2的(1)后又执行,其它用户执行了事务3,4,这时,又有一个用户对这张表执行了UPDATE操作: 第5个事务:
start  transaction;
update yang set name='Long' where id\=2;
commit;
根据update的更新原则:会生成新的一行,并在原来要修改的列的删除时间列上添加本事务ID,得到表如下: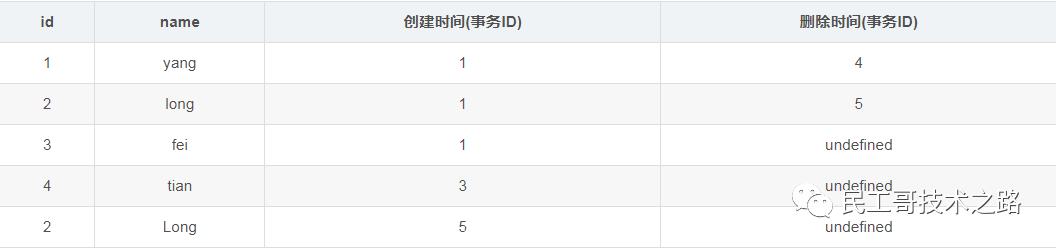 继续执行事务2的(2),根据select 语句的检索条件,得到下表:
 还是和事务2中(1)select 得到相同的结果。更多关于MySQL学习的文章,请参阅:死磕数据库系列之 MySQL ,本系列持续更新中。
MVCC下的CRUD
SELECT
当隔离级别是REPEATABLE READ时select操作,InnoDB必须每行数据来保证它符合两个条件:
InnoDB必须找到一个行的版本,它至少要和事务的版本一样老(也即它的版本号不大于事务的版本号)。这保证了不管是事务开始之前,或者事务创建时,或者修改了这行数据的时候,这行数据是存在的。 这行数据的删除版本必须是未定义的或者比事务版本要大。这可以保证在事务开始之前这行数据没有被删除。
符合这两个条件的行可能会被当作查询结果而返回。
INSERT:InnoDB为这个新行记录当前的系统版本号。DELETE:InnoDB将当前的系统版本号设置为这一行的删除ID。UPDATE:InnoDB会写一个这行数据的新拷贝,这个拷贝的版本为当前的系统版本号。它同时也会将这个版本号写到旧行的删除版本里。
这种额外的记录所带来的结果就是对于大多数查询来说根本就不需要获得一个锁。只是简单地以快的速度来读取数据,确保只选择符合条件的行。这个方案的缺点在于存储引擎必须为每一行存储更多的数据,做更多的检查工作,处理更多的善后操作。
MVCC只工作在REPEATABLE READ和READ COMMITED隔离级别下。READ UNCOMMITED不是MVCC兼容的,因为查询不能找到适合他们事务版本的行版本;它们每次都只能读到新的版本。SERIABLABLE也不与MVCC兼容,因为读操作会锁定他们返回的每一行数据。
当前读和快照读
MySQL的InnoDB存储引擎默认事务隔离级别是RR(可重复读), 是通过 “行排他锁+MVCC” 一起实现的,不仅可以保证可重复读,还可以部分防止幻读,而非完全防止;
为什么是部分防止幻读,而不是完全防止?
效果: 在如果事务B在事务A执行中,insert了一条数据并提交,事务A再次查询,虽然读取的是undo中的旧版本数据(防止了部分幻读),但是事务A中执行update或者delete都是可以成功的。
因为在innodb中的操作可以分为当前读(current read)和快照读(snapshot read):
快照读:读取的是快照版本,也就是历史版本
简单的select操作(当然不包括 select … lock in share mode, select … for update)
当前读:读取的是新版本
UPDATE、DELETE、INSERT、SELECT … LOCK IN SHARE MODE、SELECT … FOR UPDATE是当前读。
在RR级别下,快照读是通过MVCC(多版本控制)和undo log来实现的,当前读是通过加record lock(记录锁)和gap lock(间隙锁)来实现的。
来源:https://www.cnblogs.com/myseries/p/10930910.html https://blog.csdn.net/huaishu/article/details/89924250
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31537575/viewspace-3123694/ ,如需转载,请注明出处,否则将追究法律责任。

