文本分类算法
文本分类算法经常用于文本处理中的预处理,文本分类任务是指在给定的分类体系中,将文本指定分到某个或某几个类别中。被分类的对象有短文本,例如句子、标题、商品评论等等,长文本,如文章等。分类体系一般人工划分,例如:1)政治、体育、军事 2)正能量、负能量 3)好评、中性、差评。因此,对应的分类模式可以分为:二分类与多分类问题。
对于文本分类算法的过程一般如下:

训练模型的过程主要分为四个步骤:
1、准备训练数据,准备训练数据主要是清洗数据,选取特征工程,特征值选取是否正确影响后面的行业分类是否准确。
2、选择不同的文本分类算法,不同的文本分类算法的准确性和性能不同,主要有以下几种NLP的文本分类算法:
1——k近邻算法
2——决策树
3——多层感知器
4——伯努力贝叶斯
5——高斯贝叶斯
6——多项式贝叶斯
7——逻辑回归
8——支持向量机
9——随机森林算法
10——自适应增强算法
11——lightgbm算法
12——xgboost算法
13——前馈神经网络
14——LSTM 神经网络
3、选择训练模型之后,对训练数据和模型进行训练,完成训练之后,对多组测试数据进行测试,测试完成之后获取测试数据的准确率,一般情况测试数据的准确率大于90%投入使用。4、训练完成之后的模型即可以进行预测,预测之前需要对数据进行清洗和特征值的选取,然后进行预测,对预测结果进行检查,当准确率不足时,需要考虑特征的选取是否合适,以及该模型的预测数据和训练数据类型是否是相似,如果特征不同或者预测数据和训练数据的区别很大,会出现预测准确率和原始的测试准确率相差很大的问题。
例如我们需要对文章的行业进行分类处理:
1)建立训练数据集的特征工程
2)选择合适的算法
3)进行算法训练
4)校验算法的正确性
5)使用算法进行行业预测。
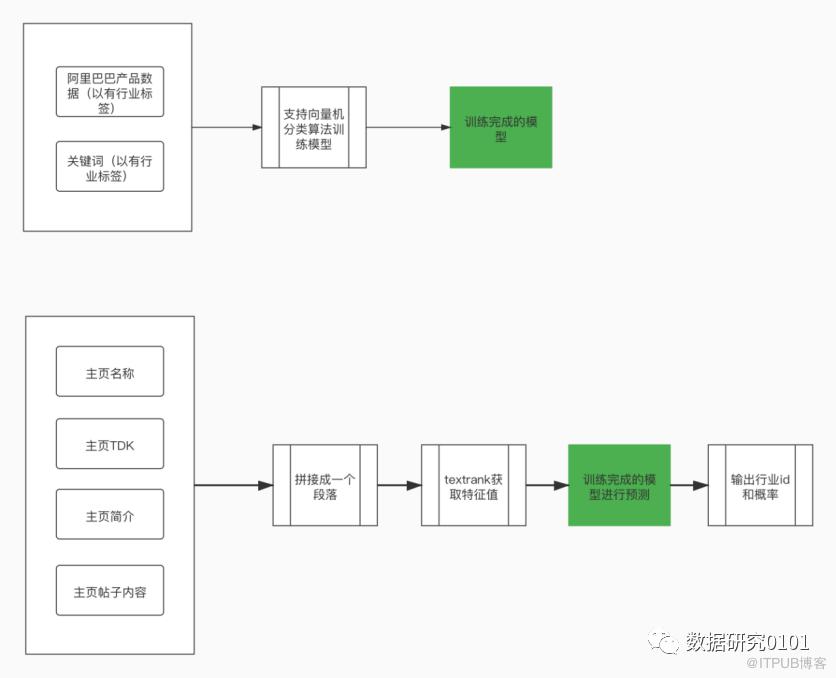
1)我们选择已经有的已经有的语料库阿里巴巴产品数据和行业关键词库,进行算法训练
2)对我们将要处理的数据中,选择对应的特征字段进行标识,作为算法的特征向量;
3)使用textrank 算法对文本内容进行特征值处理
4)使用训练好的算法进行行业id预测。
其中在校验算法的正确性的时候,可以使用十折交叉检验、auc,f1 等检验准确度的指标。
原文作者:Ruby的数据漫谈;如有侵权,请联系管理员删除。

