数据中台建模是怎样的了?
本文以一个AI文章创建的过程讲解数据中台数据表的分层以及表建设的规则等基本原则。本文以AI文章的生成为业务逻辑背景。AI文章的生成的整体业务逻辑的流程图如下:
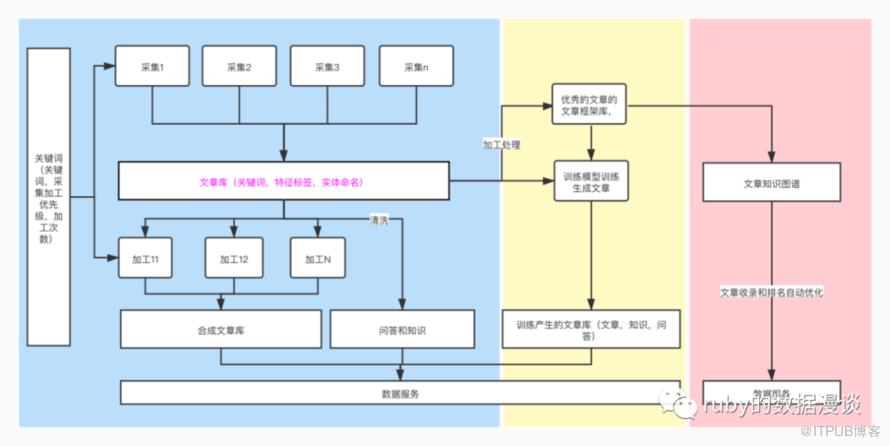
这里简单说明一下业务流程图,本图中设计到3个数据模型层次和两条业务处理流程。
1)从数据采集到合成文章的数据模型ODS->DW-DM,
2) 后台的批处理合成文章,以及检索不到文章的时候,实时生成文章两条数据处理流程,即批处理流程和实时处理流程。
数据采集流程从公域网上采集各种文章素材,以关键词进行搜索采集,采集之后的是原始的文章素材库,此时存储的数据为ODS层,此处需要2个原始的关键表;
1)ODS_XXX_keyword
| 字段名 | 字段说明 | 数据类型 | 备注 |
| id | |||
| keyword | 爬取回来的关键词 | text | |
| kw | 来源的关键词 | text | |
| avg_monthly_search | 平均每月搜索 | float | |
| competition | 竞争程度 | keyword | |
| competitionvalue | 竞争程度值 | float | |
| industry_rate | 行业概率 | object | |
| industry_ids | 行业id | text | |
| update_time | 更新时间 | date | |
| google_ads | 是否是谷歌ads | integer | |
| google_rel | 是否是谷歌相关词 | integer | |
| google_ext | 是否是谷歌拓展词 | integer | |
| alibaba_rel | 是否是阿里巴巴相关词 | integer | |
| alibaba_ext | 是否是阿里巴巴拓展词 | integer | |
| question_words | 是否是疑问词 | integer | |
| index | 搜索的结果 | long | 来源dw_gofish_google_recommended_words |
| related_ratio | 相关系数 | long | 计算 |
| evaluation_cost | 评估成本 | long | |
| evaluation_cost_status | 评估成本状态 | integer | |
| company_url_status | 该关键词是否用于采集公司信息 | integer | |
| is_repeat | kw、keyword是否存在连续重复单词 | integer | 1为重复 |
2)ods_XXX_article
| 字段名 | 字段说明 | 数据类型 | 备注 |
| id | |||
| kw | 采集关键词 | text | |
| kw_industry_ids | 关键词行业id | integer | |
| is_section | 是否是文章 | integer | 1是段落,0是文章 |
| article_type | 文章类型 | integer | 1、文章 2、知识库 3.问答库4:FQA ,5:公司介绍-文本,6:市场发展、7:产品描述 8:产品优势 9:资质展示-文本 10:应用场景-文本 11:如何使用、12:产品特点 13:资质展示-图片 14:应用场景-图片,15:公司介绍-图片,16:产品保养 |
| title | 文章标题/问题的标题 | text | |
| content | 文章内容/答案的内容 | text | |
| word_count | 文章单词数量 | integer | |
| section_count | 文章段落数据量 | integer | 被采用的段落数量 |
| source | 来源平台 | text | |
| c_url | 文章源链 | keyword | 例:http:www.aa.com/bb/cc/dd.html |
| file_name | 文章页面名称 | text | 例:dd |
| dir_name | 文章路径名称 | text | 例:/bb/cc |
这一层的数据为原始数据层,保留了从各种源来的数据,这里面的数据保留的是存储在库中的一些最原始的数据,经过过了初步的清洗过滤,例如敏感词过滤,特殊主题文章过滤等,保障进入到库中存储的数据是在合法合理的范围内。
需要完成后期的文章AI生成则需要对存储到库中的原始语料库进行清洗加工,生成DW层的数据,清洗规则包含特殊符号过滤,小语种翻译,语法修正,敏感词,敏感主题检测等等,然后在进行加工规则的处理,文章类型检测,是文章,还是文档,文章和关键词的匹配度的检测,文章质量读的评估,文章去重检测,文章原创度检测,行业分类等,经过这些清洗和加工规则之后进入到DW层,则DW层的数据模型如下:
1)DW_XXX_article_merge
| 字段名 | 字段说明 | 数据类型 | 备注 |
| id | |||
| kw | 采集关键词 | text | |
| kw_industry_ids | 关键词行业id | integer | |
| is_section | 是否是文章 | integer | 1是段落,0是文章 |
| article_type | 文章类型 | integer | 1、文章 2、知识库 3.问答库4:FQA ,5:公司介绍-文本,6:市场发展、7:产品描述 8:产品优势 9:资质展示-文本 10:应用场景-文本 11:如何使用、12:产品特点 13:资质展示-图片 14:应用场景-图片,15:公司介绍-图片,16:产品保养,17:客户问题和回答 18:客户评论 |
| title | 文章标题/问题的标题 | text | |
| content | 文章内容/答案的内容 | text | |
| word_count | 文章单词数量 | integer | |
| section_count | 文章段落数据量 | integer | 被采用的段落数量 |
| source | 来源平台 | text | |
| c_url | 文章源链 | keyword | 例:http:www.aa.com/bb/cc/dd.html |
| file_name | 文章页面名称 | text | 例:dd |
| dir_name | 文章路径名称 | text | 例:/bb/cc |
| web_title | 网站title | text | |
| web_keyword | 网站keyword | text | |
| web_description | 网站description | text | |
| article_id | 对应文章的id | keyword | |
| source_number | 对应平台的号码 | integer | |
| is_head | 是否首段 | integer | 0,1 |
| is_tail | 是否尾段 | integer | 0,1 |
| feature_names | 特征词列表 | text | 段落20个,文章:50个 |
| features_labels | 特征值优化 | keyword | |
| feature_values | 特征值列表 | float | 段落20个,文章:50个 |
| publish_time | 文章发布时间 | text | 2020/2/2 12:01:01 |
| industry_ids | 新行业id | integer | |
| industrt_rates | 新行业概率 | object | |
| keywords | 特征词列表 | text | |
| article_related_id | 文章关联id | keyword | |
| collect_type | 采集类型 | integer | |
| product_name | 产品名 | keyword | |
| brand | 品牌名 | keyword | |
| product_model | 产品模型 | keyword |
通过以上两张模型的比对,DW层的数据模型集成了ODS层的关键属性,以及新增加了更多为了后续使用的属性列。
其中可以看到的是关键词和行业信息是来自主数据表,关键词是一张主数据表,行业分类信息是一张主数据表。
经过以上的清洗加工之后DW层的数据成为可以使用的基本素材数据。可以作为AI文章模型训练的输入数据语料库,也可以作为AI文章合成的素材。
通过AI模型的训练可以生成DM层的可用文章数据,也可以通过AI文章加工规则生成DM层的可用文章,DM层的数据模型设计两张表,如下所示:
1)DM_XXX_article_merge
| 字段名 | 字段说明 | 数据类型 | 备注 |
| id | |||
| kw | 采集关键词 | text | |
| kw_industry_ids | 关键词行业id | integer | |
| is_section | 是否是文章 | integer | 1是段落,0是文章 |
| article_type | 文章类型 | integer | 1、文章 2、知识库 3.问答库4:FQA ,5:公司介绍-文本,6:市场发展、7:产品描述 8:产品优势 9:资质展示-文本 10:应用场景-文本 11:如何使用、12:产品特点 13:资质展示-图片 14:应用场景-图片,15:公司介绍-图片,16:产品保养 |
| title | 文章标题/问题的标题 | text | |
| content | 文章内容/答案的内容 | text | |
| word_count | 文章单词数量 | integer | |
| section_count | 文章段落数据量 | integer | 被采用的段落数量 |
| source | 来源平台 | text | |
| c_url | 文章源链 | keyword | 例:http:www.aa.com/bb/cc/dd.html |
| file_name | 文章页面名称 | text | 例:dd |
| dir_name | 文章路径名称 | text | 例:/bb/cc |
| web_title | 网站title | text | |
| web_keyword | 网站keyword | text | |
| web_description | 网站description | text | |
| article_id | 对应文章的id | keyword | |
| source_number | 对应平台的号码 | integer | |
| is_head | 是否首段 | integer | 0,1 |
| is_tail | 是否尾段 | integer | 0,1 |
| feature_names | 特征词列表 | text | 段落20个,文章:50个 |
| feature_values | 特征值列表 | float | 段落20个,文章:50个 |
| publish_time | 文章发布时间 | text | 2020/2/2 12:01:01 |
| industry_ids | 新行业id | integer | |
| industrt_rates | 新行业概率 | object | |
| keywords | 特征词列表 | text |
2)DM_XXX_article_ai
| 字段名 | 字段说明 | 数据类型 | 备注 |
| id | |||
| title | 文章标题 | text | 分词 |
| content | 文章内容 | text | 不分词,可以不存ES |
| keywords | 关键词列表 | text | 分词,逗号隔开 |
| summaries | 文章摘要 | text | 分词,换行符隔开 |
| industry_ids | 行业id列表 | integer | 列表 |
| industry_rate | 行业概率列表 | float | 列表 |
| char_count | 文章字符数量 | integer | |
| word_count | 文章单词数量 | integer | |
| line_count | 文章行数量 | integer | |
| section_count | 文章段落数据量 | integer | |
| generation_type | 生成方式 | integer | 0:随机,1:命题 |
| generation_status | 生成状态 | integer | 0:未生成,1:已生成 |
| generation_time | 生成时间 | date | |
| usage_count | 使用次数 | integer | 暂时未使用 |
DM层的数据模型依据应用需要的字段进行建模,和DW层有较大的区别,DW层的数据是DM层的加工素材数据。
通过以上过程的分析了解:
1)ODS层的数据是原始数据,原始数据可能是经过处理后,也有可能是未处理的数据,根据实际情况确定。
2)DW层或者DWS层的数据是来源于ODS层的数据,经过清洗和加工处理后的数据,大部分字段来源于ODS层
3)DM层或者DWD层的数据是依据业务应用进行模型建模,但是数据来源于DW层。
那么如何判断一个数据中台的模型的好坏了,优化空间是哪里了,具体可以从以下几个方面考虑:
1)完善度
汇总层数据能够直接满足业务查询的比例反映了数据模型的有效性,即该模型的设计是否能够满足绝大部分的业务需求。同时,ODS层直接被DWS/ADS/DM层引用的表的比例也是衡量数据模型优劣的重要指标,即跨层引用率。该比例应低于20-30%。一个好的数据模型应该能够直接从汇总层获取所有需要的数据,而不需要太多地引用ODS层。如果跨层引用率过高,即DWS,ADS,DM层过度引用ODS层表,说明该模型还有优化空间。
2)复用度
ODS层模型、DW层模型用来产生DM层模型的平均数量,如果约大,则模型的复用度约高。
3)规范度
例如:常见的命名规范如下:
ODS层命名:ods_{源系统英文简称}_{源系统表名}_{数据刷新周期}{增量全量标识}
DWD层命名:DWD_{一级数据域}_{二级数据域}_{自定义表名}_{刷新周期编码}{增量全量标识}
DWS层命名:DWS_{一级数据域}_{二级数据域}_{自定义表名}_{刷新周期编码}{增量全量标识}
DIM层命名:DIM_{一级数据域}_{二级数据域}_{自定义表名}_{刷新周期编码}{增量全量标识}
ADS层命名:ADS_{项目简称}_{自定义表名}_{刷新周期编码}{增量全量标识}
4)健壮性
业务快速更新迭代的情况下不会太影响底层模型,例如ADS层新生成模型 ,ODS层,DWD层的模型基本不会变动。
5)成本考虑因素
计算成本、存储成本、性能指标等。例如如果业务需要数据响应需要0.005秒返回,需要的计算成本和存储成本是多少?
综上所述,数据模型的创建是中台建设的关键性工作,需要具备模型创建经验的架构师完成,否则后续开发以及业务增长都会带来灾难性的问题。
原文作者:Ruby的数据漫谈;如有侵权,请联系管理员删除。

