数据科学家不能不知道机器学习算法

01
—
线性回归是统计学中最简单、最古老的预测模型之一,主要用于定量数据的预测和建模。在机器学习领域,线性回归是监督学习算法中的一种,用于预测一个或多个自变量(predictor variables)与因变量(response variable)之间的关系。
线性回归模型假设自变量和因变量之间存在线性关系。在最简单的单变量线性回归中,这个关系可以通过一条直线表示:
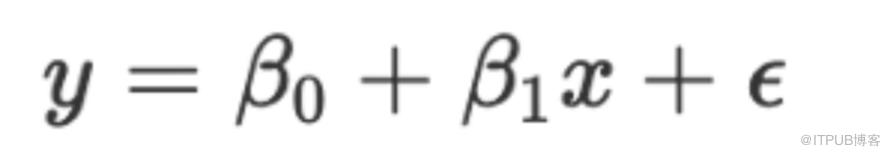
其中:
·( y ):因变量(预测的值)
·( x ):自变量(输入特征)
·( \beta_0 ):截距项(y轴的截距)
·( \beta_1 ):斜率项(x每变化一个单位,y预计会变化的数量)
·( \epsilon ):误差项(观察值与线性模型预测值之间的差异)
多变量线性回归(也称为多元线性回归)则涉及多个自变量:
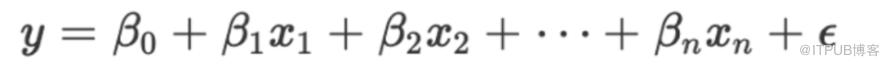
在实际应用中,我们通常不知道真正的 ( \beta ) 参数。因此,需要通过已有的数据点来估计这些参数。线性回归通常采用最小二乘法(OLS, Ordinary Least Squares)来估计模型参数,目标是最小化所有数据点和回归直线之间距离的平方和:
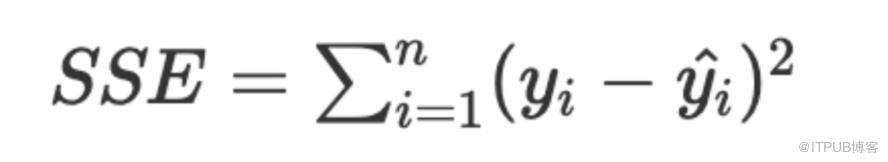
其中 ( SSE ) 表示误差平方和,( \hat{y_i} ) 表示通过模型估计的 ( y ) 的值。
在最小化 ( SSE ) 的过程中,可以得到 ( \beta ) 参数的估计值。最小二乘法可以直接计算得到闭式解,也可以通过数值优化方法求解。
为了使线性回归模型有效,它依赖于几个关键假设:
1.线性假设:自变量和因变量之间是线性关系。
2.同方差性(Homoscedasticity):误差项 ( \epsilon ) 的方差是恒定的。
3.独立性:观测值之间是相互独立的。
4.无多重共线性:模型中的自变量应该是相互独立的,一个自变量不能是另一个自变量的精确或近似线性组合。
5.误差项的正态分布:虽然这不是最小二乘估计所必需的,但为了进行有意义的推断(例如计算置信区间及进行假设检验),误差项 ( \epsilon ) 应该接近正态分布。
评估线性回归模型的好坏,可以使用以下几种指标:
·R-squared(( R^2 )):反映模型解释的变异程度,值越接近1表示模型越好。
·调整 R-squared(Adjusted ( R^2 )):根据模型中变量的数量对 ( R^2 ) 进行调整,避免因变量数量的增加导致 ( R^2 ) 虚假提高。
·均方误差(MSE)或均方根误差(RMSE):反映预测值与实际值之间差异的平均水平。
线性回归在实际生活中有广泛应用,包括经济预测、房价估算、股票价格分析、社会科学研究等领域。虽然它比较简单,但线性回归通常是数据分析和机器学习项目中的出发点。它不仅可以作为一个独立的预测模型,也可以作为更复杂模型分析的基础。

02
—
逻辑回归(Logistic Regression)
逻辑回归(Logistic Regression)是一种广泛用于二分类问题的统计学方法。尽管名字中带有“回归”,但它实际上是一种分类模型,用于预测一个事件发生的概率。例如,用于判断一封邮件是否为垃圾邮件,或者一个交易是否为欺诈。
与线性回归模型直接输出一个连续的输出不同,逻辑回归模型旨在输出一个概率值,该值介于0和1之间。为了将线性回归模型的连续输出变换为概率,逻辑回归应用了一个称为逻辑函数(Logistic Function)或Sigmoid函数的特殊函数。
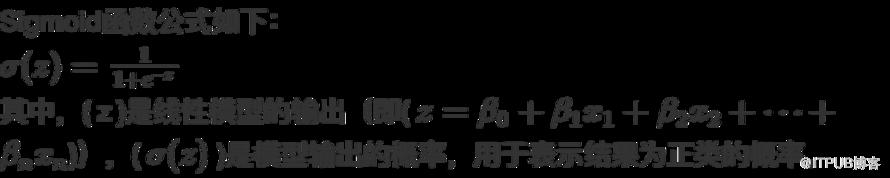

在训练模型后,可以通过不同的方法来评估其性能,包括精确率(Precision)、召回率(Recall)、F1得分以及接收者操作特性曲线(ROC Curve)下面积(Area Under Curve,AUC)等。在预测时,根据给定的输入( x ),我们可以估计输出( y )为1的概率。通常设置一个临界点(阈值,比如0.5),如果估计概率高于该阈值,则预测输出标签为1;反之,则为0。
优点:
简单直观,输出的概率易于解释。
可以使用正则化来处理过拟合问题。
在资源有限的情况下计算效率高。
缺点:
对于非线性问题,模型性能不够强大。
容易受到数据不平衡的影响,需要采用技巧如重采样或使用特殊的损失函数来处理。
对于分类问题,直接预测概率值,而不是结果分类,需要选择合适的阈值。
逻辑回归在各种二分类场景中都有应用。它在医学领域用于疾病诊断,如预测病人是否有糖尿病;在金融领域用于信用评分,如判断客户是否有违约的风险;在营销领域用于预测顾客是否会购买某产品;在工程领域用于故障预测,如预测机器何时会发生故障等。
逻辑回归由于其简单性和效率,在实际问题中仍然是一个非常流行和实用的工具,尤其是作为分类问题建模的起点。

03
—
决策树(Decision Tree)是一种非参数的监督学习方法,用于分类和回归任务。它的目的是通过从数据中学习简单的决策规则来推断出目标变量的值。在直观上,决策树模型就像我们通过一系列的问题和答案来做决定的过程。
决策树由节点和分支组成,具有以下主要部分:
1、根节点(Root Node):包含整个样本,是决策树的起始点。
2、内部节点(Internal Nodes):表示一个特征或属性。
3、分支(Branches):代表决策规则的输出,即从一个节点到另一个节点的路径。
4、叶子节点(Leaf Nodes):树的末端节点,表示决策结果。
构建决策树主要涉及特征选择和树的修剪两个过程:
1、特征选择:选择最适合分割数据集的特征。常用的准则包括:
o信息增益(Information Gain):基于信息熵的减少最大化。
o基尼不纯度(Gini Impurity):衡量数据集的不纯度,希望选择后的子集尽可能纯净。
o增益率(Gain Ratio):对信息增益的调整,减少对带有更多水平的特征的偏好。
o方差减少(Variance Reduction):用于回归树,目的是减少结果的方差。
2、树的修剪:修剪是防止决策树过拟合的过程。修剪有预剪枝和后剪枝两种策略:
o预剪枝(Pre-Pruning):在树完全生成之前停止树的生长。
o后剪枝(Post-Pruning):先构造树,然后删除不必要的非叶子节点。
优点:
易于理解和解释。人们在通过解释后都有能力理解决策树所表达的意义。
对于数据的准备工作相对简单。不需要进行数据归一化,也不需要处理缺失数据。
能够同时处理数据型和常规型属性。
在相对短的时间内能够对大型数据源做出可行且效果良好的结果。
缺点:
易于过拟合,尤其是当树太深或数据过于复杂时。
决策树可能不稳定,数据中微小的变化可能导致生成完全不同的树。
对于某些特定类型的问题(如XOR、多路分类器),单一决策树的学习效果不是非常好。
如果某些类占主导地位,决策树会创建偏向这些类的模型。
决策树在各种领域有广泛的应用,例如在金融分析中,可以用来评估用户信用、银行欺诈行为;在医学上,可以用来分析患者的病情发展和预测疾病;在电商领域,可以通过顾客的购买历史和行为数据来推荐产品。
常用的决策树算法
ID3(Iterative Dichotomiser 3):基于信息增益的决策树算法。
C4.5:ID3的改进版本,使用信息增益比来选择属性。
CART(Classification and Regression Trees):即可用于分类也可用于回归的树算法,CART使用基尼不纯度作为特征选择准则。
虽然单个决策树可能表现不是最优的,但通过集成学习方法,如随机森林(Random Forests)和梯度提升树(Gradient Boosting Trees),可以大大提高预测的准确性。这些方法通过结合多个决策树的预测来改善单个模型的性能。
总之,决策树因其简单直观而深受数据科学家的喜爱,而且它们通常是许多复杂集成方法的基本构建块。

04
—
随机森林(Random Forest)

05
—
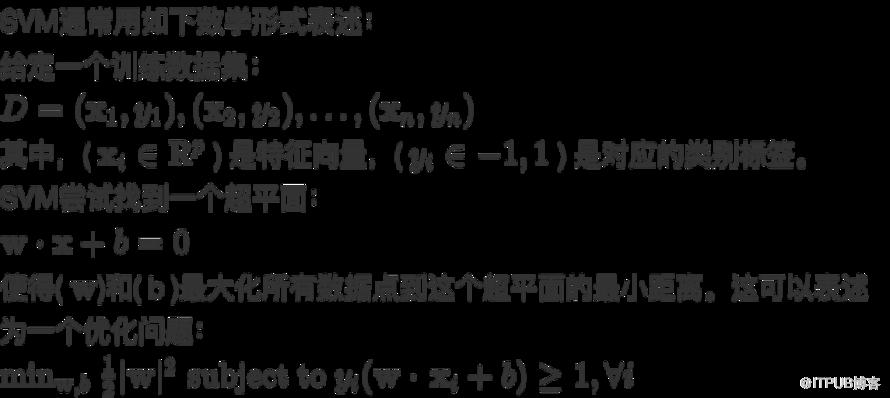
支持向量机(Support Vector Machine,简称SVM)是一种强大的监督式学习模型,广泛应用于分类和回归问题。SVM在处理中小型复杂数据集时尤其有效。它基于统计学习理论中的结构风险最小化原则,尝试找到一个超平面,该超平面能够最大化不同类别之间的间隔,从而实现数据分类。
SVM的核心思想是找到一个最优化的线性分割超平面(在二维空间中是直线,在三维空间中是平面,在高维空间中是超平面),这个超平面能够把不同的数据类别分开。
在简化的二分类问题中,假设我们有两类数据分布在二维平面上,SVM的目标是找到一条直线,它不仅能够正确分类这两类数据,而且能最大化两类数据到这条直线的最小距离。这条直线就是我们所说的最优超平面。
数据点到超平面的距离称为间隔(margin),而位于间隔边缘上的数据点被称为支持向量。SVM通过最大化间隔宽度来提高模型的泛化能力。

06
—
一个较小的K值可以使模型更贴近训练数据,这可能会导致过拟合。 一个较大的K值虽然减轻了噪声的影响,但同时也可能使模型过于简化,从而不能准确反映数据的分布,可能导致欠拟合。 通常,K值的选择取决于数据:在实践中,人们通常通过交叉验证来选取最优的K值。
欧氏距离(Euclidean Distance):最常见的距离度量方法,适合特征间的比例相同或类似的情况。 曼哈顿距离(Manhattan Distance):计算各个维度的绝对值差的和,适合特征量纲差异较大的数据集。 闵可夫斯基距离(Minkowski Distance):欧氏距离和曼哈顿距离的一般化形式。
计算量大,尤其是当训练集很大时,每个测试样本都需要与训练集中的所有样本计算距离。 需要合理的度量距离方式。 算法对噪声和非相关特征(irrelevant features)敏感。 没有明显的学习过程,因为实际上它只是在训练数据上做了记忆。 随着数据维度的增长,由于维度诅咒(curse of dimensionality),算法的性能会下降。

07
—
K-均值算法尝试找到数据集中自然分离的“k”个子集(聚类)。它将数据点归纳到K个聚类中,聚类的个数K需要在执行算法之前指定。算法通过迭代地寻找聚类的质心(每个聚类中心点的均值位置)并将数据点划分到最近的聚类中。
K-均值聚类的工作流程如下:
1.初始化:随机选择“k”个数据点作为初始聚类中心(质心)。
2.分配数据点:将每个数据点分配到最近的质心,这样形成k个聚类。
3.更新质心:重新计算每个聚类的质心,通常是该聚类中所有点的平均位置。
4.重复步骤2和3:继续迭代,将数据点分配到聚类并更新质心,直到满足停止条件(通常是质心的变化非常小或达到预定义的迭代次数)。
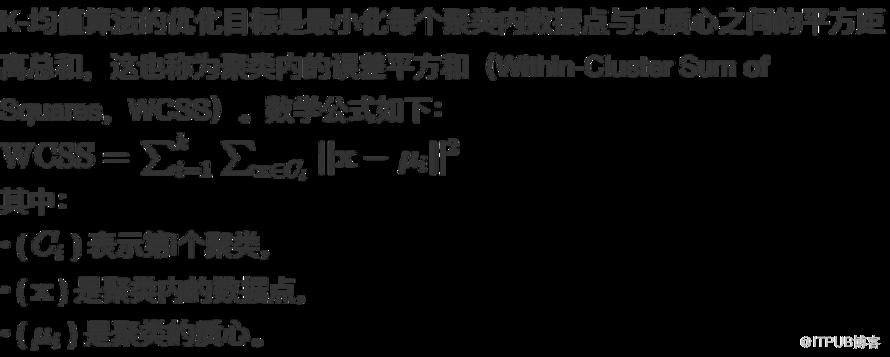
K-均值算法需要事先确定聚类数量“k”的值,它的选择对算法结果有很大影响。选择K值的一个常用方法是使用肘部法则(Elbow Method)。该方法通过改变K值并绘制每个K的WCSS值,观察WCSS值的变化趋势,在WCSS较快下降的曲线上找到一个“肘部”,即选择那个增加聚类数量并不会显著提高模型性能的点作为K值。
优点:
·算法简单,易于理解。
·对于大量数据集,K-均值算法是相对计算高效的。
·广泛应用于市场细分、文档分类、图像压缩等领域。
缺点:
·必须预先指定聚类数量K。
·对初始化敏感,不同的随机初始化可能导致不同的结果。
·对异常值(Outliers)敏感,异常值可能显著扭曲聚类的质心。
·假定聚类为凸形状,对于非球形的聚类有时会效果不佳。
·可能陷入局部最优解,而不是全局最优解。
为了克服K-均值的一些缺点,研究者们提出了多种变种算法,例如:
·K-中心点(K-Medoids):类似于K-均值,不过将每个聚类的中心定义为聚类内的一个实际数据点,以增强对噪声和异常值的鲁棒性。
·K-均值++(K-Means++):提供了一种特别的初始化方法来减少算法对初始化敏感性的问题。
K-均值聚类算法在众多领域内都有广泛的应用:
·市场分析:识别具有相似特征的客户群体,进行市场细分。
·图像分割:基于颜色、纹理等特性将图像分割成不同的区域。
·社交网络分析:发现具有相似兴趣或连接模式的用户群体。
·组织计算集群:根据相似性将文件或数据进行组织。
K-均值聚类由于其实现简单和易于执行的特点,在探索性数据分析和快速原型设计中很受欢迎。正确选择K值和聚类初始化可以显著提高聚类结果的质量。尽管存在一些局限性,K-均值聚类在许多实际应用中都被证明是一个非常有用的工具。

08
—
网络和深度学习(Neural Networks & Deep Learning)
神经网络(Neural Networks)和深度学习(Deep Learning)是机器学习的子领域,借鉴了生物大脑中神经元的工作方式。这些技术能够对数据进行自动化和高度复杂的学习过程,通常用于图像和语音识别、自然语言处理、游戏和机器人系统等领域。
神经网络是由大量互联的节点(通常称为“神经元”)组成的计算系统。这些神经元通常分布在不同的层次中:
1.输入层:接收输入数据。
2.隐藏层:一个或多个隐藏层,进行数据的处理和转换。
3.输出层:输出最终结果或预测。
每个神经元通常包含一个激活函数,用于决定神经元是否应当被激活,即向后一层发送信号。最常用的激活函数包括 Sigmoid、Tanh 和 ReLU(Rectified Linear Unit)。
在神经网络中,神经元之间的连接由权重来控制,而每个神经元可能有一个偏置项。权重和偏置是通过学习过程进行调整的参数,以使得网络的预测尽可能地接近真实结果。
深度学习是包含多个隐藏层的神经网络,因此被称为“深层”神经网络。这些额外的层使得网络能够捕获数据中的复杂结构和深层次的特征,从而完成更加复杂的任务。
深度学习的关键技术之一是卷积神经网络(CNNs),它们特别适合处理图像数据。CNN在图像分析中通过局部感受野和权值共享的概念来减少网络参数的数量,并通过池化层来降低特征的空间分辨率,增强特征的抽象能力。
另一个重要的深度学习模型是循环神经网络(RNNs),特别适合处理时间序列数据或任何形式的序列数据,如自然语言。由于RNN能够处理前一个状态的信息,它能够在序列的上下文中保持信息的流动。LSTM(Long Short-Term Memory)和GRU(Gated Recurrent Units)是解决标准RNN的短期记忆问题的变体。
神经网络的训练过程通常使用反向传播(Backpropagation)算法和梯度下降法:
1.前向传播:数据在网络中向前传播,每一层神经元的输出成为下一层的输入,直到最终生成输出层的预测。
2.损失函数:通过损失函数计算预测值与真实值之间的差异(比如均方误差MSE,交叉熵等)。
3.反向传播:损失函数的梯度被计算并向后传播通过网络,这个过程中计算每个权重对于损失的影响。
4.参数更新:使用梯度下降(或其它优化算法)来更新网络的权重和偏置,减少损失函数的值。
深度学习在近些年引起了广泛关注,主要是因为它在许多应用中取得了革命性的进展:
·计算机视觉:图像识别、面部识别、物体检测、图像分割等。
·自然语言处理:机器翻译、情感分析、自动生成文本等。
·语音识别:为智能助手提供能力,如Siri、Alexa和Google Assistant。
·自动驾驶汽车:借助于视觉识别系统,识别交通标志、行人和其他车辆等。
·游戏和机器人:如AlphaGo等AI玩家在围棋和其他棋类游戏中取得成功。
尽管深度学习取得了显著成功,但它仍然面临许多挑战,包括需要大量标记数据进行训练、模型解释性差、计算资源消耗大等。未来的研究可能集中在提高模型的可解释性、降低对数据标记的依赖(比如通过无监督学习、自监督学习)、减少模型训练的计算成本以及提高模型的可移植性和鲁棒性。
欢迎加入【数据行业交流群】社群,长按以下二维码加入专业微信群,商务合作加微信备注商务合作
往期历史热门文章:
基于DataOps的数据开发治理:实现数据流程的自动化和规范化
原文作者:Ruby的数据漫谈;如有侵权,请联系管理员删除。

