经过几天闲暇时间的学习,终于又理解的深入了一些,关于Spark Client如何提交作业也更清晰了点。
在整体的流程图上是这样的:

大体的思路就是应用程序通过SparkSubmit提交程序后,自动在当前的JVM中启动Driver,然后与Master通信创建Excutor执行相应的任务。
自己整理了下流程图

以及的组件图:

可以看到大概是下面的步骤:
- 新建SparkContext
- 创建对应的scheduler和schedulerBackend
val (sched, ts) = SparkContext.createTaskScheduler(this, master, deployMode) _schedulerBackend = sched _taskScheduler = ts ... _taskScheduler.start()
- 启动scheduler的start方法,内部调用backend的start方法
- backend调用父类
CoarseGrainedSchedulerBackend的start方法
override def start() { super.start() ... client = new StandaloneAppClient(sc.env.rpcEnv, masters, appDesc, this, conf) client.start() }
- 创建对应的drvierEndpoint
- 在backend的start()方法里面创建StandaloneAppClient
- 执行StanaloneAppClient对象的start方法,内部创建ClientEndpoint
DriverEndpoint和ClientEndpoint都会跟Master进行通信,接下来的处理就是编译驱动程序的代码,发送给excutor进行相应的处理。
福利部分:
《大数据成神之路》大纲
大数据成神之路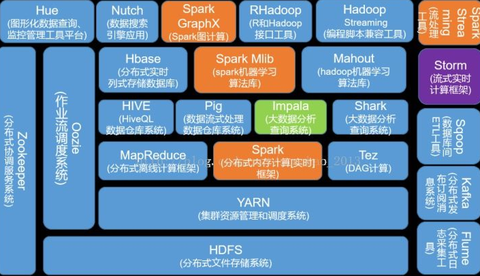
《几百TJava和大数据资源下载》
资源下载来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31509949/viewspace-3153823/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- GitHub 上已有 1400+ Claude Code Skills,真正在用的就这几个
- 开多个 Agent 后 Claude Code 账单翻了 4 倍,一个配置解决了
- 2026 年了,你还不会写 Claude Code Skill?AI 工具的下一个标准已经定了
- Claude Code v2.1.139 新增 Agent 视图颠覆了工作流,这次设计比功能更值得看
- Google 开源了一个14900 Star 项目,让 AI Agent 碰数据库不再是定时炸弹
- 总觉得Claude Code 写完代码有问题?我用了一个开源 Skill 编排了 7 阶段严谨开发工作流,拦下 10 个 Critical Bug
- Spring AI Session API:大多数人用 ChatMemory 用错了场景
- R语言实战:个人贷款违约预测模型 (基于银行的个人金融业务数据进行分析)
- 汽车 4S 集团 BI 数据可视化分析案例
- IT基础架构运维服务认知
