链接:https://www.zhihu.com/question/306432813/answer/568585759
来源:知乎
著作权归作者所有。商业转载请联系作者获得授权,非商业转载请注明出处。
Spark 并没有止步不前。
Spark 和 Flink 两个项目的核心 API 基本一致,Spark 在机器学习整合方面投入更多,Flink 在流处理方面更赞(这也是大家在 2016 年开始关注 Flink 的原因),当然二者最大的区别,也还在于对流式计算的支持。这句的潜在含义就是 Spark 存在的道理:尽管 Spark Steaming 现在和 Flink 相比优势不显,但它的生态更为丰富,除了 Streaming 还有 SQL、MLib、Graphx 等,同时目前 Spark 对 Kubernetes 云原生技术的原生支持更加到位。
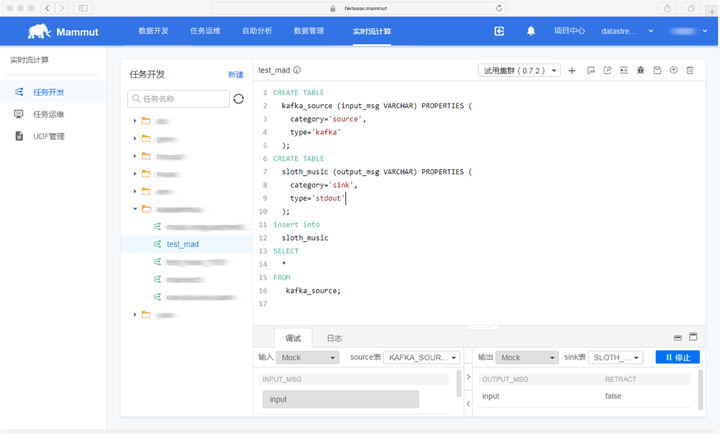
网易猛犸大数据平台,在流计算也采用基于 Flink 研发的 Sloth,支持使用 SQL 开发流式计算任务,兼容离线 SQL,可实时分析用户的访问数据,展示流量变化和用户分布情况。但是但是但是,我们在计算层并没有放弃支持 Spark ,就是因为上面的道理。

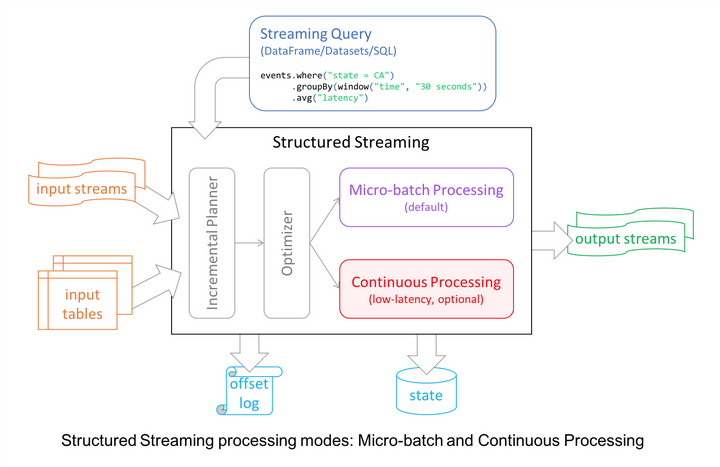
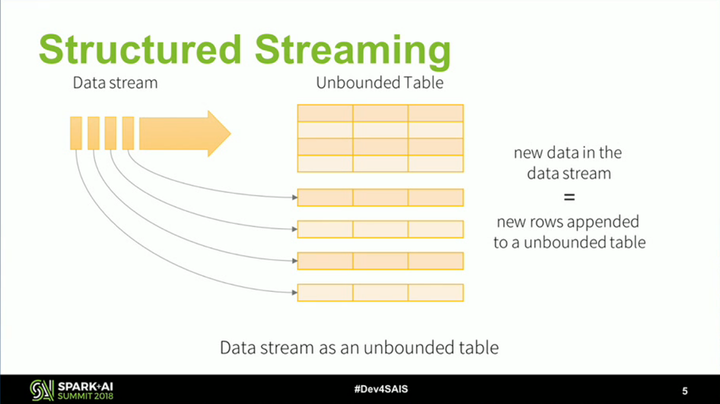
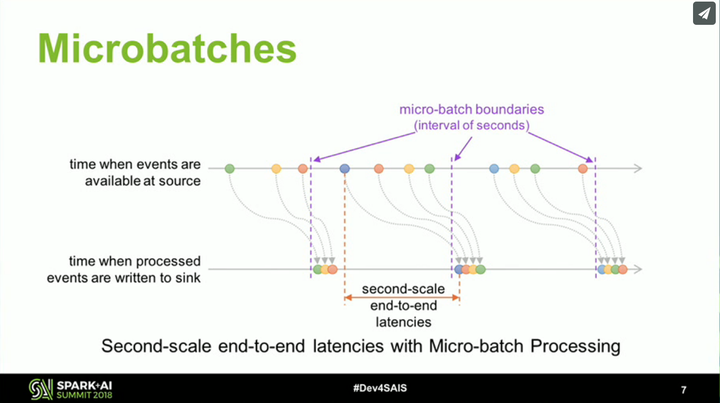
再看 Spark 在流计算方面的努力,它从 2.0 开始引入了 Structured Streaming,重新整理流计算的语义,使用微批(Micro-Batch)处理执行模型,支持按事件时间处理和端到端的一致性,并在 2.3 实现了 初始的持续处理(Continuous Processing)。根据官方介绍,Spark 执行引擎未来的发展会和 Flink 类似。这并不是最新的消息,很多功能还比较初级,但 Spark 早有规划,相信 Spark 凭借比 Flink 更为成熟的社区,会给出一个令人惊喜的答案。




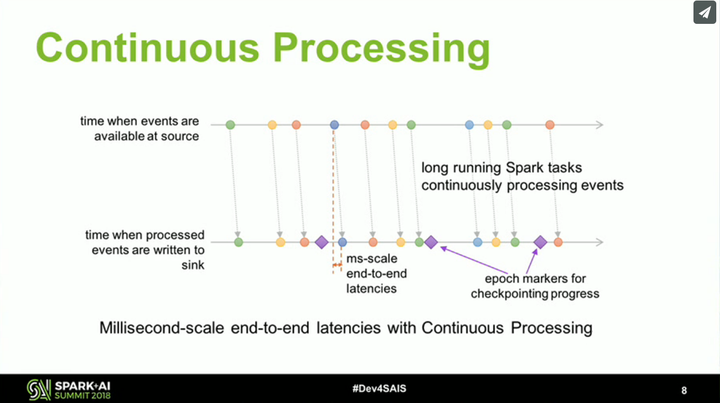

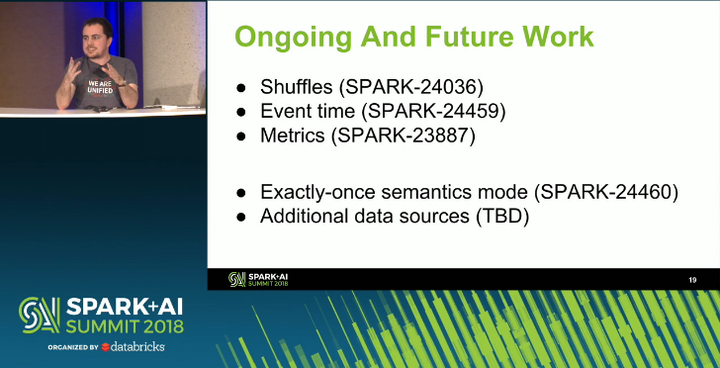
更多详情请参考官方博客与视频:
Introducing Low-latency Continuous Processing Mode in Structured Streaming in Apache Spark 2.3
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31509949/viewspace-3125909/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- GitHub 上已有 1400+ Claude Code Skills,真正在用的就这几个
- 开多个 Agent 后 Claude Code 账单翻了 4 倍,一个配置解决了
- 2026 年了,你还不会写 Claude Code Skill?AI 工具的下一个标准已经定了
- Claude Code v2.1.139 新增 Agent 视图颠覆了工作流,这次设计比功能更值得看
- Google 开源了一个14900 Star 项目,让 AI Agent 碰数据库不再是定时炸弹
- 总觉得Claude Code 写完代码有问题?我用了一个开源 Skill 编排了 7 阶段严谨开发工作流,拦下 10 个 Critical Bug
- Spring AI Session API:大多数人用 ChatMemory 用错了场景
- R语言实战:个人贷款违约预测模型 (基于银行的个人金融业务数据进行分析)
- 汽车 4S 集团 BI 数据可视化分析案例
- IT基础架构运维服务认知
