最近一直在学习怎么用ElasticSearch这个搜索引擎,下面就是我的一些使用经验,会结合代码进行说明
场景说明:首先我现在的使用场景是利用python做后端,使用flask restful框架,查询ElasticSearch的数据,返回Json数据
首先是安装,要先安装Java,因为els是基于Java的,具体可以参照这篇文章,
在Windows上安装Elasticsearch5.x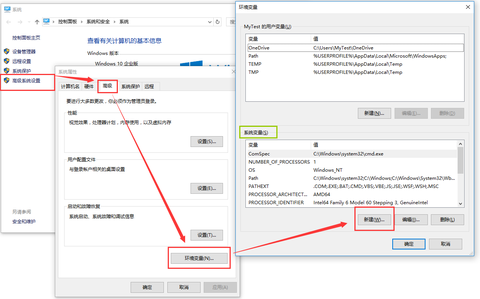
,亲测有效,里面说明了怎么安装els和els-head,但现在好像都是Elasticsearch + Logstash + Kibana了,据我所知Logstash是用来解决读写分离的,也就是说让数据库mysql之类的数据库进行删除,更改,增加的操作,而Elasticsearch只进行查找,
关于这部分我还没有搭建成功,也就是实现mysql数据和elasticsearch数据实时同步,据说有两种常见方法:1.go-mysql-elasticsearch 2.logstash,关于这两个方面我也会不断的学习,争取快点把它搭建出来

首先我觉得这篇博客的一些概念介绍的非常不错,将els的index与mysql的表结构进行了比较,
使用 Elasticsearch 实现博客站内搜索,同时这篇博主也提到了关于读写分离的问题,但是他并没有明说具体是怎么做的,比较遗憾

接下来用Python Elasticsearch Client去做查询,
Python + Elasticsearch. First steps. - Tryolabs Blog
,这篇文章也非常不错,教会你怎么去用els去查询星战的角色,我就是看了这一篇文章明白了怎么去做的
接下来就是写flask restful接口了,相当于提供一个web服务,别人请求这个网址的时候,就可以返回查询数据,其实也可以用django rest去写,原理都差不多,如果为了省事用flask restful就可以,毕竟比较简单
https://flask-restful.readthedocs.io/en/latest/quickstart.htmlQuickstart - Flask-RESTful 0.3.6 documentationQuickstart - Flask-RESTful 0.3.6 documentation接下来贴上我的代码
#! python3
# -*- coding: utf-8 -*-
from flask import Flask, jsonify
from flask_restful import reqparse, Api, Resource
from elasticsearch import Elasticsearch


es = Elasticsearch([{'host': 'localhost', 'port': 9200}])

app = Flask(__name__)
api = Api(app)

parser = reqparse.RequestParser()
parser.add_argument('query', required=False)
parser.add_argument('pageSize', type=int, default=10, required=False)
parser.add_argument('currentPage', type=int, default=1, required=False)


class Search(Resource):
    def get(self):
        """
        发送get请求去查询els引擎并返回结果
        :param query: 查询字段
        :param size: 单页结果数
        :param offset: 从哪个结果开始
        :return:
        """
        args = parser.parse_args()
        query = args['query']  # 查询字段
        pageSize = args['pageSize']  # 一页有多少结果,默认是5
        currentPage = args['currentPage']  # 当前的页数,搜索结果从哪里开始,默认是0
        if not query:
            return {'list': [], 'pagination': {'total': 0,
                                               'pageSize': 5,
                                               'current': 0}}, 200
        search_res = es.search(index='frommysql', body={'query': {'multi_match': {'query': query,
                                                                                  'fields': ['title', 'content']}},
                                                        "highlight": {"fields": {"title": {}, 'content': {}}}},
                                                   size=pageSize, from_=currentPage)
        total_els_res_length = int(search_res['_shards']['total'])  # els搜索返回的结果有多少条
        if total_els_res_length == 0:
            return {'list': [], 'pagination': {'total': 0,
                                               'pageSize': 5,
                                               'current': 0}}, 200
        else:
            # 如果返回的是正常内容,要对els的数据重新组织一下结构
            hit_res = search_res['hits']['hits']
            search_list = []
            for item in hit_res:
                _source = item['_source']
                object_id = _source['object_id']
                title = _source['title']
                content = _source['content']
                binary_sentiment = _source['binary_sentiment']
                source_name = _source['source']
                source_href = _source['url']
                updated_at = _source['occur_time']
                keywords = _source['keyword']
                tag_list = []
                if keywords:
                    keyword_list = keywords.split(' ')
                    for keyword_index, keyword_item in enumerate(keyword_list):
                        tag_list_item = {'id': 'tag-%s' % keyword_index, 'name': keyword_item}
                        tag_list.append(tag_list_item)
                search_dict = {'id': object_id, 'negative': binary_sentiment, 'title': title, 'sourceName': source_name,
                               'sourceHref': source_href, 'content': content, 'updatedAt': updated_at, 'tagList': tag_list}
                search_list.append(search_dict)
            front_receive_data = {'list': search_list, 'pagination': {'total': total_els_res_length,
                                                                      'pageSize': pageSize,
                                                                      'current': currentPage}}
            return front_receive_data, 200


class SearchHotNews(Resource):
    def get(self):
        """
        利用q普通查询
        搜索热门新闻
        :return:
        """
        keywords = [{'keyword': '区块链'}, {'keyword': '概念股'}, {'keyword': '人工智能'}, {'keyword': 'Google'}, {'keyword': '量子计算机'}, {'keyword': '无人车'},
                    {'keyword': '无人超市'}, {'keyword': 'SpaceX'}, {'keyword': '量子通信'}, {'keyword': '比特币'}]
        return jsonify(keywords)


# api.add_resource(SearchList, '/searchlist')  # 返回结果列表
api.add_resource(Search, '/api/search/query')
api.add_resource(SearchHotNews, '/api/search/hot')


if __name__ == '__main__':
    app.run(host='0.0.0.0', port=9001, debug=True)

#  api.add_resource(SearchHotNews, '/hot')
# 'http://localhost:5000/hot?query=google&size=10&offset=0'  # 启动服务后, 在网址中发送get请求
# 启动0.0.0.0端口后,通过ipconfig查看ipv4地址,然后去访问192.168.1.191:1080即可
这里有几个关键点需要说明一下
- 一个是flask restful是通过覆盖不同的类下的get put post delete方法去映射接口,就相当于之前flask传统模式下的路由@app.route 映射url,一样的道理
- 然后就是这里传参数是同过reqparse这个模块去传参的,然后在类方法下接收参数,然后在浏览器里访问的时候,要通过固定的格式去访问地址,比方说我写了 api.add_resource(SearchHotNews, '/hot'),那么之前我又规定了三个参数query,pagesize,currentpage,那么我访问的时候,就应该访问地址http://localhost:5000/hot?query=google&pagesize=10¤tpage=0
- 同时最后我想说明一点的是,els的查询参数里面可以传入size, from_两个参数来达到分页目的,就是查询结果是从第几个开始的,一页返回多少个结果
- 关于如何向els里面插入数据,代码很简单,首先新建一个字典,代表你要插入的数据,res = {}, es.index(index='indexname', doc_type='xxx', id='xxx', body=res)即可
- 删除els中的index,es.indices.delete(index='indexname', ignore=[400, 404])
那么这一节的教程就结束了,接下来我会重点讲解如何实现读写分离,反正继续深入研究,因为这点东西肯定还不够,还有现在我很感兴趣的一个问题,如果有大神知道也可以告诉我一下啊,就是关于搜索引擎搜索关键词自动补全是怎么做的呢?
Algorithm for autocomplete?
我在stackoverflow上看到这个解答,还没有仔细研究代码怎么写
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31509949/viewspace-3121637/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- GitHub 上已有 1400+ Claude Code Skills,真正在用的就这几个
- 开多个 Agent 后 Claude Code 账单翻了 4 倍,一个配置解决了
- 2026 年了,你还不会写 Claude Code Skill?AI 工具的下一个标准已经定了
- Claude Code v2.1.139 新增 Agent 视图颠覆了工作流,这次设计比功能更值得看
- Google 开源了一个14900 Star 项目,让 AI Agent 碰数据库不再是定时炸弹
- 总觉得Claude Code 写完代码有问题?我用了一个开源 Skill 编排了 7 阶段严谨开发工作流,拦下 10 个 Critical Bug
- Spring AI Session API:大多数人用 ChatMemory 用错了场景
- R语言实战:个人贷款违约预测模型 (基于银行的个人金融业务数据进行分析)
- 汽车 4S 集团 BI 数据可视化分析案例
- IT基础架构运维服务认知
