胖头鱼的技术专栏-453 让冷数据"冷"得其所(20260730)
作者:胖头鱼的鱼缸(尹海文)
Oracle ACE Pro: Database
PostgreSQL ACE
10年+数据库行业经验
拥有OCM 11g/12c/19c、MySQL 8.0 OCP、Exadata、CDP等认证
墨天轮MVP,ITPUB认证专家
圈内拥有“总监”称号,非著 名社恐(社交恐怖分子)
全网同名:胖头鱼的鱼缸
ITPUB:yhw1809
除授权转载并标明出处外,均为“非法”抄袭

去年9月,在深圳举行的2025腾讯全球生态大会,在"数据库+AI"专场上,我很荣幸获得了腾讯云数据库的认可,成为腾讯云数据库MVP。同一场里还有主题演讲讲TDSQL家族的新方向。说实话,之前我对TDSQL的印象比较模糊——知道它是腾讯云数据库的主力产品线,但具体有哪些分支、各自定位是什么,一直没太细究。那场演讲里我第一次听到了一个名字—— TDSQL-Boundless。
多主写入、透明分布式架构,听着听着我觉得有点意思。之后我一直留意着TDSQL-Boundless的动态,最近发现它上线了一个新特性—— 冷数据归档。
冷数据归档是DBA比较熟悉的技术。Oracle那边有Heat Map加ILM,冷热分层非常体系化的;PostgreSQL比较野路子,用外部表挂个fdw把数据甩到别的存储上去。大家的思路都差不多——把冷数据从贵的存储挪到便宜的地方去。
作为腾讯云数据库MVP,最近我也受邀参加腾讯云数据库邀请进行新版本测试。这篇就来聊聊TDSQL-Boundless的冷数据归档——它是什么、怎么干的、有什么限制,以及我边写边跑的测试。
先说一句关键的:冷数据归档目前是 V21.6.3.0 版本的邀测特性,白名单功能,限制不少。后面我会专门总结,但这一点开头就要心里有数。
1 TDSQL-Boundless简介
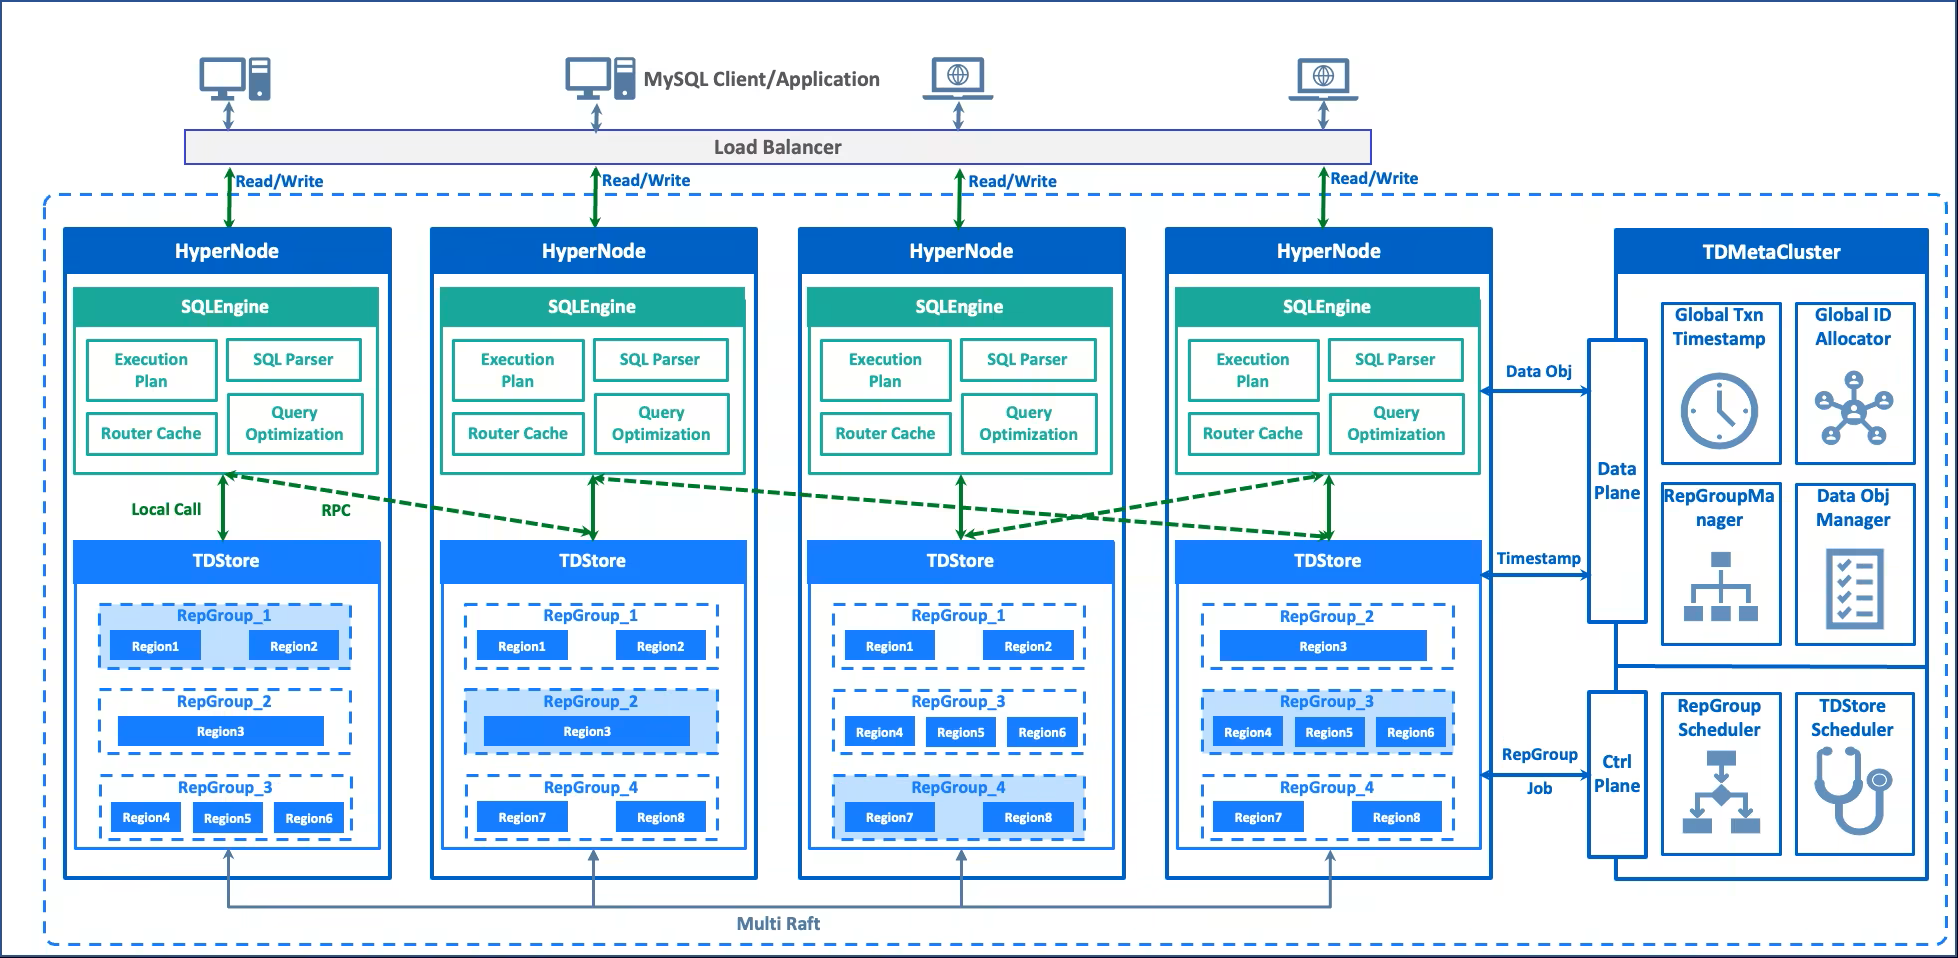
TDSQL-Boundless是腾讯云自主研发的新一代分布式数据库,TDSQL家族的成员。它想干的事很简单——通过透明分布式架构和弹性扩缩容,让企业不用再操心底层数据架构那堆复杂的东西。
几个我比较关注的点:
- 多主写入——每个节点都能写,没有主从架构里从节点闲着吃干饭的问题
- LSM-Tree存储引擎——压缩率高,存得多占用少,花钱也就少
- RPO=0——多副本容灾+自动故障切换,数据零丢失
- 高度兼容MySQL——现有MySQL应用基本无损迁移
- 数据亲和性调度——主键、索引、关联表的数据会智能调度到同一个节点上,分布式事务变单机事务,避免网络vs内存带来的性能影响
- HTAP能力——可插拔只读分析实例,列式存储,按需开
2 什么是冷数据归档
做过业务系统的都懂—— 数据会变冷。
订单刚生成,你可能天天查;过了三个月,偶尔翻一下;一年以后,基本不看——但你不敢删。审计要查、合规要留、对账要用,这些理由够你把那些"僵尸数据"一直留在最贵的本地高性能存储上。
这两年硬件成本涨得不是一点半点,尤其是SSD。闪存颗粒产能变化加上需求量飞速增加,企业级SSD的价格一路往上走,扩容本地盘的成本压力越来越大。以前冷数据占着贵存储还能忍忍,现在成了实打实的成本问题——同样一块盘,价格涨了,你还得往里塞更多不怎么用的数据。
TDSQL-Boundless的冷数据归档就是来干这个的—— 把冷数据从本地存储下沉到对象存储(COS),让不同的数据住不同价位的地方。
热数据就像客厅里天天用的东西,伸手就够到;冷数据像换季衣服——你不扔,但放进储物间,需要时去拿,平时不占客厅空间。
几个核心优势:
- 成本:冷数据转储到COS,本地高性能存储用量大幅下降;
- 透明:归档表对应用完全透明,标准SQL读写,不改业务代码;
- 平滑:热数据照旧在本地高性能存储;冷数据写入先落本地缓冲再异步上传COS,读时先查本地缓存再回源COS;
- 容量:冷数据存COS上,不受单节点本地存储规格限制;
- 可靠:冷数据落COS后由对象存储承载持久化和多副本,本地存储坏了也不影响冷数据。
3 三层架构实现冷数据归档
冷数据归档在热数据存储之上,加了两层,形成三层:
| 层级 | 名称 | 介质 | 干什么 |
|---|---|---|---|
| 热数据层 | DataDB | 本地SSD/高性能云盘 | 没转冷的数据,读写性能不变 |
| 冷缓冲层 | CacheDB | 节点本地 | 冷表近期写入和正在上传COS的数据,写入不直接依赖远端COS |
| 冷归档层 | DurableDB | 对象存储COS | 冷数据的最终归属地,按复制组(RG)持久化 |
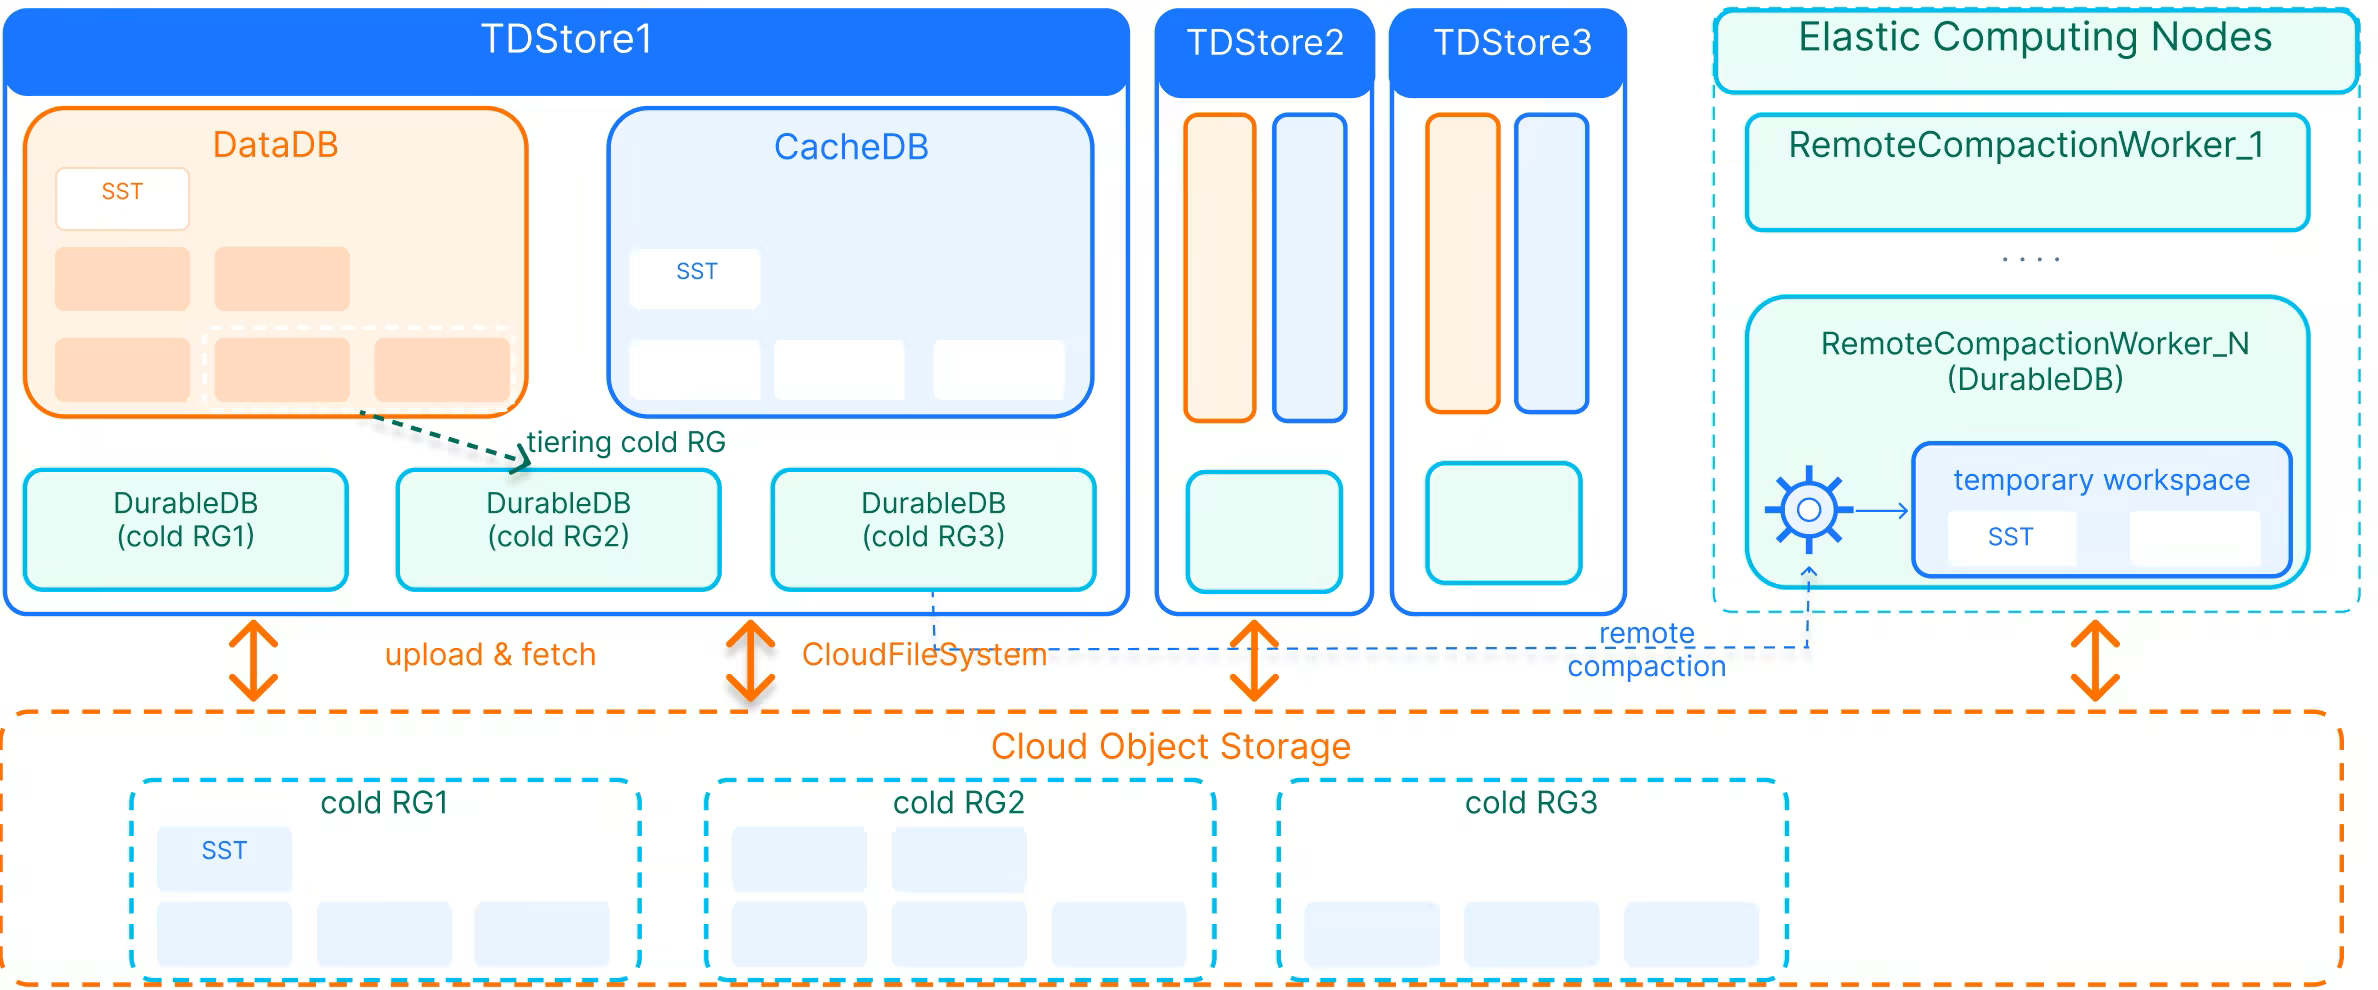
写的时候:请求先到CacheDB落盘成SST文件,攒够了再异步上传到COS(DurableDB),上传完成后本地SST异步清掉。应用那边看到的是同步写入,感觉不到延迟。
读的时候:系统把CacheDB和DurableDB的数据合并起来返回完整结果。最近写的数据大概率在CacheDB里就能命中,历史全量数据走DurableDB。从COS拉回来的数据会放进本地COS file cache,下次再查就快了。
转冷过程:跑7个阶段——Validating(校验)→ DrainingTransactions(等活跃事务收尾)→ Preparing(准备上下文)→ ExportingSnapshot(导出快照)→ Uploading(分批上传COS)→ Committing(提交标记冷分片)→ Done(结束)。转冷期间对该表的写入会双写DataDB和CacheDB——成功了数据在CacheDB,失败了回退则数据还在DataDB,不会丢。
4 使用方式
需要在数据库控制台中打开数据库归档功能:
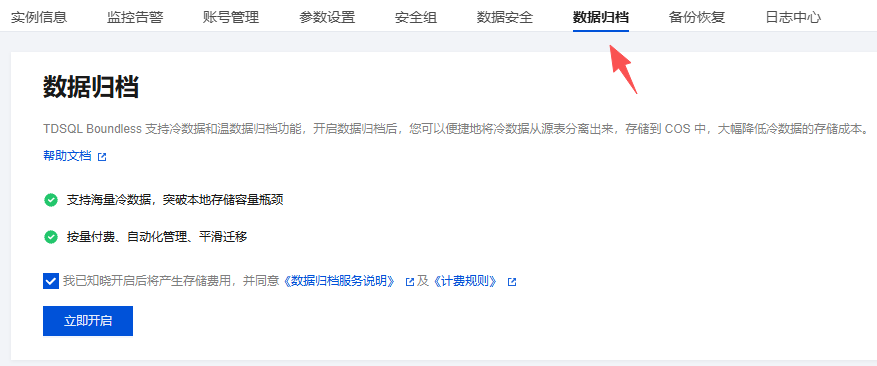
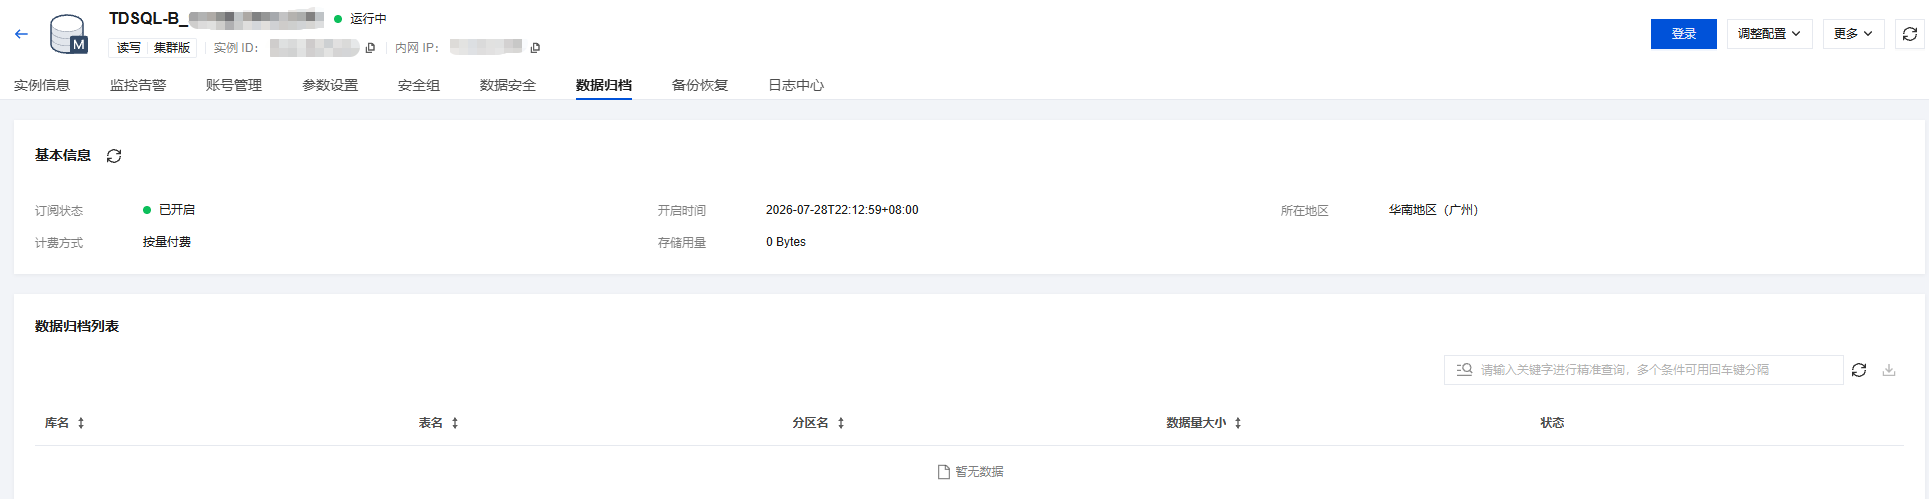
冷数据归档的用法,说白了就是在表上加一个
STORAGE_TIER属性。三个取值:
| 取值 | 含义 |
|---|---|
AUTO |
系统默认,当前等同
LOCAL_STORAGE |
LOCAL_STORAGE |
本地热存储 |
OBJECT_STORAGE |
对象存储冷归档 |
创建冷数据表:
CREATE TABLE archive_log (
  id BIGINT PRIMARY KEY,
  log_time DATETIME,
  payload TEXT) STORAGE_TIER = OBJECT_STORAGE;
分区表按时间分层——近期热、历史冷:
CREATE TABLE order_history (  id BIGINT,
  order_date DATE,
  amount DECIMAL(10,2),
  PRIMARY KEY (id, order_date)
)PARTITION BY RANGE COLUMNS (order_date) (
  PARTITION p_2023 VALUES LESS THAN ('2024-01-01') STORAGE_TIER = OBJECT_STORAGE,
  PARTITION p_2024 VALUES LESS THAN ('2025-01-01') STORAGE_TIER = OBJECT_STORAGE,
  PARTITION p_2025 VALUES LESS THAN ('2026-01-01') STORAGE_TIER = LOCAL_STORAGE
);
已有热表整表转冷:
ALTER TABLE archive_log STORAGE_TIER = OBJECT_STORAGE;
已有分区单独转冷:
ALTER TABLE order_history
MODIFY PARTITION (p_2024) STORAGE_TIER = OBJECT_STORAGE;
查转冷进度——重复执行直到stage为Done、err_msg为空:
SELECT
  node_name, rep_group_id, stage,
  uploaded_file_num, total_file_num, progress_pct,
  elapsed_time_ms, err_msg
FROM information_schema.TDSTORE_TIERING_COLD_RG_JOB_PROGRESS
ORDER BY rep_group_id;
查冷热数据用量分布:
SELECT
  TABLE_SCHEMA, TABLE_NAME, PARTITION_NAME, INDEX_NAME,
  CACHE_DB_SIZE, DURABLE_DB_SIZE, TOTAL_SIZE
FROM information_schema.TDSTORE_TIERED_STORAGE_USAGE;
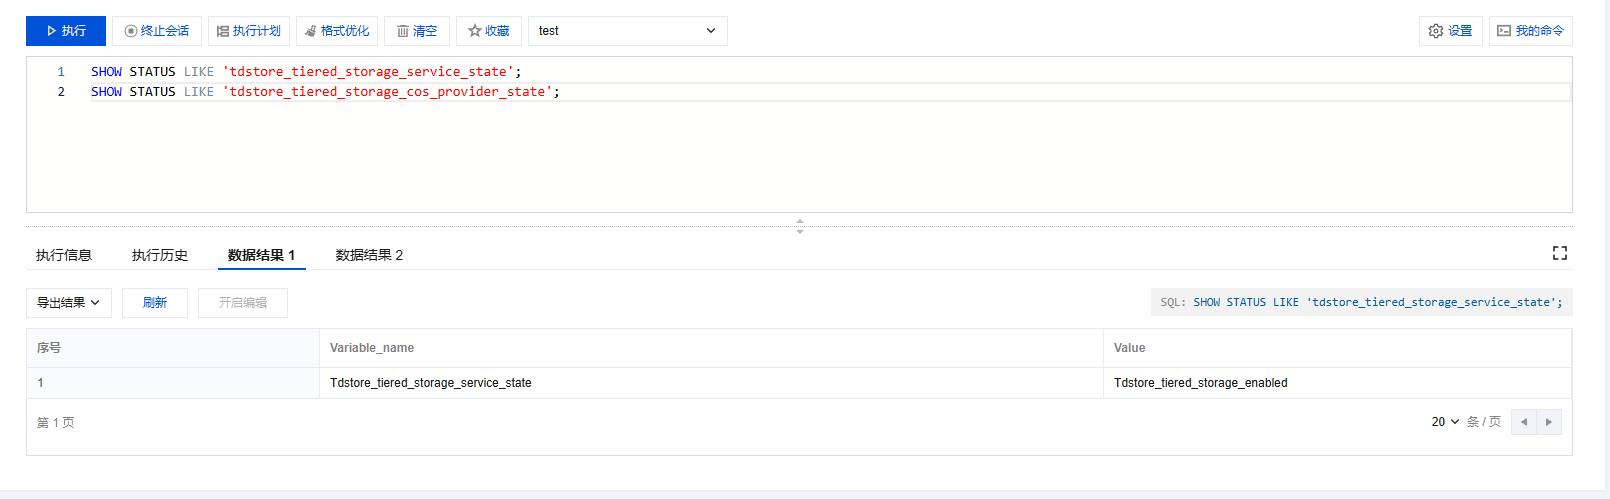
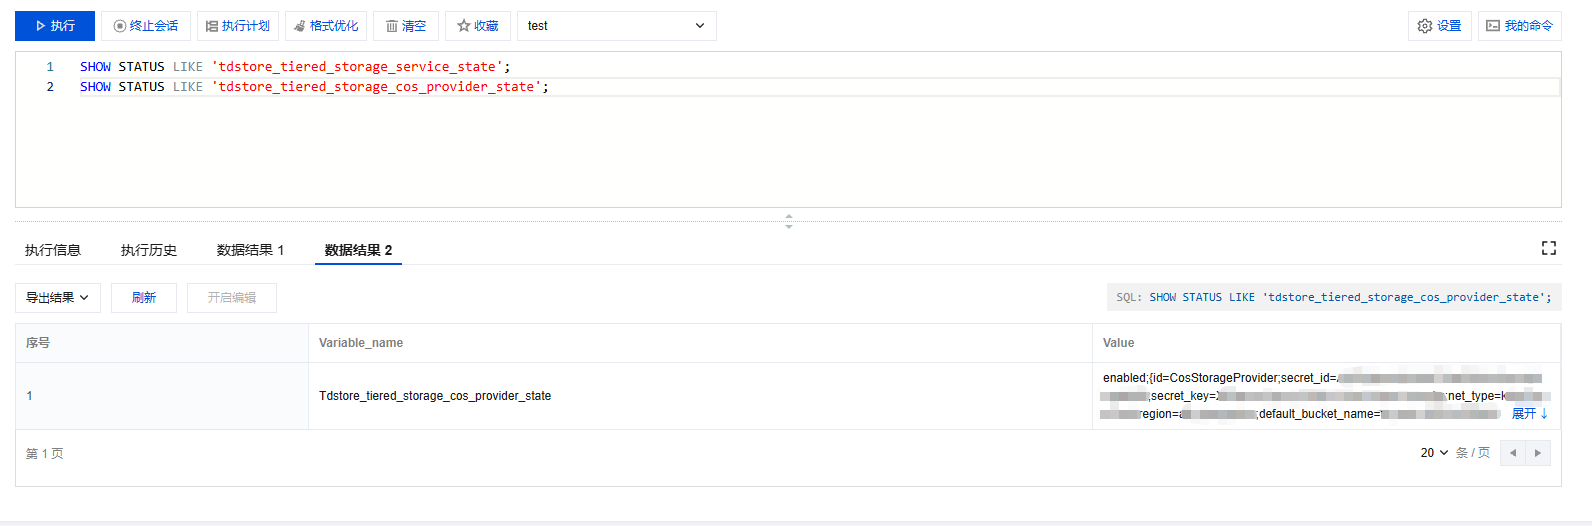
查分层存储服务是否正常启用:
SHOW STATUS LIKE 'tdstore_tiered_storage_service_state';
-- 返回 tdstore_tiered_storage_enabled = 已启用
SHOW STATUS LIKE 'tdstore_tiered_storage_cos_provider_state';
-- 返回 enabled + 配置摘要 = COS接入正常
5 实战测试
写这篇文章的同时,我在腾讯云上开了一个TDSQL-Boundless试用实例,MySQL 8.0兼容模式。下面是六组冷数据归档的实测,使用腾讯云DMC访问数据库。
测试1:冷表基本功能
测试内容:建冷表、写数据、读数据,看是不是真的对应用透明。
-- 建冷表
CREATE TABLE cold_test_basic (
  id BIGINT PRIMARY KEY,
  user_id BIGINT,  content TEXT,
  create_time DATETIME DEFAULT CURRENT_TIMESTAMP) STORAGE_TIER = OBJECT_STORAGE;

-- 批量写1000条
CREATE PROCEDURE insert_cold_basic()BEGIN
  DECLARE i INT DEFAULT 0;
  WHILE i < 1000 DO
    INSERT INTO cold_test_basic (id, user_id, content)
    VALUES (i, FLOOR(RAND() * 10000), CONCAT('test_content_', i));
    SET i = i + 1;
  END WHILE;
ENDCALL insert_cold_basic();
-- 验完整性
SELECT COUNT(*) FROM cold_test_basic;
SELECT * FROM cold_test_basic WHERE id = 500;
-- 验写入同步可见
INSERT INTO cold_test_basic (id, user_id, content) VALUES (99999, 1, 'immediate_check');
SELECT * FROM cold_test_basic WHERE id = 99999;
-- 看冷热分布
SELECT
  TABLE_SCHEMA, TABLE_NAME,
  SUM(CACHE_DB_SIZE)   AS cache_total,
  SUM(DURABLE_DB_SIZE) AS durable_total
FROM information_schema.TDSTORE_TIERED_STORAGE_USAGE
WHERE TABLE_NAME = 'cold_test_basic'
GROUP BY TABLE_SCHEMA, TABLE_NAME;
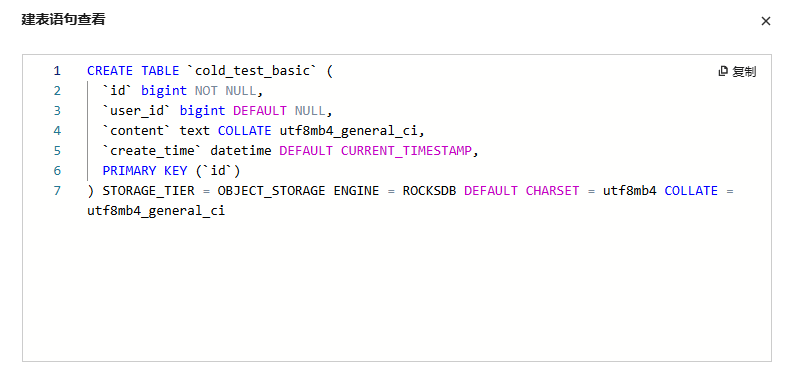





预期结果:1001条全能看到,
SHOW CREATE TABLE有
STORAGE_TIER = OBJECT_STORAGE,用量视图里
DURABLE_DB_SIZE > 0。
实际测试结果,显示
DURABLE_DB_SIZE并没有>0,且在数据归档列表中显示状态为
pending,其原因是默认配置下
cache_total达到2.5GB后才会开始异步归档。
测试2:热表转冷全流程
测试内容:已有热表数据转冷——数据会不会丢,转冷完还能不能继续写。
-- 建热表,写10000条
CREATE TABLE hot_to_cold (
  id BIGINT PRIMARY KEY,
  order_no VARCHAR(32),
  amount DECIMAL(10,2),
  status TINYINT,
  create_time DATETIME DEFAULT CURRENT_TIMESTAMP) STORAGE_TIER = LOCAL_STORAGE;

CREATE PROCEDURE insert_hot_to_cold()BEGIN
  DECLARE i INT DEFAULT 0;
  WHILE i < 10000 DO
    INSERT INTO hot_to_cold (id, order_no, amount, status)
    VALUES (i, CONCAT('ORD', LPAD(i, 8, '0')), ROUND(RAND() * 10000, 2), FLOOR(RAND() * 4));
    SET i = i + 1;
  END WHILE;
END
CALL insert_hot_to_cold();
-- 记转冷前的行数和校验和
SELECT COUNT(*) AS before_count FROM hot_to_cold;
SELECT COALESCE(SUM(id), 0) AS before_sum FROM hot_to_cold;
-- 触发转冷
ALTER TABLE hot_to_cold STORAGE_TIER = OBJECT_STORAGE;
-- 监控进度(重复执行直到 stage = Done)
SELECT
  node_name, rep_group_id, stage,
  uploaded_file_num, total_file_num, progress_pct,
  elapsed_time_ms, err_msg
FROM information_schema.TDSTORE_TIERING_COLD_RG_JOB_PROGRESS
ORDER BY rep_group_id;
-- 转冷完了验完整性
SELECT COUNT(*) AS after_count FROM hot_to_cold;
SELECT COALESCE(SUM(id), 0) AS after_sum FROM hot_to_cold;
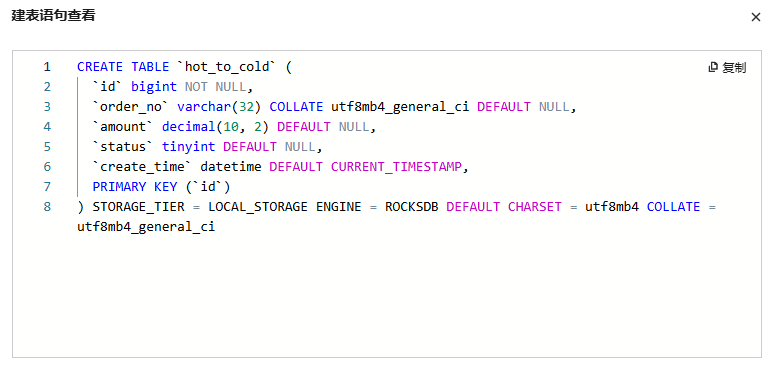


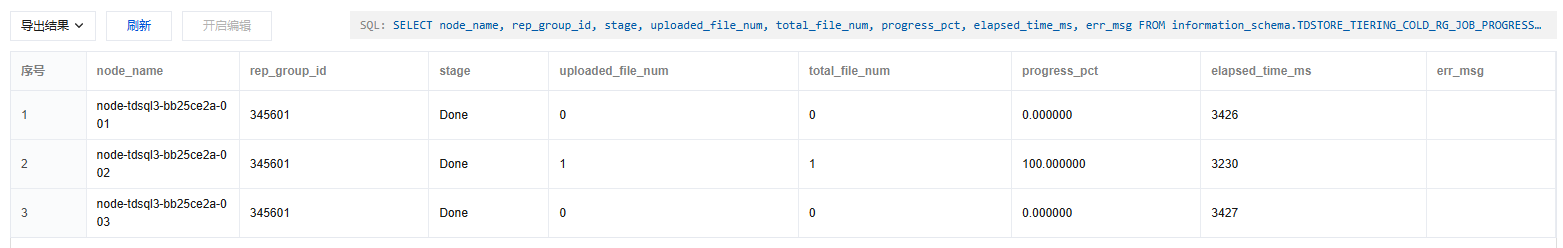


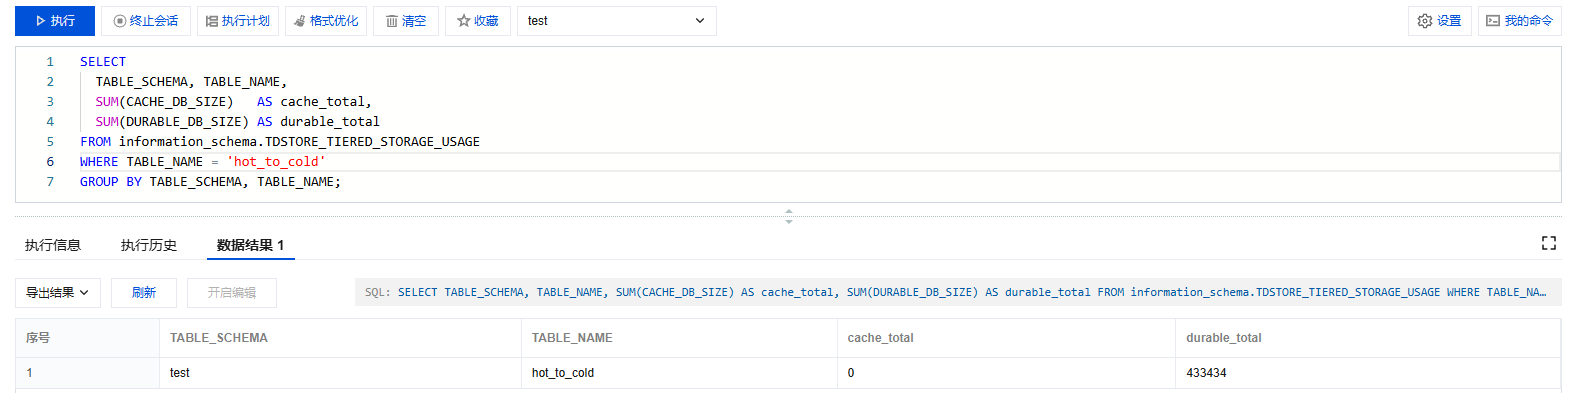
预期结果:前后行数一致、校验和一致,转冷后新数据立即可查。
在本测试中可以看到最终数据已经转储到对象存储之中。
测试3:分区表冷热混合
测试内容:同一张分区表,冷分区和热分区混着查,以及热分区后续转冷。
-- 建分区表,历史分区冷、近期分区热
CREATE TABLE partition_cold_hot (
  id BIGINT,
  record_date DATE,
  data_payload TEXT,
  PRIMARY KEY (id, record_date)
)PARTITION BY RANGE COLUMNS (record_date) (
  PARTITION p_202501 VALUES LESS THAN ('2025-02-01') STORAGE_TIER = OBJECT_STORAGE,
  PARTITION p_202502 VALUES LESS THAN ('2025-03-01') STORAGE_TIER = OBJECT_STORAGE,
  PARTITION p_202503 VALUES LESS THAN ('2025-04-01') STORAGE_TIER = OBJECT_STORAGE,
  PARTITION p_202504 VALUES LESS THAN ('2025-05-01') STORAGE_TIER = LOCAL_STORAGE,
  PARTITION p_202505 VALUES LESS THAN ('2026-01-01') STORAGE_TIER = LOCAL_STORAGE
);
-- 各分区写数据
INSERT INTO partition_cold_hot VALUES (1, '2025-01-15', 'jan_data');
INSERT INTO partition_cold_hot VALUES (2, '2025-02-20', 'feb_data');
INSERT INTO partition_cold_hot VALUES (3, '2025-03-10', 'mar_data');
INSERT INTO partition_cold_hot VALUES (4, '2025-04-05', 'apr_data');
INSERT INTO partition_cold_hot VALUES (5, '2025-05-01', 'may_data');
-- 跨冷热分区联合查询
SELECT * FROM partition_cold_hot ORDER BY record_date;
SELECT COUNT(*) FROM partition_cold_hot WHERE record_date < '2025-04-01';
SELECT COUNT(*) FROM partition_cold_hot WHERE record_date >= '2025-04-01';
-- 指定冷分区查
SELECT * FROM partition_cold_hot PARTITION (p_202501);
-- 指定热分区查
SELECT * FROM partition_cold_hot PARTITION (p_202504);
-- 热分区转冷
ALTER TABLE partition_cold_hot  MODIFY PARTITION (p_202504) STORAGE_TIER = OBJECT_STORAGE;
-- 转冷后还能查
SELECT * FROM partition_cold_hot PARTITION (p_202504);
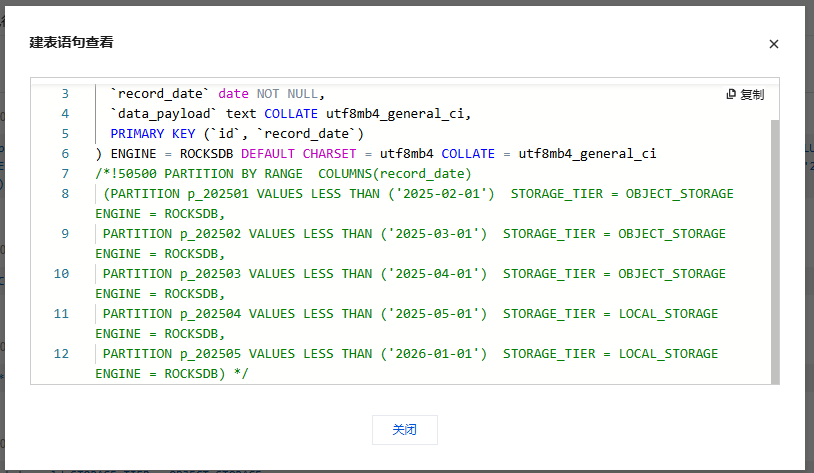
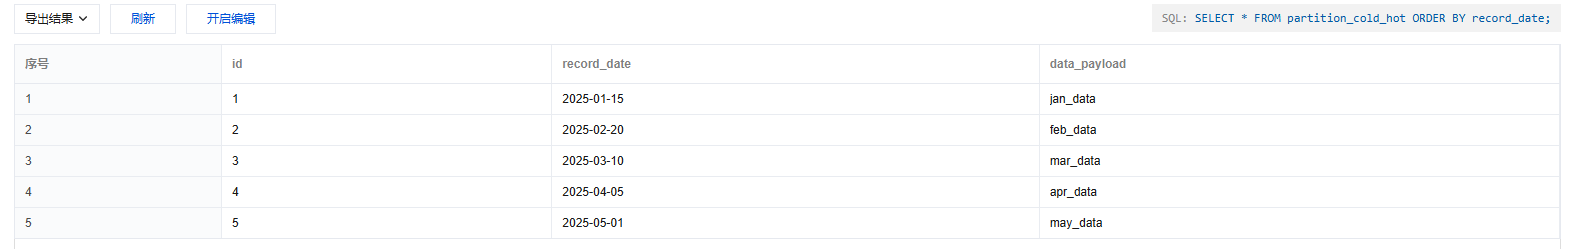




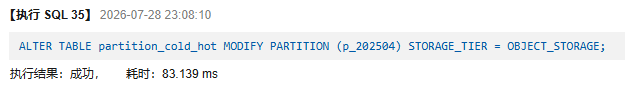

预期结果:跨冷热分区查询正常返回完整结果,热分区转冷后查询方式不变。
测试4:性能对比——热表 vs 冷表
测试内容:同样的数据结构、同样的数据量,热表和冷表的查询延迟差多少,以及冷表二次查询是不是更快(COS file cache效果)。
-- 建两张结构一样的表,一热一冷
CREATE TABLE perf_hot (
  id BIGINT PRIMARY KEY,
  val_a INT,
  val_b VARCHAR(100),
  ts DATETIME DEFAULT CURRENT_TIMESTAMP) STORAGE_TIER = LOCAL_STORAGE;

CREATE TABLE perf_cold (
  id BIGINT PRIMARY KEY,
  val_a INT,
  val_b VARCHAR(100),
  ts DATETIME DEFAULT CURRENT_TIMESTAMP) STORAGE_TIER = OBJECT_STORAGE;

-- 各写50000条
CREATE PROCEDURE insert_perf_data()
BEGIN
  DECLARE i INT DEFAULT 0;
  WHILE i < 50000 DO
    INSERT INTO perf_hot (id, val_a, val_b) VALUES (i, FLOOR(RAND() * 1000000), CONCAT('val_', i));
    INSERT INTO perf_cold (id, val_a, val_b) VALUES (i, FLOOR(RAND() * 1000000), CONCAT('val_', i));
    SET i = i + 1;
  END WHILE;
END

CALL insert_perf_data();
-- 等冷表数据完全上传COS后,对比延迟
-- 点查(首 次访问)
SELECT * FROM perf_hot WHERE id = 25000;
SELECT * FROM perf_cold WHERE id = 25000;
-- 范围查询
SELECT * FROM perf_hot WHERE id BETWEEN 10000 AND 10999;
SELECT * FROM perf_cold WHERE id BETWEEN 10000 AND 10999;
-- 聚合查询
SELECT COUNT(*), AVG(val_a), MAX(val_a), MIN(val_a) FROM perf_hot;
SELECT COUNT(*), AVG(val_a), MAX(val_a), MIN(val_a) FROM perf_cold;
-- 二次点查冷表同一条数据(验证cache加速)
SELECT * FROM perf_cold WHERE id = 25000;
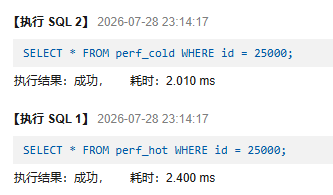


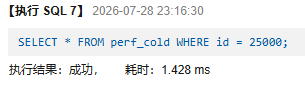
预期结果:冷表首 次查询延迟高于热表,但二次查询延迟明显下降——COS file cache生效。
实际测试中,不得不说数据量较小,和测试1情况类似,冷表数据其实还未进入COS,而
CacheDB的性能看起来还真是不错,对比查询仅聚合查询慢一些。
测试5:限制条件验证
测试内容:文档里说了一堆"不支持",跑几个验证看看是不是真不支持,以及哪些操作冷表还能做。
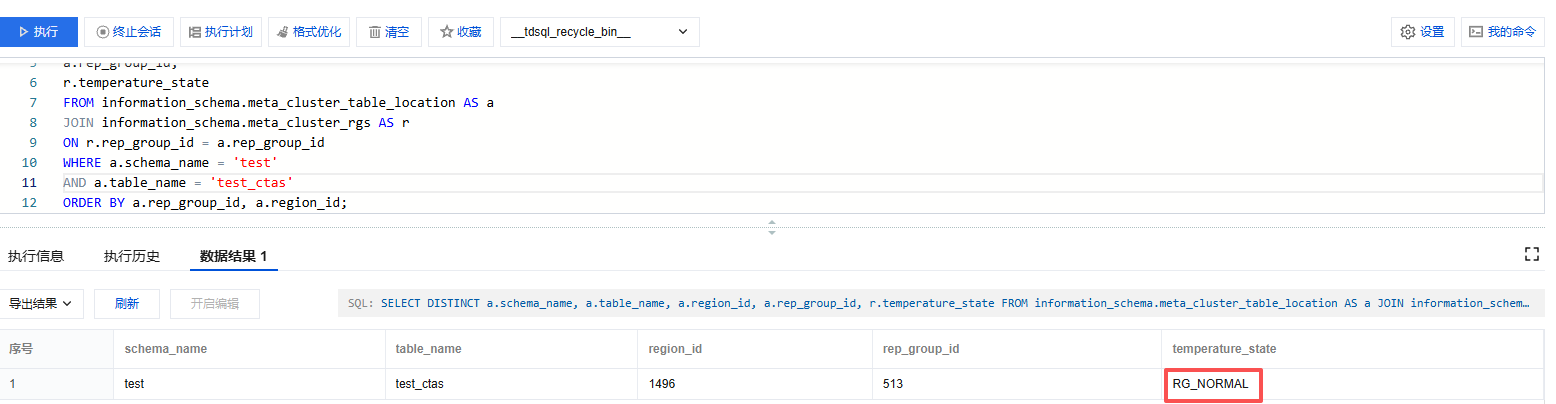
-- 不支持 CREATE TABLE ... AS SELECT(预期报错)
CREATE TABLE test_ctas AS SELECT * FROM perf_hot;
CREATE TABLE test_ctas AS SELECT * FROM perf_cold;
-- 冷表支持有限Online DDL(加列)
ALTER TABLE perf_cold ADD COLUMN extra VARCHAR(50) DEFAULT 'N';
SELECT extra FROM perf_cold LIMIT 1;
-- TRUNCATE冷表
TRUNCATE TABLE perf_cold;
SELECT COUNT(*) FROM perf_cold;

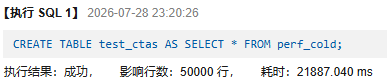
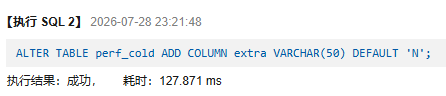

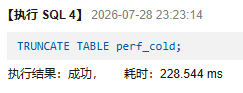

预期结果:CTAS报错,其余操作正常执行。
实际测试中,CTAS好像支持了,但其实这里有一个小限制,向冷表执行CTAS其实无法直接复制成冷表,新表被创建为热表。
测试6:转冷过程中并发写入
测试内容:一张表正在转冷,另一个会话同时在往里写数据——会不会丢。
-- 建热表,写5000条初始数据
CREATE TABLE concurrent_test (
  id BIGINT PRIMARY KEY,
  batch_id INT,
  content VARCHAR(200),
  ts DATETIME DEFAULT CURRENT_TIMESTAMP) STORAGE_TIER = LOCAL_STORAGE;

CREATE PROCEDURE insert_concurrent_init()
BEGIN
  DECLARE i INT DEFAULT 0;
  WHILE i < 5000 DO
    INSERT INTO concurrent_test (id, batch_id, content)
    VALUES (i, 1, CONCAT('initial_', i));
    SET i = i + 1;
END WHILE;
END
CALL insert_concurrent_init();
-- 会话A:触发转冷
ALTER TABLE concurrent_test STORAGE_TIER = OBJECT_STORAGE;
-- 会话B:同时持续写入
INSERT INTO concurrent_test (id, batch_id, content) VALUES (5001, 2, 'concurrent_5001');
INSERT INTO concurrent_test (id, batch_id, content) VALUES (5002, 2, 'concurrent_5002');
INSERT INTO concurrent_test (id, batch_id, content) VALUES (5003, 2, 'concurrent_5003');
INSERT INTO concurrent_test (id, batch_id, content) VALUES (5004, 2, 'concurrent_5004');
INSERT INTO concurrent_test (id, batch_id, content) VALUES (5005, 2, 'concurrent_5005');
-- 转冷完了验数据总量,检查并发写入数据无丢失
SELECT COUNT(*) AS total_count FROM concurrent_test;
SELECT COUNT(*) AS batch1_count FROM concurrent_test WHERE batch_id = 1;
SELECT COUNT(*) AS batch2_count FROM concurrent_test WHERE batch_id = 2;



预期结果:初始数据和并发写入数据都完整,不丢。
六、邀测特性的限制
前面说了,冷数据归档是 V21.6.3.0版本的邀测特性。邀测的实验特性嘛,限制少不了,我整理了一个速查表:
| 类别 | 限制 | 一句话说明 | 备注 |
|---|---|---|---|
| 不可逆 | 开启后不能关闭 | 一旦开启,关不掉 | - |
| 不可逆 | 冷数据不能回暖 | 转了冷就回不了热 | 已确认将在后续版本中支持 |
| 备份恢复 | 不支持备份恢复 | 开启后不能备份恢复,也不能建灾备实例 | 已确认将在后续版本中支持 |
| 容量调整 | 不能缩容 | 缩节点、缩磁盘、迁移变配、调可用区/副本数都不行 | 已确认将在后续版本中支持 |
| 数据导入 | 不支持Bulk Load | Bulk Load和LOAD DATA INFILE都不行 | 已确认将在后续版本中支持 |
| DDL | 不支持CTAS |
CREATE TABLE ... AS SELECT报错 |
实测不会报错,但无法直接创建冷表 |
| DDL | 不支持Fast Online DDL | 冷表只支持有限的Online DDL | - |
| 互斥 | 与Binlog服务互斥 | 二选一 | - |
| 互斥 | 与只读分析引擎互斥 | 二选一 | - |
| 互斥 | 与KV分离互斥 | 开了KV分离的数据没法转冷 | - |
| 互斥 | 与大事务特性互斥 | 不能开 | - |
| 互斥 | 与TDE互斥 | 不能开透明加密 | - |
| 调度 | 冷RG不能分裂/合并/迁移 | 冷分片的调度任务不支持 | 已确认将在后续版本中支持 |
| 自动化 | 不能自动转冷 | 只能手动SQL指定 | 已确认将在后续版本中支持 |
针对后续版本功能更新与发布时间,官方也给了我具体信息:
V21.6.4.0,发布时间2026.8.30:
- 备份恢复功能
- 缩容(缩节点、迁移变配)
V21.6.5.0,发布时间2026.10.30:
- 冷数据回暖
- Bulk Load 数据快速导入冷存
- 调度(冷RG分裂、合并、迁移)
- 自动转冷
当前版本V21.6.3.0邀测特性适合在测试环境验证思路,离生产环境大规模用还有距离,期待后续版本更新。
总结
TDSQL-Boundless的冷数据归档,三层架构(DataDB→CacheDB→DurableDB)设计得比较务实,"先本地后远端"写、"先查本地再查远端"读,数据安全有保障,性能也有一定的保障。
老规矩,知道写了些啥。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31466763/viewspace-3177173/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 胖头鱼的技术专栏-479 如何高效地将喂给 AI 的数据搬过去(20261015)
- 胖头鱼的技术专栏-478 Agent 成了新用户,数据库要接住它的下一步(20261014)
- 胖头鱼的技术专栏-477 26ai新特性实战:表达式分区(20261013)
- 胖头鱼的技术专栏-476 26ai新特性实战:聚合过滤(20261012)
- 胖头鱼的技术专栏-475 蹭到最后,就没人摆摊了(20261010)
- 胖头鱼的技术专栏-474 从能跑到能上线:PG SplitJSON 0.2.0 和 0.1.0 差在哪
- 胖头鱼的技术专栏-473 26ai新特性实战:日历函数(20261004)
- 胖头鱼的技术专栏-473 改JSON的一个字段不再重写整篇:我给PostgreSQL 18写了个扩展
- 胖头鱼的技术专栏-472 26ai新特性实战:无 FROM 子句的 SELECT 语句(20261003)
- 胖头鱼的技术专栏-471 数据库优化的三层楼——为什么多数人总在第二层打转
