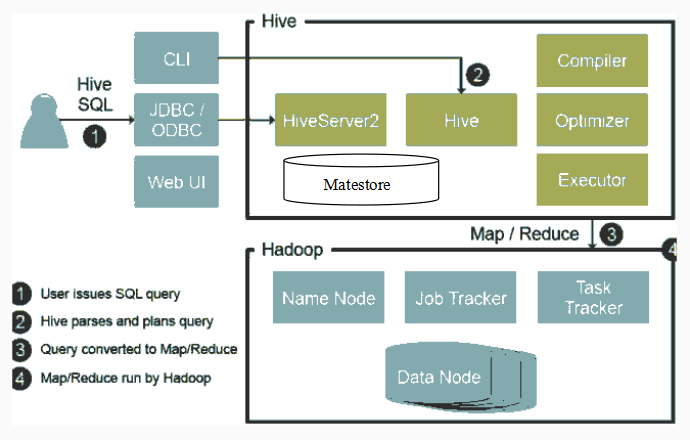
Hive架构图
主要分为以下几个部分:
- 用户接口,包括 命令行CLI,Client,Web界面WUI,JDBC/ODBC接口等
- 中间件:包括thrift接口和JDBC/ODBC的服务端,用于整合Hive和其他程序。
- 元数据metadata存储,通常是存储在关系数据库如 mysql, derby 中的系统参数
- 底层驱动:包括HiveQL解释器、编译器、优化器、执行器(引擎)。
- Hadoop:用 HDFS 进行存储,利用 MapReduce 进行计算。
- 用户接口主要有三个:CLI,Client 和 WUI。其中最常用的是 CLI,Cli 启动的时候,会同时启动一个 Hive 副本。Client 是 Hive 的客户端,用户连接至 Hive Server。在启动 Client 模式的时候,需要指出 Hive Server 所在节点,并且在该节点启动 Hive Server。 WUI 是通过浏览器访问 Hive。
- Hive 将元数据存储在数据库中,如 mysql、derby。Hive 中的元数据包括表的名字,表的列和分区及其属性,表的属性(是否为外部表等),表的数据所在目录等。
- 解释器、编译器、优化器完成 HQL 查询语句从词法分析、语法分析、编译生成执行计划、优化以及生成最佳执行计划。生成的查询计划存储在 HDFS 中,并在随后有 MapReduce 调用执行。
- Hive 的数据存储在 HDFS 中,大部分的查询由 MapReduce 完成(包含 * 的查询,比如 select * from tbl 不会生成 MapRedcue 任务)。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/31383567/viewspace-2145125/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
Hive之 数据存储

请登录后发表评论
登录
全部评论
最新文章
- Xtrabackup 2.4.18:Unable to obtain lock. Please try again later.
- 单表文件大小文件系统限制后删除部分数据仍无法插入新数据,报the table is full ...
- MySQL ib_logfile current_lsn < page_lsn 导致一查询就崩,如何恢复
- MySQL[bug] 子查询含用户变量,派生条件下推将导致不同版本的查询结果不一致
- MySQL 一个select把实例搞崩了,原来是表数据异常
- MySQL 8.0.25 Bug 报"MY-013132 The table ...is full"
- MySQL 8.x ,查询performance_schema.data_locks造成整个实例 hang了?
- 在启用所有PS性能模式工具的情况下,性能损耗过高,怎么办
- MySQL 如何重建/恢复删除的 sys Schema
- MySQL innodb buffer pool 命中率以及缓存了哪些 InnoDB Table
