数据库概念
数据库(Database,简称DB)是长期储存在计算机内、有组织的、可共享的大量数据的集合。
- 数据库系统的特点
- 数据结构化
- 数据的共享性高,冗余度低,易扩充
- 数据独立性高
- 数据由DBMS统一管理和控制
- 两大类数据模型
- 概念模型也称信息模型,它是按用户的观点来对数据和信息建模,用于数据库设计。
- 逻辑模型和物理模型,逻辑模型主要包括网状模型、层次模型、关系模型、面向对象模型等,按计算机系统的观点对数据建模,用于DBMS实现。物理模型是对数据最底层的抽象,描述数据在系统内部的表示方式和存取方法,在磁盘或磁带上的存储方式和存取方法。
- 关系数据库
- 关系数据库系统采用关系模型作为数据的组织方式,在用户观点下,关系模型中数据的逻辑结构是一张二维表,它由行和列组成。关系的每一个分量必须是一个不可分的数据项, 不允许表中还有表。
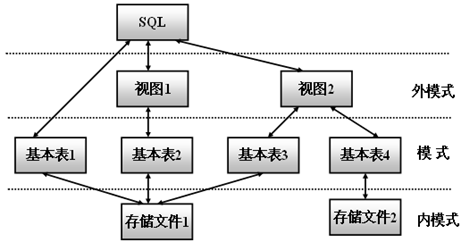
- 数据库系统的三级模式结构
- 模式(Schema)
- 外模式(External Schema)
- 内模式(Internal Schema)
- 关系模式
-
关系模式可以形式化地表示为:
R(U,D,DOM,F)
R 关系名
U 组成该关系的属性名集合
D 属性组U中属性所来自的域
DOM 属性向域的映象集合
F 属性间的数据依赖关系集合
- 实体完整性规则(Entity Integrity)
- 若属性A是基本关系R的主属性,则属性A不能取空值;关系模型中以主码作为唯一性标识。
- 参照完整性规则
-
若属性(或属性组)F是基本关系R的外码它与基本关系S的主码Ks相对应(基本关系R和S不一定是不同的关系),则对于R中每个元组在F上的值必须为:
- 或者取空值(F的每个属性值均为空值)
- 或者等于S中某个元组的主码值
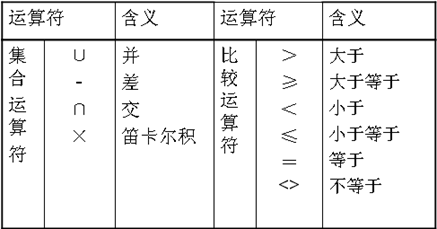
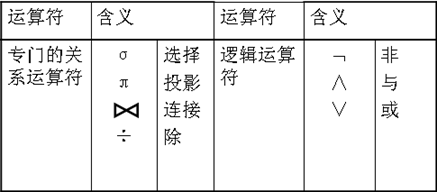
- 关系代数运算符
关系数据库标准语言SQL
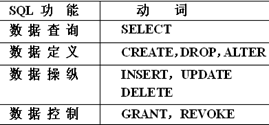
SQL(Structured Query Language)结构化查询语言,是关系数据库的标准语言。集数据定义语言(DDL),数据操纵语言(DML),数据控制语言(DCL)功能于一体。可以独立完成数据库生命周期中的全部活动:
- 定义关系模式,插入数据,建立数据库;
- 对数据库中的数据进行查询和更新;
- 数据库重构和维护
- 数据库安全性、完整性控制等
- 能完成核心功能9个动词
- SQL的基本概念
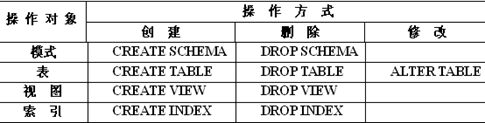
- 数据定义
-
定义模式
- 定义模式实际上定义了一个命名空间
- 在这个空间中可以定义该模式包含的数据库对象,例如基本表、视图、索引等。
-
在CREATE SCHEMA中可以接受CREATE TABLE,CREATE VIEW和GRANT子句。
CREATE SCHEMA <模式名> AUTHORIZATION <用户名>[<表定义子句>|<视图定义子句>|<授权定义子句>]
-
删除模式
DROP SCHEMA <模式名> <CASCADE|RESTRICT>
- CASCADE(级联)
删除模式的同时把该模式中所有的数据库对象全部删除
- RESTRICT(限制)
如果该模式中定义了下属的数据库对象(如表、视图等),则拒绝该删除语句的执行。当该模式中没有任何下属的对象时 才能执行。
-
定义基本表
CREATE TABLE <表名>
(<列名> <数据类型>[ <列级完整性约束条件> ]
[,<列名> <数据类型>[ <列级完整性约束条件>] ] …
[,<表级完整性约束条件> ] );
如果完整性约束条件涉及到该表的多个属性列,则必须定义在表级上,否则既可以定义在列级也可以定义在表级。
-
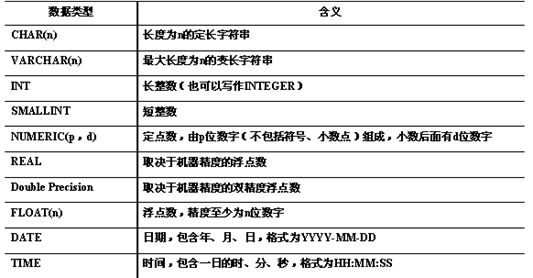
数据类型
-
模式与表
- 每一个基本表都属于某一个模式
- 一个模式包含多个基本表
- 定义基本表所属模式
-
方法一:在表名中明显地给出模式名
Create table "S-T".Student(......); /*模式名为 S-T*/
Create table "S-T".Cource(......);
Create table "S-T".SC(......);
- 方法二:在创建模式语句中同时创建表
- 方法三:设置所属的模式
-
修改基本表
ALTER TABLE <表名>
[ ADD <新列名> <数据类型> [ 完整性约束 ] ]
[ DROP <完整性约束名> ]
[ ALTER COLUMN<列名> <数据类型> ];
-
删除基本表
DROP TABLE <表名>[RESTRICT| CASCADE];
-
RESTRICT:删除表是有限制的。
- 欲删除的基本表不能被其他表的约束所引用
- 如果存在依赖该表的对象,则此表不能被删除
-
CASCADE:删除该表没有限制。
- 在删除基本表的同时,相关的依赖对象一起删除
-
-
索 引
-
RDBMS中索引一般采用B+树、HASH索引来实现
- B+树索引具有动态平衡的优点
- HASH索引具有查找速度快的特点
- 采用B+树,还是HASH索引 则由具体的RDBMS来决定
- 索引是关系数据库的内部实现技术,属于内模式的范畴
- CREATE INDEX语句定义索引时,可以定义索引是唯一索引、非唯一索引或聚簇索引
-
-
建立索引
-
语句格式
CREATE [UNIQUE] [CLUSTER] INDEX <索引名>
ON <表名>(<列名>[<次序>][,<列名>[<次序>] ]…);
- 在最经常查询的列上建立聚簇索引以提高查询效率
- 一个基本表上最多只能建立一个聚簇索引
- 经常更新的列不宜建立聚簇索引
-
-
删除索引
DROP INDEX <索引名>;
- 数据查询
-
语句格式
SELECT [ALL|DISTINCT] <目标列表达式>[,<目标列表达式>] …
FROM <表名或视图名>[, <表名或视图名> ] …
[ WHERE <条件表达式> ]
[ GROUP BY <列名1> [ HAVING <条件表达式> ] ]
[ ORDER BY <列名2> [ ASC|DESC ] ];
-
单表查询
- 选择表中的若干列
- 选择表中的若干元组
-
ORDER BY子句
- 可以按一个或多个属性列排序
- 升序:ASC;降序:DESC;缺省值为升序
- 当排序列含空值时
- ASC:排序列为空值的元组最后显示
- DESC:排序列为空值的元组最先显示
-
聚集函数
- 计数
- COUNT([DISTINCT|ALL] *)
- COUNT([DISTINCT|ALL] <列名>)
- 计算总和
- SUM([DISTINCT|ALL] <列名>)
- 计算平均值
- AVG([DISTINCT|ALL] <列名>)
- 最大最小值
- MAX([DISTINCT|ALL] <列名>)
- MIN([DISTINCT|ALL] <列名>)
- GROUP BY子句
- 查询的一般规律:先依据条件查询得到结果集,再将分组后的结果集筛选并排序。
-
HAVING短语与WHERE子句的区别:
- 作用对象不同
- WHERE子句作用于基表或视图,从中选择满足条件的元组
- HAVING短语作用于组,从中选择满足条件的组。
- 常用的查询条件
|
查 询 条 件 |
谓 词 |
|
比 较 |
=,>,<,>=,<=,!=,<>,!>,!<;NOT+上述比较运算符 |
|
确定范围 |
BETWEEN AND,NOT BETWEEN AND |
|
确定集合 |
IN,NOT IN |
|
字符匹配 |
LIKE,NOT LIKE |
|
空 值 |
IS NULL,IS NOT NULL |
|
多重条件(逻辑运算) |
AND,OR,NOT |
- ESCAPE '\' 表示" \" 为换码字符
-
连接查询
- 等值与非等值连接查询
-
自身连接
-
一个表与其自己进行连接
- 需要给表起别名以示区别
- 由于所有属性名都是同名属性,因此必须使用别名前缀
-
-
外连接
-
外连接与普通连接的区别
- 普通连接操作只输出满足连接条件的元组
- 外连接操作以指定表为连接主体,将主体表中不满足连接条件的元组一并输出
-
左外连接
- 列出左边关系(如本例Student)中所有的元组
-
右外连接
- 列出右边关系中所有的元组
-
- 复合条件连接
-
嵌套查询
一个SELECT-FROM-WHERE语句称为一个查询块
将一个查询块嵌套在另一个查询块的WHERE子句或HAVING短语的条件中的查询称为嵌套查询
-
子查询的限制
-
不能使用ORDER BY子句
- 层层嵌套方式反映了 SQL语言的结构化
- 有些嵌套查询可以用连接运算替代
-
-
嵌套查询求解方法
-
子查询的查询条件不依赖于父查询
- 由里向外 逐层处理。即每个子查询在上一级查询处理之前求解,子查询的结果用于建立其父查询的查找条件。
- 首先取外层查询中表的第一个元组,根据它与内层查询相关的属性值处理内层查询,若WHERE子句返回值为真,则取此元组放入结果表
- 然后再取外层表的下一个元组
- 重复这一过程,直至外层表全部检查完为止
-
-
带有比较运算符的子查询
- 当能确切知道内层查询返回单值时,可用比较运算符(>,<,=,>=,<=,!=或< >)。
- 与ANY或ALL谓词配合使用
-
带有ANY(SOME)或ALL谓词的子查询
-
需要配合使用比较运算符
- > ANY 大于子查询结果中的某个值
- > ALL 大于子查询结果中的所有值
- < ANY 小于子查询结果中的某个值
- < ALL 小于子查询结果中的所有值
- >= ANY 大于等于子查询结果中的某个值
- >= ALL 大于等于子查询结果中的所有值
- <= ANY 小于等于子查询结果中的某个值
- <= ALL 小于等于子查询结果中的所有值
- = ANY 等于子查询结果中的某个值
- =ALL 等于子查询结果中的所有值(通常没有实际意义)
- !=(或<>)ANY 不等于子查询结果中的某个值
- !=(或<>)ALL 不等于子查询结果中的任何一个值
-
-
带有EXISTS谓词的子查询
- 1. EXISTS谓词,存在量词$
-
带有EXISTS谓词的子查询不返回任何数据,只产生逻辑真值"true"或逻辑假值"false"。
- 若内层查询结果非空,则外层的WHERE子句返回真值
- 若内层查询结果为空,则外层的WHERE子句返回假值
- 由EXISTS引出的子查询,其目标列表达式通常都用* ,因为带EXISTS的子查询只返回真值或假值,给出列名无实际意义
-
2. NOT EXISTS谓词
- 若内层查询结果非空,则外层的WHERE子句返回假值
- 若内层查询结果为空,则外层的WHERE子句返回真值
-
-
集合查询
-
集合操作的种类
- 并操作UNION
- 交操作INTERSECT
- 差操作EXCEPT
- 参加集合操作的各查询结果的列数必须相同;对应项的数据类型也必须相同
-
-
SELECT语句的一般格式
SELECT [ALL|DISTINCT]
<目标列表达式> [别名] [ ,<目标列表达式> [别名]] …
FROM <表名或视图名> [别名]
[ ,<表名或视图名> [别名]] …
[WHERE <条件表达式>]
[GROUP BY <列名1>
[HAVING <条件表达式>]]
[ORDER BY <列名2> [ASC|DESC]
- 数据更新
-
插入数据
-
插入元组
- 语句格式
INSERT
INTO <表名> [(<属性列1>[,<属性列2 >…)]
VALUES (<常量1> [,<常量2>] … )
-
插入子查询结果
- 语句格式
INSERT
INTO <表名> [(<属性列1> [,<属性列2>… )]
子查询;
- 子查询
SELECT子句目标列必须与INTO子句匹配
- 值的个数
- 值的类型
-
- 修改数据
-
语句格式
UPDATE <表名>
SET <列名>=<表达式>[,<列名>=<表达式>]…
[WHERE <条件>];
- 删除数据
-
语句格式
DELETE
FROM <表名>
[WHERE <条件>];
- 视 图
- 虚表,是从一个或几个基本表(或视图)导出的表
- 只存放视图的定义,不存放视图对应的数据
- 基表中的数据发生变化,从视图中查询出的数据也随之改变
-
建立视图
- 语句格式
CREATE VIEW
<视图名> [(<列名> [,<列名>]…)]
AS <子查询>
[WITH CHECK OPTION];
-
删除视图
DROP VIEW <视图名>;
-
查询视图
- 用户角度:查询视图与查询基本表相同
- 视图的作用
- 视图能够简化用户的操作
- 视图使用户能以多种角度看待同一数据
- 视图对重构数据库提供了一定程度的逻辑独立性
- 视图能够对机密数据提供安全保护
- 适当的利用视图可以更清晰的表达查询
数据库安全性
- 数据库安全性控制的常用方法
- 用户标识和鉴定
- 存取控制
- 视图
- 审计
- 密码存储
-
关系数据库系统中存取控制对象

- 授权与回收
-
GRANT
- GRANT语句的一般格式:
GRANT <权限>[,<权限>]...
[ON <对象类型> <对象名>]
TO <用户>[,<用户>]...
[WITH GRANT OPTION];
- 语义:将对指定操作对象的指定操作权限授予指定的用户
-
WITH GRANT OPTION子句
-
WITH GRANT OPTION子句:
- 指定:可以再授予
- 没有指定:不能传播
- 不允许循环授权
-
-
REVOKE
- 授予的权限可以由DBA或其他授权者用REVOKE语句收回
- REVOKE语句的一般格式为:
REVOKE <权限>[,<权限>]...
[ON <对象类型> <对象名>]
FROM <用户>[,<用户>]...;
-
创建数据库模式的权限
- DBA在创建用户时实现
- CREATE USER语句格式
CREATE USER <username>
[WITH][DBA | RESOURCE | CONNECT]
- 数据库角色
-
数据库角色:被命名的一组与数据库操作相关的权限
- 角色是权限的集合
- 可以为一组具有相同权限的用户创建一个角色
- 简化授权的过程
-
角色的创建
CREATE ROLE <角色名>
-
给角色授权
GRANT <权限>[,<权限>]…
ON <对象类型>对象名
TO <角色>[,<角色>]…
-
将一个角色授予其他的角色或用户
GRANT <角色1>[,<角色2>]…
TO <角色3>[,<用户1>]…
[WITH ADMIN OPTION]
-
角色权限的收回
REVOKE <权限>[,<权限>]…
ON <对象类型> <对象名>
FROM <角色>[,<角色>]…
数据库完整性
-
数据库的完整性
- 数据的正确性和相容性
-
数据的完整性和安全性是两个不同概念
-
数据的完整性
- 防止数据库中存在不符合语义的数据,也就是防止数据库中存在不正确的数据
- 防范对象:不合语义的、不正确的数据
-
数据的安全性
- 保护数据库防止恶意的破坏和非法的存取
- 防范对象:非法用户和非法操作
-
-
实体完整性
-
关系模型的实体完整性
- CREATE TABLE中用PRIMARY KEY定义
-
单属性构成的码有两种说明方法
- 定义为列级约束条件
- 定义为表级约束条件
-
对多个属性构成的码只有一种说明方法
- 定义为表级约束条件
- 插入或对主码列进行更新操作时,RDBMS按照实体完整性规则自动进行检查。包括:
-
- 检查主码值是否唯一,如果不唯一则拒绝插入或修改
- 检查主码的各个属性是否为空,只要有一个为空就拒绝插入或修改
- 检查记录中主码值是否唯一的一种方法是进行全表扫描
-
参照完整性
-
关系模型的参照完整性定义
- 在CREATE TABLE中用FOREIGN KEY短语定义哪些列为外码
-
用REFERENCES短语指明这些外码参照哪些表的主码
例如,关系SC中一个元组表示一个学生选修的某门课程的成绩,(Sno,Cno)是主码。Sno,Cno分别参照引用Student表的主码和Course表的主码
[例3] 定义SC中的参照完整性
CREATE TABLE SC
(Sno CHAR(9) NOT NULL,
Cno CHAR(4) NOT NULL,
Grade SMALLINT,
PRIMARY KEY (Sno, Cno), /*在表级定义实体完整性*/
FOREIGN KEY (Sno) REFERENCES Student(Sno),
/*在表级定义参照完整性*/
FOREIGN KEY (Cno) REFERENCES Course(Cno)
/*在表级定义参照完整性*/
);
-
-
用户定义的完整性
-
属性上的约束条件的定义
- CREATE TABLE时定义
- 列值非空(NOT NULL)
- 列值唯一(UNIQUE)
- 检查列值是否满足一个布尔表达式(CHECK)
-
属性上的约束条件检查和违约处理
- 插入元组或修改属性的值时,RDBMS检查属性上的约束条件是否被满足
- 如果不满足则操作被拒绝执行
-
元组上的约束条件的定义
- 在CREATE TABLE时可以用CHECK短语定义元组上的约束条件,即元组级的限制
- 同属性值限制相比,元组级的限制可以设置不同属性之间的取值的相互约束条件
-
元组上的约束条件检查和违约处理
- 插入元组或修改属性的值时,RDBMS检查元组上的约束条件是否被满足
- 如果不满足则操作被拒绝执行
-
-
完整性约束命名子句
-
CONSTRAINT 约束
CONSTRAINT <完整性约束条件名>
[PRIMARY KEY短语
|FOREIGN KEY短语
|CHECK短语]
- 使用ALTER TABLE语句修改表中的完整性限制
- SQL支持域的概念,并可以用CREATE DOMAIN语句建立一个域以及该域应该满足的完整性约束条件。
-
-
触发器
-
定义触发器
-
CREATE TRIGGER语法格式
CREATE TRIGGER <触发器名>
{BEFORE | AFTER} <触发事件> ON <表名>
FOR EACH {ROW | STATEMENT}
[WHEN <触发条件>]
<触发动作体>
-
-
定义触发器的语法说明:
- 1. 创建者:表的拥有者
- 2. 触发器名
- 3. 表名:触发器的目标表
- 4. 触发事件:INSERT、DELETE、UPDATE
-
5. 触发器类型
- 行级触发器(FOR EACH ROW)
- 语句级触发器(FOR EACH STATEMENT)
-
6. 触发条件
- 触发条件为真
- 省略WHEN触发条件
-
7. 触发动作体
- 触发动作体可以是一个匿名PL/SQL过程块
- 也可以是对已创建存储过程的调用
-
激活触发器
- 触发器的执行,是由触发事件激活的,并由数据库服务器自动执行
-
一个数据表上可能定义了多个触发器
- 同一个表上的多个触发器激活时遵循如下的执行顺序:
- (1) 执行该表上的BEFORE触发器;
- (2) 激活触发器的SQL语句;
- (3) 执行该表上的AFTER触发器。
-
删除触发器
-
删除触发器的SQL语法:
DROP TRIGGER <触发器名> ON <表名>;
- 触发器必须是一个已经创建的触发器,并且只能由具有相应权限的用户删除。
-
-
关系数据理论
-
数据依赖
-
数据依赖的类型
- 函数依赖(Functional Dependency,简记为FD)
- 多值依赖(Multivalued Dependency,简记为MVD)
- 其他
-
数据依赖对关系模式的影响
-
"好"的模式:
- 不会发生插入异常、删除异常、更新异常,
- 数据冗余应尽可能少
- 原因:由存在于模式中的某些数据依赖引起的
- 解决方法:通过分解关系模式来消除其中不合适的数据依赖
-
-
函数依赖
- 定义6.1 设R(U)是一个属性集U上的关系模式,X和Y是U的子集。若对于R(U)的任意一个可能的关系r,r中不可能存在两个元组在X上的属性值相等, 而在Y上的属性值不等, 则称 "X函数确定Y" 或 "Y函数依赖于X",记作X→Y。
-
在关系模式R(U)中,对于U的子集X和Y,
- 如果X→Y,但Y Í X,则称X→Y是非平凡的函数依赖
- 若X→Y,但Y Í X, 则称X→Y是平凡的函数依赖
- 若X→Y,则X称为这个函数依赖的决定属性组,也称为决定因素(Determinant)。
- 若X→Y,Y→X,则记作X←→Y。
- 若Y不函数依赖于X,则记作X→Y。
-
完全函数依赖与部分函数依赖
- 定义6.2 在R(U)中,如果X→Y,并且对于X的任何一个真子集X',都有X' Y, 则称Y对X完全函数依赖,记作X→F Y 。 若X→Y,但Y不完全函数依赖于X,则称Y对X部分函数依赖,记作X→P Y。
-
传递函数依赖
- 定义6.3 在R(U)中,如果X→Y,(Y ÍX) ,Y→X Y→Z, 则称Z对X传递函数依赖。记为:X →传递 Z
- 注: 如果Y→X, 即X←→Y,则Z直接依赖于X。
-
码
- 定义6.4 设K为R<U,F>中的属性或属性组合。若K U, 则K称为R的侯选码(Candidate Key)。若候选码多于一个,则选定其中的一个做为主码(Primary Key)。
-
主属性与非主属性
- 包含在任何一个候选码中的属性 ,称为主属性(Prime attribute)
- 不包含在任何码中的属性称为非主属性(Nonprime attribute)或非码属性(Non-key attribute)
-
全码
- 整个属性组是码,称为全码(All-key)
-
外部码
- 定义6.5 关系模式 R 中属性或属性组X 并非 R的码,但 X 是另一个关系模式的码,则称 X 是R 的外部码(Foreign key)也称外码
-
-
范式
- 范式是符合某一种级别的关系模式的集合
- 关系数据库中的关系必须满足一定的要求。满足不同程度要求的为不同范式
-
范式的种类:
- 第一范式(1NF)
- 第二范式(2NF)
- 第三范式(3NF)
- BC范式(BCNF)
- 第四范式(4NF)
- 第五范式(5NF)
- 各种范式之间存在联系:
- 某一关系模式R为第n范式,可简记为R∈nNF。
- 一个低一级范式的关系模式,通过模式分解可以转换为若干个高一级范式的关系模式的集合,这种过程就叫规范化
-
1NF
-
1NF的定义
- 如果一个关系模式R的所有属性都是不可分的基本数据项,则R∈1NF
- 第一范式是对关系模式的最起码的要求。不满足第一范式的数据库模式不能称为关系数据库
- 但是满足第一范式的关系模式并不一定是一个好的关系模式
-
-
2NF
-
2NF的定义
- 定义6.6 若R∈1NF,且每一个非主属性完全函数依赖于码,则R∈2NF。
-
-
3NF
-
3NF的定义
- 定义6.7 关系模式R<U,F> 中若不存在这样的码X、属性组Y及非主属性Z(Z Í Y), 使得X→Y,Y→Z成立, Y → X,则称R<U,F> ∈ 3NF。
- 若R∈3NF,则每一个非主属性既不部分依赖于码也不传递依赖于码。
-
-
BC范式(BCNF)
- 定义6.8 关系模式R<U,F>∈1NF,若X→Y且Y Í X时,X必含有码,则R<U,F> ∈BCNF。
- 等价于:每一个决定属性因素都包含码
-
若R∈BCNF
- 所有非主属性对每一个码都是完全函数依赖
- 所有的主属性对每一个不包含它的码,也是完全函数依赖
- 没有任何属性完全函数依赖于非码的任何一组属性
- R ∈BCNF

 R ∈3NF
-
多值依赖
-
定义6.9
- 设R(U)是一个属性集U上的一个关系模式, X、 Y和Z是U的子集,并且Z=U-X-Y。关系模式R(U)中多值依赖 X→→Y成立,当且仅当对R(U)的任一关系r,给定的一对(x,z)值,有一组Y的值,这组值仅仅决定于x值而与z值无关
-
多值依赖的另一个等价的形式化的定义:
- 在R(U)的任一关系r中,如果存在元组t,s 使得t[X]=s[X],那么就必然存在元组 w,vÎ r,(w,v可以与s,t相同),使得w[X]=v[X]=t[X],而w[Y]=t[Y],w[Z]=s[Z],v[Y]=s[Y],v[Z]=t[Z](即交换s,t元组的Y值所得的两个新元组必在r中),则Y多值依赖于X,记为X→→Y。 这里,X,Y是U的子集,Z=U-X-Y。
-
平凡多值依赖和非平凡的多值依赖
- 若X→→Y,而Z=φ,则称X→→Y为平凡的多值依赖
- 否则称X→→Y为非平凡的多值依赖
-
多值依赖的性质
- (1)多值依赖具有对称性。若X→→Y,则X→→Z,其中Z=U-X-Y
- (2)多值依赖具有传递性。若X→→Y,Y→→Z, 则X→→Z –Y
- (3)函数依赖是多值依赖的特殊情况。若X→Y,则X→→Y。
- (4)若X→→Y,X→→Z,则X→→YÈ Z。
- (5)若X→→Y,X→→Z,则X→→Y∩Z。
- (6)若X→→Y,X→→Z,则X→→Y-Z,X→→Z -Y。
-
多值依赖与函数依赖的区别
- (1) 多值依赖的有效性与属性集的范围有关
-
(2)
- 若函数依赖X→Y在R(U)上成立,则对于任何Y' Ì Y均有X→Y' 成立
- 多值依赖X→→Y若在R(U)上成立,不能断言对于任何Y' Ì Y有X→→Y' 成立
-
4NF
- 定义6.10 关系模式R<U,F>∈1NF,如果对于R的每个非平凡多值依赖X→→Y(Y Í X),X都含有码,则R∈4NF。
-
如果R ∈ 4NF, 则R ∈ BCNF
- 不允许有非平凡且非函数依赖的多值依赖
- 允许的非平凡多值依赖是函数依赖
-
-
数据依赖的公理系统
-
逻辑蕴含
- 定义6.11 对于满足一组函数依赖 F 的关系模式R <U,F>,其任何一个关系r,若函数依赖X→Y都成立, (即r中任意两元组t,s,若tX]=sX],则tY]=sY]),则称F逻辑蕴含X →Y
-
关系模式R <U,F >来说有以下的推理规则:
- A1.自反律(Reflexivity):若Y Í X Í U,则X →Y为F所蕴含。
- A2.增广律(Augmentation):若X→Y为F所蕴含,且Z Í U,则XZ→YZ为F所蕴含。
-
A3.传递律(Transitivity):若X→Y及Y→Z为F所蕴含,则X→Z为F所蕴含。
-
自反律: 若Y Í X Í U,则X →Y为F所蕴含
证: 设Y Í X Í U
对R <U,F> 的任一关系r中的任意两个元组t,s:
若t[X]=s[X],由于Y Í X,有t[y]=s[y],
所以X→Y成立,自反律得证
-
增广律: 若X→Y为F所蕴含,且Z Í U,则XZ→YZ 为F所蕴含。
证:设X→Y为F所蕴含,且Z Í U。
设R<U,F> 的任一关系r中任意的两个元组t,s:
若t[XZ]=s[XZ],则有t[X]=s[X]和t[Z]=s[Z];
由X→Y,于是有t[Y]=s[Y],所以t[YZ]=s[YZ],所以
XZ→YZ为F所蕴含,增广律得证。
-
传递律:若X→Y及Y→Z为F所蕴含,则X→Z为 F所蕴含。
证:设X→Y及Y→Z为F所蕴含。
对R<U,F> 的任一关系 r中的任意两个元组 t,s:
若t[X]=s[X],由于X→Y,有 t[Y]=s[Y];
再由Y→Z,有t[Z]=s[Z],所以X→Z为F所蕴含,传递律得证。
-
-
导出规则
-
1.根据A1,A2,A3这三条推理规则可以得到下面三条推理规则:
-
合并规则:由X→Y,X→Z,有X→YZ。
(A2, A3)
-
伪传递规则:由X→Y,WY→Z,有XW→Z。
(A2, A3)
-
分解规则:由X→Y及 ZÍY,有X→Z。
(A1, A3)
-
-
2.根据合并规则和分解规则,可得引理6.1
- 引理6.l X→A1 A2…Ak成立的充分必要条件是X→Ai成立(i=l,2,…,k)
-
-
函数依赖闭包
- 定义6.l2 在关系模式R<U,F>中为F所逻辑蕴含的函数依赖的全体叫作 F的闭包,记为F+。
- 定义6.13 设F为属性集U上的一组函数依赖,X ÍU, XF+ ={ A|X→A能由F 根据Armstrong公理导出},XF+称为属性集X关于函数依赖集F 的闭包
-
函数依赖集等价
- 定义6.14 如果G+=F+,就说函数依赖集F覆盖G(F是G的覆盖,或G是F的覆盖),或F与G等价。
-
引理6.3 F+ = G+ 的充分必要条件是F Í G+ ,和G Í F+
证: 必要性显然,只证充分性。
(1)若FÍG+ ,则XF+ Í XG++ 。
(2)任取X→YÎF+ 则有 Y Í XF+ Í XG++ 。
所以X→Y Î (G+)+= G+。即F+ Í G+。
(3)同理可证G+ Í F+ ,所以F+ = G+。
-
最小依赖集
-
定义6.15 如果函数依赖集F满足下列条件,则称F为一个极小函数依赖集。亦称为最小依赖集或最小覆盖。
- (1) F中任一函数依赖的右部仅含有一个属性。
- (2) F中不存在这样的函数依赖X→A,使得F与F-{X→A}等价。
- (3) F中不存在这样的函数依赖X→A, X有真子集Z使得F-{X→A}∪{Z→A}与F等价。
-
-
极小化过程
-
定理6.3 每一个函数依赖集F均等价于一个极小函数依赖集Fm。此Fm称为F的最小依赖集。
证明: 构造性证明,找出F的一个最小依赖集。
(1)逐一检查F中各函数依赖FDi:X→Y,若Y=A1A2 …Ak,k > 2,
则用 { X→Aj |j=1,2,…, k} 来取代X→Y。
(2)逐一检查F中各函数依赖FDi:X→A,令G=F-{X→A},
若AÎXG+, 则从F中去掉此函数依赖。
(3)逐一取出F中各函数依赖FDi:X→A,设X=B1B2…Bm,
逐一考查Bi (i=l,2,…,m),若A Î(X-Bi )F+ ,
则以X-Bi 取代X。
-
-
模式的分解
-
三种模式分解等价的定义:
- ⒈ 分解具有无损连接性
- ⒉ 分解要保持函数依赖
- ⒊ 分解既要保持函数依赖,又要具有无损连接性
- 定义6.16 关系模式R<U,F>的一个分解:ρ={ R1<U1,F1>,R2<U2,F2>,…,Rn<Un,Fn>},U= ∪Ui,且不存在 Ui Í Uj,Fi 为 F在 Ui 上的投影
- 定义6.17 函数依赖集合{X→Y | X→Y Î F+∧XY ÍUi} 的一个覆盖 Fi 叫作 F 在属性 Ui 上的投影
-
-
具有无损连接性的模式分解
- 关系模式R<U,F>的一个分解 ρ={ R1<U1,F1>,R2<U2,F2>, …,Rn<Un,Fn>},若R与R1、R2、…、Rn自然连接的结果相等,则称关系模式R的这个分解ρ具有无损连接性(Lossless join)
- 具有无损连接性的分解保证不丢失信息
- 无损连接性不一定能解决插入异常、删除异常、修改复杂、数据冗余等问题
-
保持函数依赖的模式分解
- 设关系模式R<U,F>被分解为若干个关系模式,R1<U1,F1>,R2<U2,F2>,…,Rn<Un,Fn> ,(其中U=U1∪U2∪…∪Un,且不存在Ui Í Uj,Fi为F在Ui上的投影),若F所逻辑蕴含的函数依赖一定也由分解得到的某个关系模式中的函数依赖Fi所逻辑蕴含,则称关系模式R的这个分解是保持函数依赖的(Preserve dependency)
-
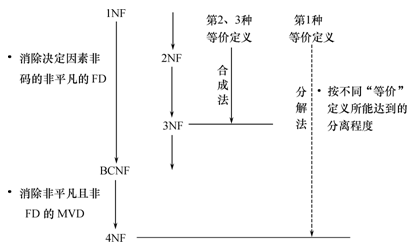
关系模式的规范化,其基本思想:
-
小结
- 若要求分解具有无损连接性,那么模式分解一定能够达到4NF
- 若要求分解保持函数依赖,那么模式分解一定能够达到3NF,但不一定能够达到BCNF
- 若要求分解既具有无损连接性,又保持函数依赖,则模式分解一定能够达到3NF,但不一定能够达到BCNF
-
数据库设计
-
数据库设计的特点
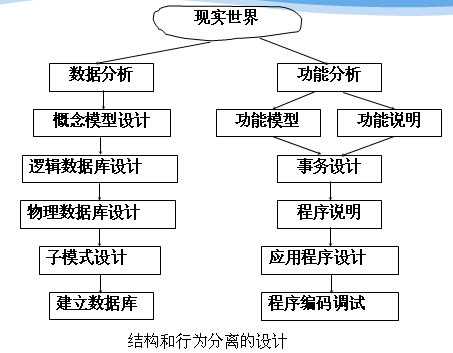
- 数据库设计方法
-
基本思想:过程迭代和逐步求精
-
新奥尔良(New Orleans)方法
- 将数据库设计分为若干阶段和步骤
-
基于E-R模型的数据库设计方法
- 概念设计阶段广泛采用
-
3NF(第三范式)的设计方法
- 逻辑阶段可采用的有效方法
-
ODL(Object Definition Language)方法
- 面向对象的数据库设计方法
-
计算机辅助设计
- ORACLE Designer 2000
- SYBASE PowerDesigner
-
-
数据库设计的基本步骤
-
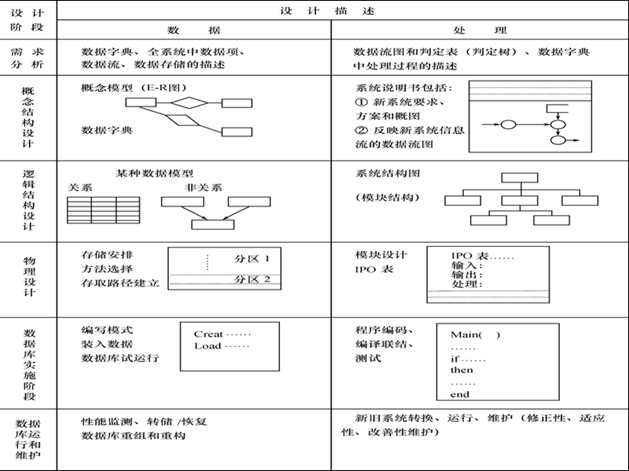
数据库设计分6个阶段
- 需求分析
- 概念结构设计
- 逻辑结构设计
- 物理结构设计
- 数据库实施
- 数据库运行和维护
- 需求分析和概念设计独立于任何数据库管理系统
- 逻辑设计和物理设计与选用的DBMS密切相关
-
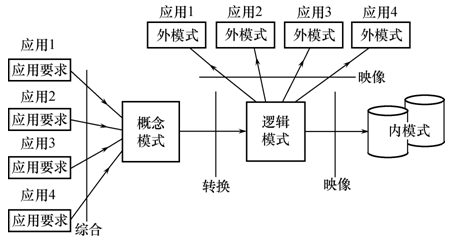
- 数据库设计过程中的各级模式
-
数据库设计不同阶段形成的数据库各级模式
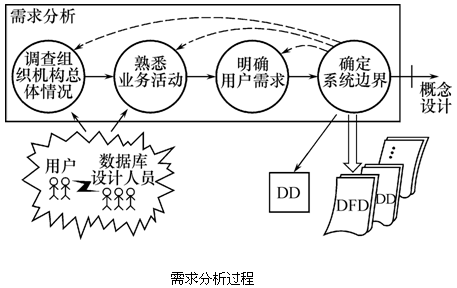
- 结构化分析方法(Structured Analysis,简称SA方法)
- 从最上层的系统组织机构入手
-
自顶向下、逐层分解分析系统
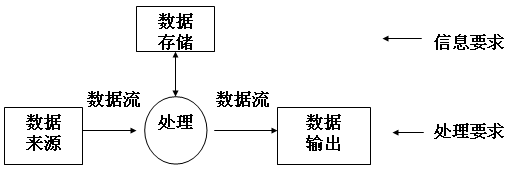
- 1.首先把任何一个系统都抽象为:
-
2.分解处理功能和数据
-
(1)分解处理功能
- 将处理功能的具体内容分解为若干子功能
-
(2)分解数据
- 处理功能逐步分解同时,逐级分解所用数据,形成若干层次的数据流图
-
(3)表达方法
- 处理逻辑:用判定表或判定树来描述
- 数据:用数据字典来描述
-
-
3.将分析结果再次提交给用户,征得用户的认可
- 数据字典
-
数据字典的用途
- 进行详细的数据收集和数据分析所获得的主要结果
-
数据字典的内容
- 数据项
- 数据结构
- 数据流
- 数据存储
- 处理过程
-
⒈ 数据项
- 数据项是不可再分的数据单位
-
对数据项的描述
数据项描述={数据项名,数据项含义说明,别名,
数据类型,长度,取值范围,取值含义,
与其他数据项的逻辑关系,数据项之间的联系 }
-
⒉ 数据结构
- 数据结构反映了数据之间的组合关系。
- 一个数据结构可以由若干个数据项组成,也可以由若干个数据结构组成,或由若干个数据项和数据结构混合组成。
-
对数据结构的描述
数据结构描述={数据结构名,含义说明,
组成:{数据项或数据结构}}
-
⒊ 数据流
- 数据流是数据结构在系统内传输的路径。
-
对数据流的描述
数据流描述={ 数据流名,说明,数据流来源,
数据流去向,组成:{数据结构},
平均流量,高峰期流量}
-
⒋ 数据存储
- 数据存储是数据结构停留或保存的地方,也是数据流的来源和去向之一。
-
对数据存储的描述
数据存储描述={数据存储名,说明,编号,
输入的数据流 ,输出的数据流 ,
组成:{数据结构},数据量,存取频度,存取方式}
-
⒌ 处理过程
- 具体处理逻辑一般用判定表或判定树来描述
-
处理过程说明性信息的描述
处理过程描述={处理过程名,说明,输入:{数据流},
输出:{数据流},处理:{简要说明}}
- 概念结构设计
-
设计概念结构的四类方法
- 自顶向下
- 首先定义全局概念结构的框架,然后逐步细化
- 自底向上
- 首先定义各局部应用的概念结构,然后将它们集成起来,得到全局概念结构
- 逐步扩张
- 首先定义最重要的核心概念结构,然后向外扩充,以滚雪球的方式逐步生成其他概念结构,直至总体概念结构
- 混合策略
- 将自顶向下和自底向上相结合,用自顶向下策略设计一个全局概念结构的框架,以它为骨架集成由自底向上策略中设计的各局部概念结构。
-
常用策略
- 自顶向下地进行需求分析
-
自底向上地设计概念结构

-
自底向上设计概念结构的步骤
- 第1步:抽象数据并设计局部视图
-
第2步:集成局部视图,得到全局概念结构
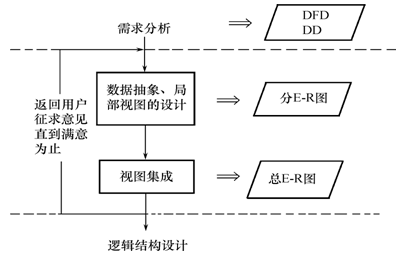
-
数据抽象与局部视图设计
-
数据抽象
-
三种常用抽象
-
1. 分类(Classification)
- 定义某一类概念作为现实世界中一组对象的类型
- 抽象了对象值和型之间的"is member of"的语义
-

-
2. 聚集(Aggregation)
- 定义某一类型的组成成分
- 抽象了对象内部类型和成分之间"is part of"的语义

- 复杂的聚集,某一类型的成分仍是一个聚集

-
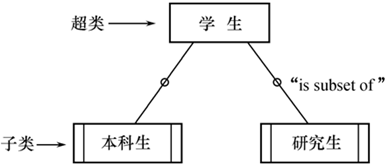
3. 概括(Generalization)
- 定义类型之间的一种子集联系
- 抽象了类型之间的"is subset of"的语义
- 继承性
-
-
局部视图设计
-
设计分E-R图的步骤:
-
⒈选择局部应用
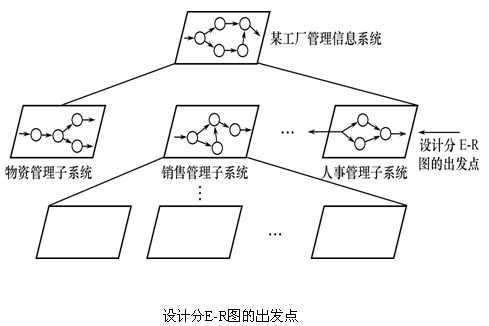
- 在多层的数据流图中选择一个适当层次的数据流图,作为设计分E-R图的出发点
- 通常以中层数据流图作为设计分E-R图的依据
-
-
⒉逐一设计分E-R图
-
任务
- 将各局部应用涉及的数据分别从数据字典中抽取出来
- 参照数据流图,标定各局部应用中的实体、实体的属性、标识实体的码
- 确定实体之间的联系及其类型(1:1,1:n,m:n)
-
两条准则:
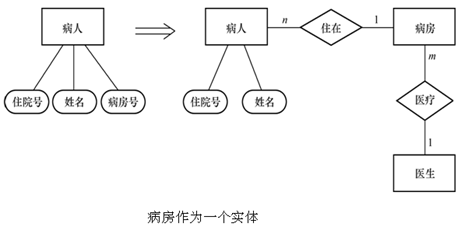
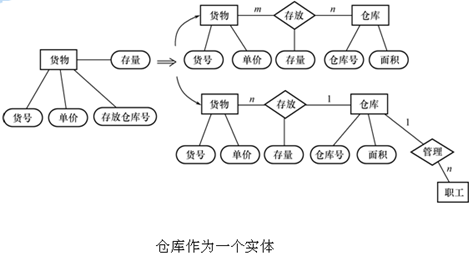
- (1)属性不能再具有需要描述的性质。即属性必须是不可分的数据项,不能再由另一些属性组成
- (2)属性不能与其他实体具有联系。联系只发生在实体之间
- 举例
-

-
-
- 逻辑结构设计
- E-R图向关系模型的转换
-
数据模型的优化
-
优化数据模型的方法
-
1确定数据依赖
- 按需求分析阶段所得到的语义,分别写出每个关系模式内部各属性之间的数据依赖以及不同关系模式属性之间数据依赖
-
2消除 冗余的联系
- 对于各个关系模式之间的数据依赖进行极小化处理,消除 冗余的联系。
-
3确定所属范式
- 按照数据依赖的理论对关系模式逐一进行分析
- 考查是否存在部分函数依赖、传递函数依赖、多值依赖等
- 确定各关系模式分别属于第几范式
- 4按照需求分析阶段得到的各种应用对数据处理的要求,分析对于这样的应用环境这些模式是否合适,确定是否要对它们进行合并或分解。
- 注意:并不是规范化程度越高的关系就越优,一般说来,第三范式就足够了
- 5按照需求分析阶段得到的各种应用对数据处理的要求,对关系模式进行必要的分解,以提高数据操作的效率和存储空间的利用率
-
-
-
设计用户子模式
-
定义用户外模式时应该注重的问题
-
包括三个方面:
- (1) 使用更符合用户习惯的别名
- (2) 针对不同级别的用户定义不同的View ,以满足系统对安全性的要求。
- (3) 简化用户对系统的使用
-
-
- 数据库的物理设计
- 数据库物理设计的内容和方法
-
关系模式存取方法选择
-
DBMS常用存取方法
-
索引方法
- 目前主要是B+树索引方法
- 经典存取方法,使用最普遍
-
聚簇(Cluster)方法
- HASH方法
-
-
选择索引存取方法的一般规则
- 如果一个(或一组)属性经常在查询条件中出现,则考虑在这个(或这组)属性上建立索引(或组合索引)
- 如果一个属性经常作为最大值和最小值等聚集函数的参数,则考虑在这个属性上建立索引
- 如果一个(或一组)属性经常在连接操作的连接条件中出现,则考虑在这个(或这组)属性上建立索引
-
聚簇
- 为了提高某个属性(或属性组)的查询速度,把这个或这些属性(称为聚簇码)上具有相同值的元组集中存放在连续的物理块称为聚簇
-
聚簇的用途
- 1. 大大提高按聚簇码进行查询的效率
-
2. 节省存储空间
- 聚簇以后,聚簇码相同的元组集中在一起了,因而聚簇码值不必在每个元组中重复存储,只要在一组中存一次就行了
-
聚簇的局限性
- 1. 聚簇只能提高某些特定应用的性能
-
2. 建立与维护聚簇的开销相当大
- 对已有关系建立聚簇,将导致关系中元组移动其物理存储位置,并使此关系上原有的索引无效,必须重建
- 当一个元组的聚簇码改变时,该元组的存储位置也要做相应移动
-
-
确定数据的存放位置
-
根据应用情况将
- 易变部分与稳定部分分开存放
- 存取频率较高部分与存取频率较低部分,分开存放
-
- 评价物理结构
- 小结(续)
- 在逻辑设计阶段将E-R图转换成具体的数据库产品支持的数据模型如关系模型,形成数据库逻辑模式。然后根据用户处理的要求,安全性的考虑,在基本表的基础上再建立必要的视图(VIEW)形成数据的外模式
- 在物理设计阶段根据DBMS特点和处理的需要,进行物理存储安排,设计索引,形成数据库内模式
数据库编程
- 嵌入式SQL
- 嵌入式SQL的处理过程
-
数据库工作单元与源程序工作单元之间的通信:
-
1. SQL通信区
- 向主语言传递SQL语句的执行状态信息
- 使主语言能够据此控制程序流程
-
2. 主变量
- 主语言向SQL语句提供参数
- 将SQL语句查询数据库的结果交主语言进一步处理
-
3. 游标
- 解决集合性操作语言与过程性操作语言的不匹配
-
- 嵌入式SQL与主语言的通信
-
在SQL语句中使用主变量和指示变量的方法
-
1) 说明主变量和指示变量
BEGIN DECLARE SECTION
.........
......... (说明主变量和指示变量)
.........
END DECLARE SECTION
-
2) 使用主变量
- 说明之后的主变量可以在SQL语句中任何一个能够使用表达式的地方出现
- 为了与数据库对象名(表名、视图名、列名等)区别,SQL语句中的主变量名前要加冒号(:)作为标志
-
3) 使用指示变量
- 指示变量前也必须加冒号标志
- 必须紧跟在所指主变量之后
-
-
在SQL语句之外(主语言语句中)使用主变量和指示变量的方法
- 可以直接引用,不必加冒号
-
游标(cursor)
- SQL语言与主语言具有不同数据处理方式
- SQL语言是面向集合的,一条SQL语句原则上可以产生或处理多条记录
- 主语言是面向记录的,一组主变量一次只能存放一条记录
- 仅使用主变量并不能完全满足SQL语句向应用程序输出数据的要求
- 嵌入式SQL引入了游标的概念,用来协调这两种不同的处理方式
- 游标是系统为用户开设的一个数据缓冲区,存放SQL语句的执行结果
- 每个游标区都有一个名字
- 用户可以用SQL语句逐一从游标中获取记录,并赋给主变量,交由主语言进一步处理
-
建立和关闭数据库连接
-
建立数据库连接
EXEC SQL CONNECT TO target [AS connection-name] [USER user-name];
-
target是要连接的数据库服务器:
- 常见的服务器标识串,如<dbname>@<hostname>:<port>
- 包含服务器标识的SQL串常量
- DEFAULT
- connect-name是可选的连接名,连接必须是一个有效的标识符 在整个程序内只有一个连接时可以不指定连接名
-
-
关闭数据库连接
EXEC SQL DISCONNECT [connection];
-
程序运行过程中可以修改当前连接 :
EXEC SQL SET CONNECTION connection-name | DEFAULT;
-
-
不用游标的SQL语句的种类
- 说明性语句
- 数据定义语句
- 数据控制语句
- 查询结果为单记录的SELECT语句
- 非CURRENT形式的增删改语句
-
使用游标的SQL语句
-
查询结果为多条记录的SELECT语句
-
使用游标的步骤
-
1. 说明游标
- 使用DECLARE语句
-
语句格式
EXEC SQL DECLARE <游标名> CURSOR
FOR <SELECT语句>;
-
功能
是一条说明性语句,这时DBMS并不执行SELECT指定的查询操作。
-
2. 打开游标
- 使用OPEN语句
-
语句格式
EXEC SQL OPEN <游标名>;
-
功能
打开游标实际上是执行相应的SELECT语句,把所有满足查询条件的记录从指定表取到缓冲区中这时游标处于活动状态,指针指向查询结果集中第一条记录
-
3.推进游标指针并取当前记录
- 使用FETCH语句
-
语句格式
EXEC SQL FETCH [[NEXT|PRIOR|
FIRST|LAST] FROM] <游标名>
INTO <主变量>[<指示变量>][,<主变量>[<指示变量>]]...;
-
功能
指定方向推动游标指针,然后将缓冲区中的当前记录取出来送至主变量供主语言进一步处理
NEXT|PRIOR|FIRST|LAST:指定推动游标指针的方式
NEXT:向前推进一条记录
PRIOR:向回退一条记录
FIRST:推向第一条记录
LAST:推向最后一条记录
缺省值为NEXT
-
4. 关闭游标
- 使用CLOSE语句
-
语句格式
EXEC SQL CLOSE <游标名>;
-
功能
关闭游标,释放结果集占用的缓冲区及其他资源
-
说明
游标被关闭后,就不再和原来的查询结果集相联系
被关闭的游标可以再次被打开,与新的查询结果相联系
-
-
-
CURRENT形式的UPDATE语句
-
CURRENT形式的UPDATE语句和DELETE语句的用途
- 面向集合的操作
- 一次修改或删除所有满足条件的记录
-
如果只想修改或删除其中某个记录
- 用带游标的SELECT语句查出所有满足条件的记录
- 从中进一步找出要修改或删除的记录
- 用CURRENT形式的UPDATE语句和DELETE语句修改或删除之
-
UPDATE语句和DELETE语句中的子句:
WHERE CURRENT OF <游标名>
表示修改或删除的是最近一次取出的记录,即游标指针指向的记录
-
不能使用CURRENT形式的UPDATE语句和DELETE语句 :
- 当游标定义中的SELECT语句带有UNION或ORDER BY子句
- 该SELECT语句相当于定义了一个不可更新的视图
-
-
- 动态SQL
-
静态嵌入式SQL
- 静态嵌入式SQL语句能够满足一般要求
- 无法满足要到执行时才能够确定要提交的SQL语句
-
动态嵌入式SQL
- 允许在程序运行过程中临时"组装"SQL语句
- 支持动态组装SQL语句和动态参数两种形式
-
SQL语句主变量:
- 程序主变量包含的内容是SQL语句的内容,而不是原来保存数据的输入或输出变量
- SQL语句主变量在程序执行期间可以设定不同的SQL语句,然后立即执行
-
动态参数
- SQL语句中的可变元素
- 使用参数符号(?)表示该位置的数据在运行时设定
-
和主变量的区别
- 动态参数的输入不是编译时完成绑定
- 而是通过 (prepare)语句准备主变量和执行(execute)时绑定数据或主变量来完成
-
使用动态参数的步骤:
- 1.声明SQL语句主变量。
-
2.准备SQL语句(PREPARE)。
EXEC SQL PREPARE <语句名> FROM <SQL语句主变量>;
-
3.执行准备好的语句(EXECUTE)
EXEC SQL EXECUTE <语句名> [INTO <主变量表>] [USING < 主变量或常量>];
- 存储过程
- PL/SQL的块结构
-
PL/SOL块的基本结构:
-
1.定义部分
DECLARE
------变量、常量、游标、异常等
- 定义的变量、常量等只能在该基本块中使用
- 当基本块执行结束时,定义就不再存在
-
2.执行部分
BEGIN
------SQL语句、PL/SQL的流程控制语句
EXCEPTION
------异常处理部分
END;
-
-
变量常量的定义
-
1. PL/SQL中定义变量的语法形式是:
- 变量名 数据类型 [ [NOT NULL]:=初值表达式]或
- 变量名 数据类型 [ [NOT NULL]初值表达式]
-
2. 常量的定义类似于变量的定义:
- 常量名 数据类型 CONSTANT :=常量表达式
- 常量必须要给一个值,并且该值在存在期间或常量的作用域内不能改变。如果试图修改它,PL/SQL将返回一个异常。
-
3. 赋值语句
- 变量名称:=表达式
- 控制结构
-
-
一、条件控制语句
-
IF-THEN, IF-THEN-ELSE和嵌套的IF语句
1. IF condition THEN
Sequence_of_statements;
END IF
2. IF condition THEN
Sequence_of_statements1;
ELSE
Sequence_of_statements2;
END IF;
3. 在THEN和ELSE子句中还可以再包括IF语句,即IF语句可以嵌套
-
-
二、循环控制语句
-
LOOP, WHILE-LOOP和FOR-LOOP
1.最简单的循环语句LOOP
LOOP
Sequence_of_statements;
END LOOP;
多数数据库服务器的PL/SQL都提供EXIT、BREAK或LEAVE等循环结束语句,保证LOOP语句块能够结束。
2. WHILE-LOOP
WHILE condition LOOP
Sequence_of_statements;
END LOOP;
每次执行循环体语句之前,首先对条件进行求值
如果条件为真,则执行循环体内的语句序列。
如果条件为假,则跳过循环并把控制传递给下一个语句
3. FOR-LOOP
FOR count IN [REVERSE]bound1 … bound2 LOOP
Sequence_of_statements;
END LOOP;
-
- 存储过程的用户接口
-
1. 创建存储过程:
CREATE Procedure 过程名([参数1,参数2,...]) AS
<PL/SQL块>;
- 过程名:数据库服务器合法的对象标识
- 参数列表:用名字来标识调用时给出的参数值,必须指定值的数据类型。参数也可以定义输入参数、输出参数或输入/输出参数。默认为输入参数。
- 过程体:是一个<PL/SQL块>。包括声明部分和可执行语句部分
-
重命名存储过程
ALTER Procedure 过程名1 RENAME TO 过程名2;
-
2. 执行存储过程:
CALL/PERFORM. Procedure 过程名([参数1,参数2,...]);
- 使用CALL或者PERFORM等方式激活存储过程的执行。
- 在PL/SQL中,数据库服务器支持在过程体中调用其他存储过程
-
3. 删除存储过程
DROP PROCEDURE 过程名();
- ODBC编程
对象关系数据库系统
- 对象关系数据库系统(Object Relational Database System,ORDBS)是面向对象数据模型(Object Oriented Data Model,简称OO模型)和关系数据模型相结合的产物
- 面向对象数据模型
- OO模型的核心概念
-
1.对象
- 定义:对象是由一组数据结构和在这组数据结构上的操作的程序代码封装起来的基本单位。
-
组成部分
-
属性(Attribute)集合
- 属性描述对象的状态、组成和特性
-
方法(Method)集合
- 描述了对象的行为特性
-
-
2. 对象标识OID(Object IDentifier)
- 概念:面向对象数据库中的每个对象都有一个唯一的不变的标识称为对象标识(OID)
-
特点:
- 永久持久性
- 独立于值的、系统全局唯一的
-
3. 封装(Encapsulation)
- 每一个对象是其状态与行为的封装
- 封装是对象的外部界面与内部实现之间实行清晰隔离的一种抽象,外部与对象的通信只能通过消息
- 对象封装之后查询属性值必须通过调用方法
-
4. 类(Class)
- 对象类(简称类):共享同样属性和方法集的所有对象构成了一个对象类
- 实例:一个对象是某一类的一个实例(instance)
- 在OODB中,类是"型",对象是某一类的一个"值"
- 类层次(结构)
- 继承
- 对象的嵌套
-
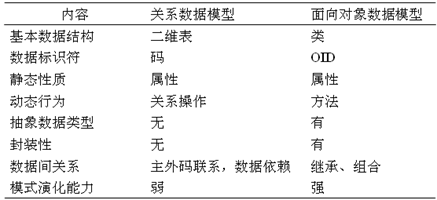
关系数据模型与OO模型的比较
- 对象-关系数据库
- 对象关系数据库系统中扩展的关系数据类型
-
1.大对象LOB(Large OBject )类型
- LOB可存储多达十亿字节的串。
-
LOB分类
- 二进制大对象BLOB(Binary Large OBject)
- BLOB用于存储音频、图像数据
- 字符串大对象CLOB(Character Large OBject)。
- CLOB用于存储长字符串数据
-
2.BOOLEAN类型
- 布尔类型,支持3个真值:true、false和unknown
-
操作符:NOT、AND、OR、EVERY、ANY
- 例如 WHERE EVERY(QTY>200)
- 或WHERE ANY(QTY>200)
- QTY列为空值:返回unknown;
- QTY列为非空:
- 当该列的每一个值都使(QTY>200)为true时,EVERY返回true,否则为false;
- 当该列的每一个值都使(QTY>200)为false时,ANY返回false,否则为true。
-
3.集合类型(Collection Type)ARRAY
-
相同类型元素的有序集合称为数组ARRAY
- SQL3新增的集合类型
- 允许在数据库的一列中存储数组
-
SQL3的数组只能是一维的
- 数组中的元素不能再是数组
-
[例2]
CREATE TABLE SALES
(
ITEM_NO CHAR(20), /*商品号*/
QTY INTEGER ARRAY[12], /*整数数组,存放销售额*/
PRIMARY KEY(ITEM_NO)
);
- 向SALES表插入一个元组:
INSERT INTO SALES(ITEM_NO,QTY)VALUES
('T-shirt2000',ARRAY[200,150,200,100,50,70,
80,200,10,20,100,200]);
-
查找三月份销售额大于100的商品号:
SELECT ITEM_NO
FROM SALES
WHERE QTY[3]>100;
-
-
4. DISTINCT类型
- SQL3新加了一种DISTINCT类型
-
定义DISTINCT数据类型语法
CREAT TYPE <type name>
AS <built in scalar type name> FINAL
[ <cast option>]
[ <method specification commalist>];
-
没有使用DISTINCT类型
- 例如,职工的智商字段(IQ)和鞋号字段(SHOE_SIZE)定义成INTEGER类型
- WHERE SHOE_SIZE > IQ
-
使用DISTINCT类型
-
重新定义这两字段类型
CREAT TYPE SHOE_SIZE_TYPE AS INTEGER FINAL;
CREAT TYPE IQ_TYPE AS INTEGER FINAL;
- SHOE_SIZE_TYPE和IQ _TYPE成为两种不同的数据类型
- 表达式:WHERE SHOE_SIZE > IQ 是非法的
- 如果在定义类型时设置了选项<cast option>,下面用法也是合法的:WHERE MY_SHOE_SIZE > CAST (MY_IQ AS SHOE_SIZE)
-
- 对象关系数据库系统中扩展的对象类型及其定义
-
在ORDBMS中,类型(TYPE)具有类(CLASS)的特征,可以看成类
-
1.行对象与行类型
-
定义行类型(ROW TYPE) :
CREATE ROW TYPE <row_type_name>
(<component declarations>);
-
创建行类型
-
[例3]
CREATE ROW TYPE Person_type
(pno NUMBER,
name VARCHAR2(100),
address VARCHAR2(100) );
-
-
创建基于行类型的表
CREATE TABLE <table_name> OF <row_type_name>;
-
[例4]
CREATE TABLE person_extent OF Person_type
(pno PRIMARY KEY );
-
-
-
2.列对象与对象类型
- 可以创建一个对象类型,表的属性可以是该对象类型。
-
创建列对象语句如下:
CREATE TYPE <type_name> AS OBJECT
(<component declarations>);
-
[例5]
CREATE TYPE address_objtyp AS OBJECT
(street VARCHAR2(50),
city VARCHAR2(50) );
CREATE TYPE name_objtyp AS OBJECT
(first_name VARCHAR2(30),
last_name VARCHAR2(30) ) ;
- 创建表,定义其中的属性是对象类型
-
[例6]
CREATE TABLE people_reltab (
Id NUMBER(10),
name_obj name_objtyp,
address_obj address_objtyp);
-
3. 抽象数据类型(Abastract Data Type,ADT)
- 概念:SQL3允许用户创建指定的带有自身行为说明和内部结构的用户定义类型称为抽象数据类型
-
定义ADT的一般形式为
CREATE TYPE <type_name> (
所有属性名及其类型说明,
[定义该类型的等于=和小于<函数,]
定义该类型其他函数(方法));
-
- 参照类型(Reference Type)
-
REF类型(参照类型、引用类型)
-
引入的原因:
- 类型之间可能具有相互参照的联系
-
形式
- REF <类型名>
-
特点:
- REF类型总是和某个特定的类型相联系。
- 它的值是OID
-
创建两个表:Employee和Company,两表之间存在相互参照关系,即某个职工在某个公司工作
- (1)创建行类型
-
[例7]
CREATE ROW TYPE employee_type(
name VARCHAR(35),
age INTEGER );
CREATE ROW TYPE Comp_type(
compname VARCHAR(20),
location VARCHAR(20) );
-
(2)创建基于行类型的表:
CREATE TABLE Employee OF employee_type;
CREATE TABLE Company OF Comp_type
-
(3)描述参照关系
CREATE ROW TYPE Employment_type (
employee REF (employee_type),
company REF (Comp_type) );
CREATE TABLE Employment OF Employment _type
- 表Employment中某一个元组的employee属性值是某个职工的OID
- company属性值是该职工所在公司的OID
-
[例8]
CREATE ROW TYPE employee_type(
name VARCHAR(35),
age INTEGER,
emp_id REF(employee_type) );
-
[例9]
CREATE TABLE Employee OF employee_type
VALUES FOR emp_id ARE SYSTEM GENERATED;
-
建立参照属性:
<参照属性名>[REF(<类型名>)]SCOPE IS <关系名>
- [例10]
CREATE TABLE address_objtab OF address_objtyp ;
-
[例11]
CREATE TABLE people_reltab2 (
id NUMBER(4) PRIMARY KEY,
name_obj name_objtyp,
addresss_ref REF(address_objtyp) SCOPE IS address_objtab )
- [例12]
CREATE INDEX address_ref_idx ON people_reltab2(address_ref) ;
-
[例13]
SELECT id
FROM people_reltab2 p
WHERE p.address_ref.city='北京' and
p.address_ref.street='牛街';
-
- 继承性
-
ORDBMS应该支持继承性
-
一般是单继承性
-
[例14]
CREATE TYPE emp_type
UNDER person_type AS(
emp_id INTEGER,
salary REAL )
NOT FINAL;
- NOT FINAL:表示不是类层次结构中最后的"叶结点"
- FINAL:该类型是类层次结构的叶结点
-
-
- 子表和超表
-
[例15] 对于下面的类型层次,先定义这些类型TYPE,然后创建基于这些类型的表

CREATE TYPE person /*创建person 类型,根类型*/
(id INTEGER,
name VARCHAR(20),
birthyear INTEGER,
address VARCHAR(40))
NOT FINAL; /*NOT FINAL表示可以有子类型*/
CREATE TYPE employee /*创建person的子类型employee*/
UNDER person /*类型employee继承person的属性*/
(salary INTEGER) /* employee定义自己的属性*/
NOT FINAL;
CREATE TYPE executive /*创建employee的子类型executive*/
UNDER employee
(bonus INTEGER)
FINAL;
CREATE TYPE student /*创建person的子类型student */
UNDER person
(major VARCHAR(10),wage DECIMAL)
FINAL
-
例16]Department类型和employee具有相互参照的联系,使用REF来表示这种联系
CREATE TYPE department
(ID INTEGER,
manager REF(employee),
Budget INTEGER);
ALTER TYPE employee
ADD ATTRIBUTE dept REF(department);
-
定义基于这些类型的基本表和表层次:
CREATE TABLE person_table OF person
(name WITH OPTIONS NOT NULL);
CREATE TABLE employee_table OF employee
UNDER person_table;
CREATE TABLE exec_table of executive
UNDER employee_table
CREATE TABLE student_table OF student
UNDER person_table;
CREATE TABLE dept_table OF department
(manager SCOPE IS employee_table);
ALTER TABLE employee_table
ALTER COLUMN dept ADD SCOPE IS dept_table;
-
查询[例16]所创建的表
-
[例17]
SELECT name,address
FROM person_table
WHERE birthyear <=1970;
-
-
关闭子表的检索
-
[例18]
SELECT name,address
FROM ONLY person_table
WHERE birthyear <=1970;
-
INSERT、DELETE、UPDATE对子表和超表的操作规则
- INSERT:向子表插入一行时一般会在该子表的超表上也插入一行。
- DELETE:从表删除一行时一般会在该表的超表和子表上也删除相应的一行
-
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/30608670/viewspace-1869408/ ,如需转载,请注明出处,否则将追究法律责任。

