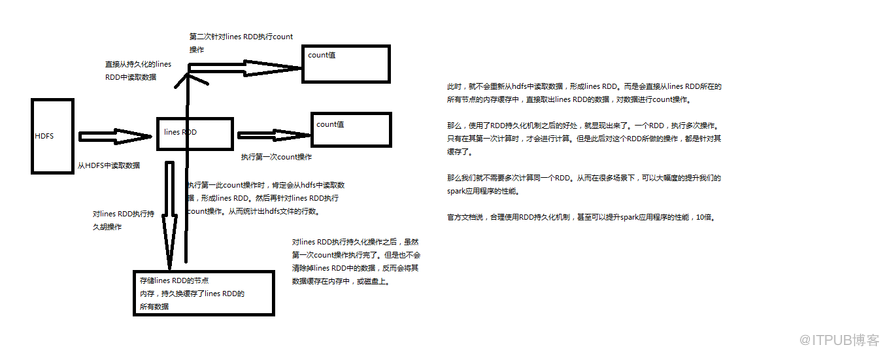
rdd可以持久化到内存,当对dd执行持久化操作时,每个节点都会将自己的操作的rdd的parition持久化到内存中,并且在之后对该rdd的反复使用中,直接使用内存缓存的partition,这样对于一个反复执行多个操作的场景,就只需要对rdd计算一次即可,后面直接使用该rdd,而需要反复计算多次该rdd。
调用cache()或者persist(),cache()底层就是调用的persist()的无参方法,同时就是调用persist(MEMORY_ONLY),将数据持久化到内存。从内存中清除用unpersist()
shuffle操作时会进行数据的持久化,比如写入磁盘,主要是防止节点失败时,避免需要重新计算整个过程。必须在transformation或者textFile等创建了一个RDD之后,直接连续调用cache()或persist()才可以,如果单独另起一行执行cache()或persiat()方法,是没有用的,而且会报错。
eg:
正确调用方式:
JavaRDD<String> words = sc.textFile("C://Users//hlz//Desktop/test.txt").cache();
错误方式:
JavaRDD<String> words = sc.textFile("C://Users//hlz//Desktop/test.txt");
words.cache();
1、使用持久化
 RDD持久化的工作原理.png
2、不使用持久化
RDD持久化的问题的原理.png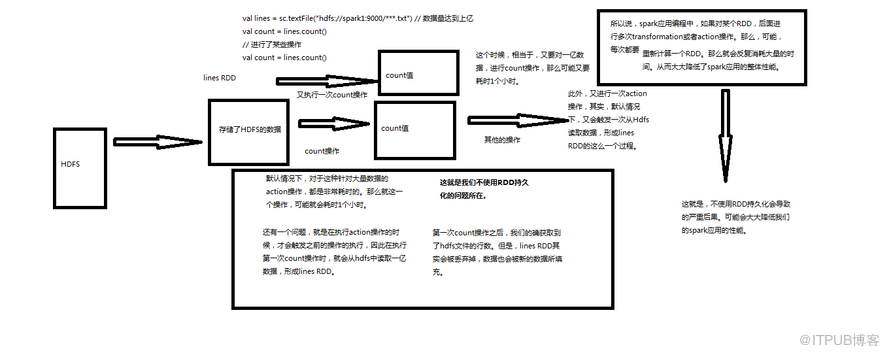
RDD持久化是可以手动选择不同的策略的。比如可以将RDD持久化在内存中、持久化到磁盘上、使用序列化的方式持久化,多持久化的数据进行多路复用。只要在调用persist()时传入对应的StorageLevel即可。
|
持久化级别 |
含义 |
|
MEMORY_ONLY |
以非序列化的Java对象的方式持久化在JVM内存中。如果内存无法完全存储RDD所有的partition,那么那些没有持久化的partition就会在下一次需要使用它的时候,重新被计算。 |
|
MEMORY_AND_DISK |
同上,但是当某些partition无法存储在内存中时,会持久化到磁盘中。下次需要使用这些partition时,需要从磁盘上读取。 |
|
MEMORY_ONLY_SER |
同MEMORY_ONLY,但是会使用Java序列化方式,将Java对象序列化后进行持久化。可以减少内存开销,但是需要进行反序列化,因此会加大CPU开销。 |
|
持久化级别 |
含义 |
|
MEMORY_AND_DSK_SER |
同MEMORY_AND_DSK。但是使用序列化方式持久化Java对象。 |
|
DISK_ONLY |
使用非序列化Java对象的方式持久化,完全存储到磁盘上。 |
|
MEMORY_ONLY_2
MEMORY_AND_DISK_2 等等 |
如果是尾部加了2的持久化级别,表示会将持久化数据复用一份,保存到其他节点,从而在数据丢失时,不需要再次计算,只需要使用备份数据即可。 |
2、如果MEMORY_ONLY策略,无法存储的下所有数据的话,那么使用MEMORY_ONLY_SER,将数据进行序列化进行存储,纯内存操作还是非常快,只是要消耗CPU进行反序列化。
3、如果需要进行快速的失败恢复,那么就选择带后缀为_2的策略,进行数据的备份,这样在失败时,就不需要重新计算了。
4、能不使用DISK相关的策略,就不用使用,有的时候,从磁盘读取数据,还不如重新计算一次。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/30541278/viewspace-2153543/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- spark系列二:jdbc数据源实例
- spark系列一:共享变量(broadcast和accumulator)
- python实例方法、类方法和静态方法的区别
- spark系列二:sparkcore和sparksql综合案例
- hadoop启动时,报ssh: Could not resolve hostname xxx: Name or service not known
- spark系列一:wordcount程序原理剖析及spark架构原理
- spark系列一:transaction和action介绍
- spark系列二:sparksql dataframe常用操作
- spark系列三:sparkstreaming之输入DStream之Kafka数据源实战(基于Direct的方式)
- spark系列一:内核架构及宽窄依赖及提交模式分析
