AI让SQL会说话:一键生成SQL业务注释,2分钟洞悉SQL业务逻辑
一、引言
在企业的数据团队中,存在一个普遍且棘手的“知识断层”问题:
-
SQL代码理解难: 大量的SQL脚本、存储过程和函数缺乏有效的业务注释,其设计意图和业务逻辑仅存在于原开发者的脑中。当开发者离职或转岗后,这些代码便成为难以理解的“黑盒”。
-
新人上手成本高: 新加入的数据分析师或工程师需要花费大量时间(几天甚至几周)去逆向推导一段复杂SQL或存储过程的业务含义,严重拖慢了项目进度和决策速度。
-
数据资产复用率低: 由于无法快速理解现有代码的作用,开发者倾向于重复造轮子,编写功能相似的新SQL,导致资源浪费和维护成本增加。
-
知识库与代码分离: 企业知识库中存放的业务知识(如指标定义、字段说明)与实际运行的SQL代码是脱节的,需要人工进行关联,过程繁琐且易出错。
本工作流通过AI技术自动化地弥合了代码与业务知识之间的鸿沟:
-
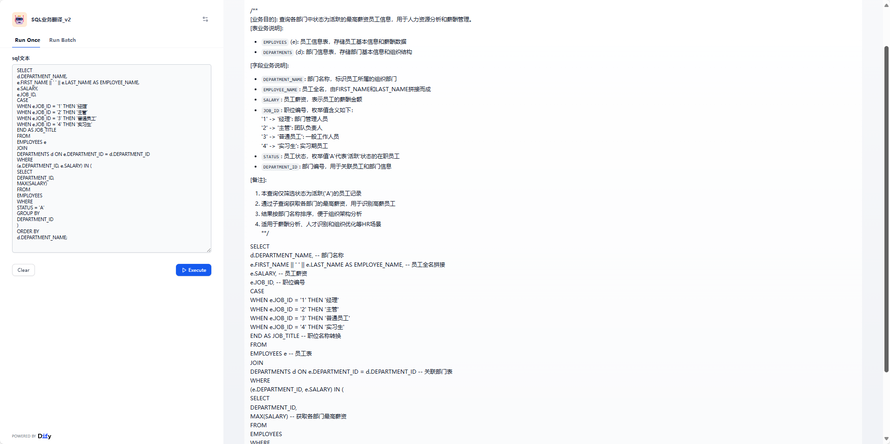
自动化解析与增强: 自动解析SQL代码的物理结构(表、字段),并智能地关联企业知识库,为其注入业务灵魂(注释、枚举值说明、业务逻辑)。
-
秒级知识传承: 新同事或任何使用者可以在几秒内获得一段复杂代码的详细业务解读,极大降低了学习成本和沟通成本。
-
统一知识来源: 将散落的知识库信息与具体的代码资产动态绑定,确保了知识的一致性和时效性,打造了“活”的数据资产目录。
-
7x24小时无损交付: 无论原开发者是否在职,该系统都能提供稳定、客观的注释说明,保障了企业数据资产的持续可理解性。
二、技术流

三、 效果展示
四、实际收益
|
|
|
|
|---|---|---|
| 效率 | 极速理解与上手 | 代码理解时间从 “小时级” 降至 “分钟级”,新人效率提升 90%+ |
|
|
敏捷开发与响应 | 减少 “猜业务-问人” 循环,需求响应与开发调试速度显著加快 |
| 质量 | 减少错误与歧义 | 精准注释杜绝因误解导致的错误分析与决策,数据准确性大幅提高 |
|
|
标准化知识沉淀 | 自动化生成统一、完整的注释,杜绝人工遗漏,形成企业规范 |
|
|
降低数据门槛 | 赋能业务与分析师人员自主探索数据,促进数据民主化 |
| 隐性价值 | 消除人员依赖 | 规避人员变动导致的知识流失风险,保障资产持续可维护 |
|
|
提升资产复用 | 清晰的代码便于发现和复用,减少重复开发,节约成本 |
五、扩展应用
通过解析SQL,自动构建字段级、表级的数据血缘图,清晰展示数据的来源、加工和去向,强力支撑影响分析和故障溯源
与企业Git仓库集成,在Merge Request阶段自动为新增的SQL脚本生成注释文档,并关联到数据资产目录,实现资产目录的自动更新
将其封装成一个Chatbot,开发者可以直接提问:“这个存储过程是干什么的?”,系统自动检索并生成答案
了解更多数据库AI实践,欢迎访问我们的开源项目:
GitHub项目地址: https://github.com/zqf20096327/dify_for_db

来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/30272888/viewspace-3095538/ ,如需转载,请注明出处,否则将追究法律责任。

最新文章
- 破解Oracle难题:用搜索引擎+AI高效处理cursor:pin S等待事件
- MySQL的ibdata1丢了!我们如何用AI快速批量恢复数千张表?
- AI助力MySQL参数调优:一键生成MySQL最佳参数,2分钟达DBA水准
- 拜年+散分贴《Oracle SQL_TRACE和10046事件优化SQL实例》
- 【笔记】oracle 并行原理深入解析及案例精粹
- 【RANDOM】使用dbms_random.string产生随机字符串的用法及应用
- Oracle10g新特性——记录DML错误日志(三)
- Oracle10g新特性——记录DML错误日志(二)
- Oracle10g新特性——记录DML错误日志(一)
