被DeepSeek误导,彻底将达梦数据库玩废了!
问题:
达梦守护集群 主库基于时间点的恢复,备库需要重建吗?
理论上应该需要重建,因为主库基于时间点往前恢复后,备库比主库数据更新,
除非启动备库后会以主库为主自动闪回到主库相同的数据?
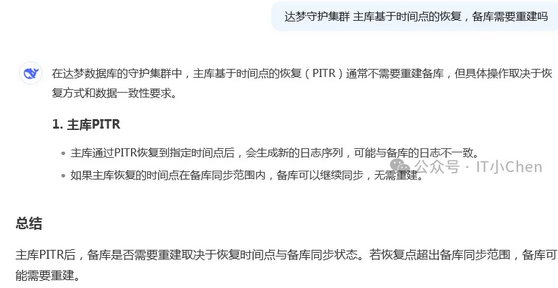
DeepSeek回答:
在达梦数据库的守护集群中,主库基于时间点的恢复(PITR) 通常不需要重建备库 ,
但具体操作取决于恢复方式和数据一致性要求。
主库PITR:
主库通过PITR恢复到指定时间点后,会生成新的日志序列,可能与备库的日志不一致。
如果主库恢复的时间点在备库同步范围内,备库可以继续同步,无需重建。
总结
主库PITR后,备库是否需要重建取决于恢复时间点与备库同步状态。若恢复点超出备库同步范围,备库可能需要重建。
测试说明:
对主库执行基于时间点的不完全恢复,备库是否需要重建?
先按照deepseek的建议,不重建备库,主库执行不完全恢复后,直接启动备库,结果直接将达梦数据库玩废了!
环境说明 :
达梦数据库守护集群
主:192.168.0.101 备:192.168.0.102
测试过程如下:
主库:新增测试数据
disql SYSDBA/******:5238
create table cjc.t3(id int,time time);
insert into cjc.t3 values(1,now());
insert into cjc.t3 values(2,now());
commit;
select * from cjc.t3;
主库:全备
backup database full to "DB_DAMENG_FULL_20250211"
backupset '/db/dm8/bak/full/full_20250211' compressed level 1;
添加备份目录
SQL> SELECT SF_BAKSET_BACKUP_DIR_ADD('DISK','/db/dm8/bak/full');检查备份信息:
SQL> SELECT BACKUP_ID,PARENT_ID,BACKUP_NAME,BACKUP_PATH,TYPE,LEVEL,OBJECT_NAME,
BACKUP_TIME,BEGIN_LSN,END_LSN FROM V$BACKUPSET;
检查备份文件
SQL> host ls -lrth /db/dm8/bak/full/full_20250211/
模拟误操作
删除cjc.t3表全部数据
host date;
Tue Feb 11 09:39:31 CST 2025
delete from cjc.t3 where 1=1;
commit;
host date;T
ue Feb 11 09:39:42 CST 2025
SQL> select * from cjc.t3;
未选定行
数据库恢复
注意,下面的恢复方式是有问题的,仅供参考!
主库做基于时间点的不完全恢复,将数据恢复到删除前的时刻。
先停备库
systemctl stop DmWatcherServiceWATCHER.service
再停主库
systemctl stop DmWatcherServiceWATCHER.service
主库恢复
dmrman
还原:
RESTORE DATABASE '/db/dm8/data/cjc/dm.ini' FROM BACKUPSET '/db/dm8/bak/full/full_20250211';
恢复(基于时间点):
RECOVER DATABASE '/db/dm8/data/cjc/dm.ini' WITH ARCHIVEDIR '/db/dm8/arch' UNTIL TIME '2025-02-11 09:39:31';
更新数据库魔数
RECOVER DATABASE '/db/dm8/data/cjc/dm.ini' UPDATE DB_MAGIC;
恢复后无法使用
主库:启动数据库
systemctl start DmWatcherServiceWATCHER.service
实例只能启动到 MOUNT 状态
dmdba@cjc-db-01:/home/dmdba$disql SYSDBA/******:5238
服务器[LOCALHOST:5238]:处于主库配置状态
SQL> desc v$instance;
第119 行附近出现错误[-510]:系统处于MOUNT状态.
已用时间: 2.210(毫秒). 执行号:0.
备库:启动数据库
systemctl start DmWatcherServiceWATCHER.service
??? 后启动的备库自动切换为主库了 ???
应该是检查主、备库哪个数据新,哪个自动变成主库,因为主库做了基于时间点的不完全恢复,数据比备库旧!
新备库 RSTAT 是 INVALID 状态,无法正常使用!
show global info
192.168.0.101 查询数据:数据恢复,但是变成了备库,无法对外提供服务!
SQL> select * from cjc.t3;
192.168.0.102 变成了新主库,但数据是丢失的,也有问题
SQL> select * from cjc.t3;
未选定行已用时间: 0.225(毫秒). 执行号:503.
192.168.0.102 新增数据,192.168.0.101 不能同步
switchover GRP1.CJC01
实例CJC01[STANDBY, OPEN, ISTAT_SAME:TRUE]的归档状态无效或到实例CJC02
[PRIMARY, OPEN, ISTAT_SAME:TRUE]的MAL链路异常
总之,一句话,恢复方式有问题,达梦数据守护集群彻底搞废了!
正确的恢复步骤:
那么达梦数据守护集群,如果正确执行基于时间点的不完全恢复呢?
下面是我测试的方法,需要重建备库,仅供参考!
1.停 192.168.0.102 守护服务和实例;
2.将 192.168.0.101 强制启动;
3.192.168.0.101 脱机全备;
4.192.168.0.102 备份并删除实例文件,重新初始化实例;
5.192.168.0.102 脱机恢复;
6.主、备库启动;
7.检查集群状态、主从同步。
1.停 192.168.0.102 守护服务和实例
systemctl stop DmWatcherServiceWATCHER.service
2.将 192.168.0.101 强制启动
SQL> alter database mount;
alter database mount;
第1 行附近出现错误[-720]:守护进程处于活动状态,或当前配置(ALTER_MODE_STATUS)不允许该操作.
修改参数
dmdba@cjc-db-01:/db/dm8/data/cjc$
vi dm.ini
ALTER_MODE_STATUS = 0 改为ALTER_MODE_STATUS = 1
启动数据库
DmServicecjc start
如果不是open状态,强制启动open
alter database open;
检查数据,确保之前的误删除已恢复,如没有恢复,再次执行一次不完全恢复。
SQL> select * from cjc.t3;
3.192.168.0.101 脱机全备
dmrman CTLSTMT="BACKUP DATABASE '/db/dm8/data/cjc/dm.ini' FULL
TO BACKUP_FILE100 BACKUPSET '/db/dm8/bak/tmp/BACKUP_FILE_100'"
拷贝到备库
scp -P 16022 -r /db/dm8/bak/tmp/BACKUP_FILE_100 192.168.0.102:/db/dm8/bak/tmp/
4.192.168.0.102 备份并删除实例文件,重新初始化实例
mv /db/dm8/data/cjc /db/dm8/data/cjc_bak
mv /db/dm8/redo/* /db/dm8/data/cjc_bak/
mv /db/dm8/ctl/* /db/dm8/data/cjc_bak/
cp /db/dm8/data/cjc_bak/*.ini /db/dm8/data/cjc/
重新初始化数据库
dminit path=/db/dm8/data CTL_PATH=/db/dm8/ctl/dm01.ctl
LOG_PATH=/db/dm8/redo/dm_redo01.log
LOG_PATH=/db/dm8/redo/dm_redo02.log
CASE_SENSITIVE=N CHARSET=1 DB_NAME=cjc
INSTANCE_NAME=cjc02 SYSDBA_PWD=****** SYSAUDITOR_PWD=******
BUFFER=1024 PORT_NUM=5238 AUTO_OVERWRITE=0 EXTENT_SIZE=32
PAGE_SIZE=32 LENGTH_IN_CHAR=1
注意:
如果不重新初始化实例,直接进行脱机恢复,备库一直处于 SPLIT 状态,无法OPEN,无法加入到守护集群。
show global info
5.192.168.0.102 脱机恢复
脱机恢复
dmrman CTLSTMT="restore database '/db/dm8/data/cjc/dm.ini' from
backupset '/db/dm8/bak/tmp/BACKUP_FILE_100'"
dmrman CTLSTMT="recover database '/db/dm8/data/cjc/dm.ini' from
backupset '/db/dm8/bak/tmp/BACKUP_FILE_100'"
dmrman CTLSTMT="recover database '/db/dm8/data/cjc/dm.ini' update DB_MAGIC "
6.主、备库启动
配置主库:
dmserver /dm8/data/cjc/dm.ini mount
登录主库
disql SYSDBA/xxxxxx:5238
SP_SET_PARA_VALUE(1, 'ALTER_MODE_STATUS', 1);
sp_set_oguid(101102);
alter database primary;
SP_SET_PARA_VALUE(1, 'ALTER_MODE_STATUS', 0);
配置备库:
dmserver /dm8/data/cjc/dm.ini mount
登录备库
disql SYSDBA/xxxxxx:5238
SP_SET_PARA_VALUE(1, 'ALTER_MODE_STATUS', 1);
sp_set_oguid(101102);
alter database standby;
SP_SET_PARA_VALUE(1, 'ALTER_MODE_STATUS', 0);
重新启动:
备库shutdown immediate;
主库shutdown immediate;
主库systemctl start DmWatcherServiceWATCHER.service
备库systemctl start DmWatcherServiceWATCHER.service
7.检查集群状态、主从同步
恢复正常,可以正常同步数据。
show global info
之前误删除的数据,也正常恢复了!
重要消息:
近期发布了 达梦数据库实战课程,预计30课时左右,当前已经发布了7课时,
主要以 实战运维为主,感兴趣的朋友可以订阅,一起学习!
合集链接入口:
达梦数据库实战,从入门到精通!
欢迎关注我的公众号《IT小Chen》
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29785807/viewspace-3072138/ ,如需转载,请注明出处,否则将追究法律责任。

