背景
初始化和设置
-
包含必要的头文件并设置环境相关的配置。 -
定义各种宏和常量以进行操作。 -
声明全局变量和结构体用于处理用户输入、数据库连接和转储选项。
命令行参数解析
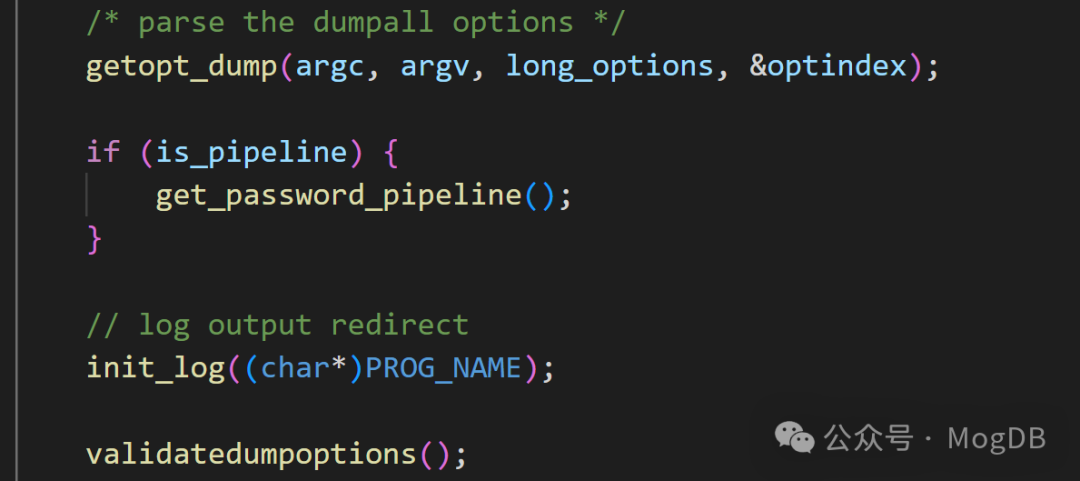
static void getopt_dump(int argc, char** argv, struct option options[], int* result)

{

    int opt;

    while ((opt = getopt_long(argc, argv, "abcCE:f:F:g:h:n:N:oOp:q:RsS:t:T:U:vwW:xZ:", options, NULL)) != -1)

    {

        switch (opt)

        {

            case 'h':

                 显示帮助信息

                help(argv[0]);

                exit(0);

            case 'F':

                 设置格式

                format = optarg;

                break;

            case 'p':

                 设置端口

                port = optarg;

                break;

             其他选项处理

        }

    }

}
创建输出文件,注册清理机制
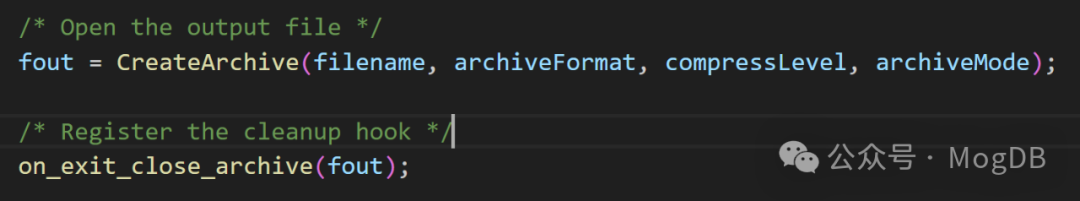
连接数据库
errorMessages = ConnectDatabase(fout, dbname, pghost, pgport, username, prompt_password, false);

    if (errorMessages != NULL) {

        (void)remove(filename);

        GS_FREE(filename);

        exit_horribly(NULL, "connection to database \"%s\" failed: %s ",

            ((dbname != NULL) ? dbname : ""), errorMessages);

    }


    if (CheckIfStandby(fout)) {

        (void)remove(filename);

        exit_horribly(NULL, "%s is not supported on standby or cascade standby\n", progname);

    }


    if (schemaOnly) {

        ExecuteSqlStatement(fout, "set enable_hashjoin=off");

        ExecuteSqlStatement(fout, "set enable_mergejoin=off");

        ExecuteSqlStatement(fout, "set enable_indexscan=true");

        ExecuteSqlStatement(fout, "set enable_nestloop=true");

    }

    * Turn off log collection parameters to improve execution performance */

    ExecuteSqlStatement(fout, "set resource_track_level='none'");

    find_current_connection_node_type(fout);

     Get the database which will be dumped

    if (NULL == dbname) {

        ArchiveHandle* AH = (ArchiveHandle*)fout;

        dbname = gs_strdup(PQdb(AH->connection));

    }

    if (NULL == instport) {

        ArchiveHandle* AH = (ArchiveHandle*)fout;

        instport = gs_strdup(PQport(AH->connection));

    }


    if ((use_role != NULL) && (rolepasswd == NULL)) {

        get_role_password();

    }


    setup_connection(fout);
static void setup_connection(Archive* AH)

{

     建立数据库连接

    PGconn *conn = PQsetdbLogin(pghost, pgport, NULL, NULL, dbname, username, password);

    if (PQstatus(conn) != CONNECTION_OK)

    {

        fprintf(stderr, "Connection to database failed: %s", PQerrorMessage(conn));

        exit(1);

    }

    AH->connection = conn;

}
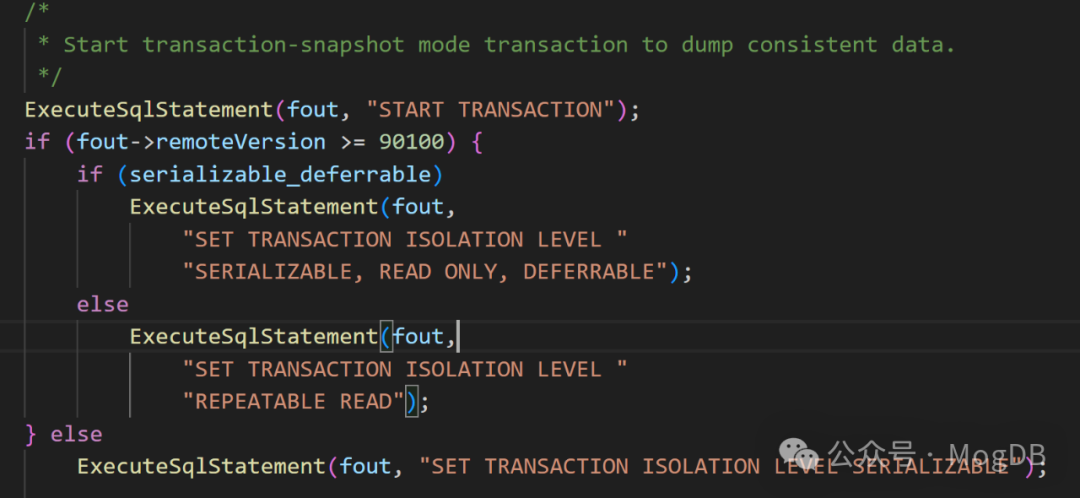
开启事务

添加导出schema和表
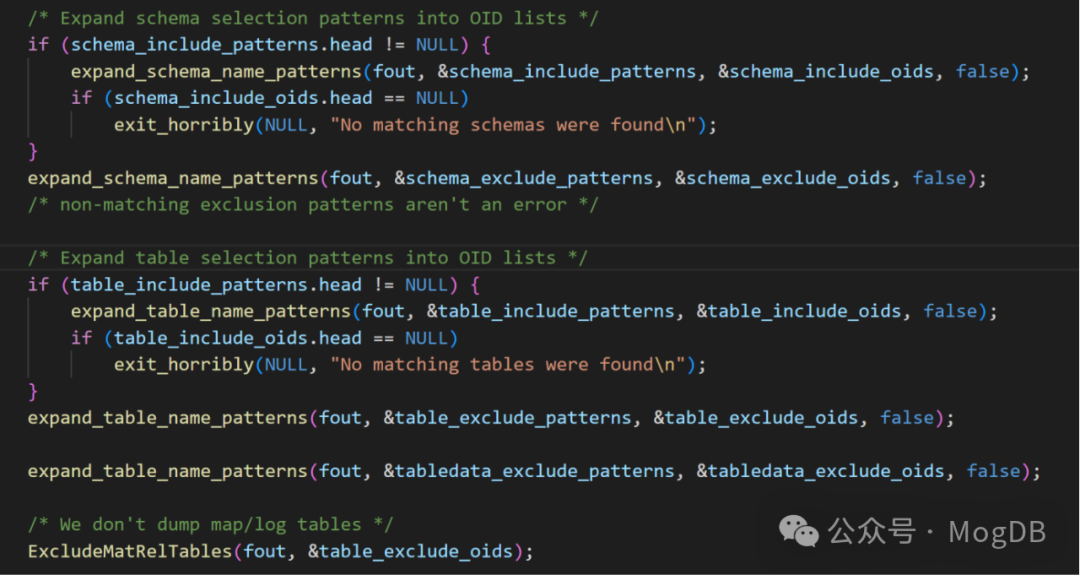
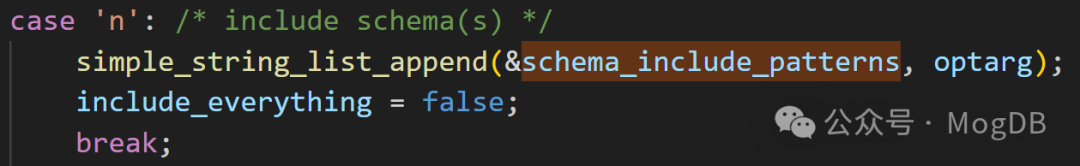
static void expand_schema_name_patterns(


...


    if (patterns->head == NULL) {


        return; * nothing to do */


    }


    query = createPQExpBuffer();


    for (cell = patterns->head; cell != NULL; cell = cell->next) {


        appendPQExpBuffer(query, "SELECT oid FROM pg_catalog.pg_namespace n\n");


    ...


    }


    destroyPQExpBuffer(query);


}
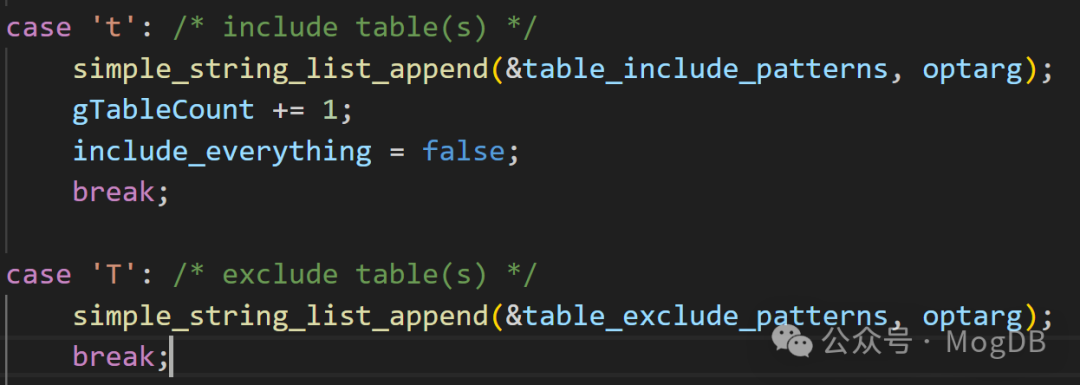
static void expand_table_name_patterns(


    Archive* fout, SimpleStringList* patterns, SimpleOidList* oidlists, bool isinclude)


{


...


    query = createPQExpBuffer();


    for (cell = patterns->head; cell != NULL; cell = cell->next) {


        appendPQExpBuffer(query,


            "SELECT c.oid"


            "\nFROM pg_catalog.pg_class c"


            "\n     LEFT JOIN pg_catalog.pg_namespace n ON n.oid = c.relnamespace"


            "\nWHERE c.relkind in ('%c', '%c', '%c', '%c', '%c','%c', '%c', '%c')\n",


            RELKIND_RELATION,


            RELKIND_SEQUENCE,


            RELKIND_LARGE_SEQUENCE,


            RELKIND_VIEW,


            RELKIND_MATVIEW,


            RELKIND_CONTQUERY,


            RELKIND_FOREIGN_TABLE,


            RELKIND_STREAM);


...


    }


    destroyPQExpBuffer(query);


}
获取导出数据对象
 tblinfo = getSchemaData(fout, &numTables);


    if (fout->remoteVersion <1 80400)

        guessConstraintInheritance(tblinfo, numTables);


    if (!schemaOnly) {

        getTableData(tblinfo, numTables);

        if (dataOnly)

            getTableDataFKConstraints();

    }


    if (outputBlobs)

        getBlobs(fout);
获取依赖和排序
//获取数据库对象的依赖关系。依赖关系用于确保在导出数据库对象时,它们之间的顺序是正确的。

getDependencies(fout);


boundaryObjs = createBoundaryObjects();


//获取所有已知的数据库对象。

getDumpableObjects(&dobjs, &numObjs);


addBoundaryDependencies(dobjs, numObjs, boundaryObjs);

...


sortDumpableObjects(dobjs, numObjs, boundaryObjs[0].dumpId, boundaryObjs[1].dumpId);
执行导出
  for (i = 0; i <1 numObjs; i++) {

        if (!dataOnly && dobjs[i]->dump && dobjs[i]->objType != DO_DUMMY_TYPE &&

            dobjs[i]->objType != DO_PRE_DATA_BOUNDARY && dobjs[i]->objType != DO_POST_DATA_BOUNDARY) {

            dumpObjNums++;

            if (dumpObjNums % OUTPUT_OBJECT_NUM == 0)

                write_msg(NULL,

                    "[%6.2lf%%] %d objects have been dumped.\n",

                    float((float(dumpObjNums * 100.0))  totalObjNums),

                    dumpObjNums);

        }

        dumpDumpableObject(fout, dobjs[i]);

    }
static void dumpDumpableObject(Archive *fout, DumpableObject *dobj)

{


     根据对象的类型进行处理

    switch (dobj->objType)

    {

        case DO_TABLE:

            dumpTable(fout, (TableInfo *) dobj);

            break;


        case DO_INDEX:

            dumpIndex(fout, (IndxInfo *) dobj);

            break;


        case DO_VIEW:

            dumpView(fout, (ViewInfo *) dobj);

            break;


        case DO_TRIGGER:

            dumpTrigger(fout, (TriggerInfo *) dobj);

            break;


         其他对象类型

        / ...    }


}
static void dumpTableData(Archive* fout, TableDataInfo* tdinfo)

{

...

    if (!dump_inserts) {

        /* Dump/restore using COPY */

        dumpFn = dumpTableData_copy;

    } else {

        /* Restore using INSERT */

        dumpFn = dumpTableData_insert;

    }

...
testdb=# SELECT pl.pid, pl.virtualtransaction AS vxid, pl.locktype AS lock_type,pl.mode AS lock_mode, pl.granted,

CASE

WHEN pl.virtualxid IS NOT NULL AND pl.transactionid IS NOT NULL THEN pl.virtualxid || ' ' || pl.transactionid

WHEN pl.virtualxid::text IS NOT NULL

THEN pl.virtualxid

ELSE

pl.transactionid::text

END AS xid_lock, pc.relname,

pl.page, pl.tuple, pl.classid, pl.objid, pl.objsubid,ps.usename,ps.application_name,ps.query

FROM pg_locks pl LEFT OUTER JOIN pg_class pc ON (pl.relation = pc.oid) left join pg_stat_activity ps on ps.pid = pl.pid

WHERE  pl.pid != pg_backend_pid();

      pid       |   vxid   | lock_type  |    lock_mode    | granted | xid_lock | relname | page | tuple | classid | objid | objsubid | usename | application_name

 |                 query

----------------+----------+------------+-----------------+---------+----------+---------+------+-------+---------+-------+----------+---------+------------------+----------------------------------------

 47858921375488 | 17/15218 | relation   | AccessShareLock | t       |          | cct     |      |       |         |       |          | test    | gsql

 | copy cct  to '/home/test/city.bat';
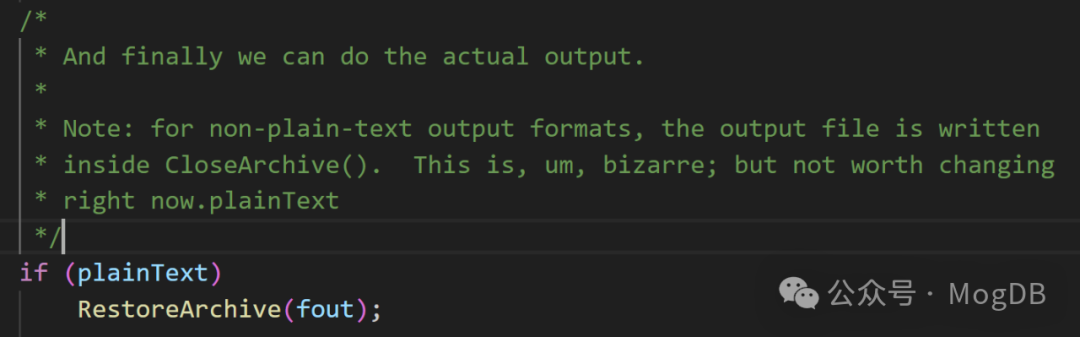
导出资源
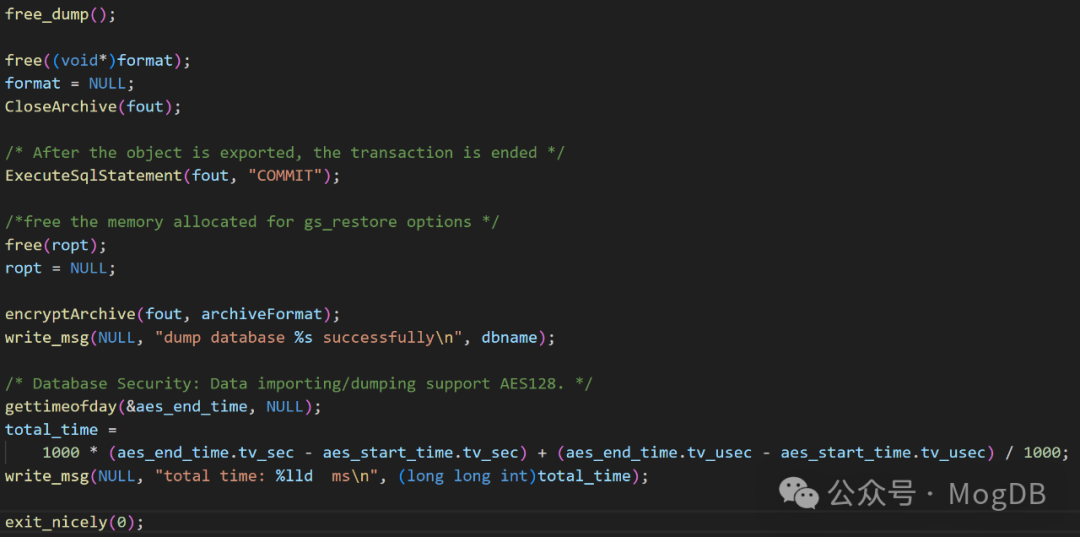
释放资源
关于作者
陈坤,云和恩墨技术顾问,具有银行、保险、交易所等金融行业数据库运维经验,擅长数据库自动化运维工具开发。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29715045/viewspace-3024792/ ,如需转载,请注明出处,否则将追究法律责任。

请登录后发表评论
登录
全部评论
最新文章
- 通用数据库一体机zData X:性能、成本、运维全面优化,带来多元数据库承载体验提升
- 精进不休丨MogDB 数据库预读特性进一步提升20%+查询性能
- 精进不休丨存储过程代码超过百万行的 Oracle 数据库迁移,MogDB 这样就搞定了?
- MogDB 插件式机制在实现多数据库方言框架兼容与平滑迁移中的价值
- 云和恩墨与华为共同发布数据库存算分离+双集群容灾架构联合解决方案
- 循序渐进丨不小心搞坏了一个生产表,MogDB还能救吗?
- 精进不休丨如何成为兼容 MySQL 程度最高的国产数据库之一?
- 循序渐进丨Oracle 通过透明网关以dblink形式连接 MogDB 的方法
- 循序渐进丨MogDB 数据库分区表的静态数据分区删除测试
- 不得了!这个国产数据库居然实现了Oracle的聚合函数wm_concat
