今天凌晨,又被电话叫醒了,说是有1个sql,现在跑的很慢。问题已经挺严重了,想让我看看,能不能做点什么。
首先就是和他们确认最近有什么改动,他们说这个是用了很久的sql语句了,没有任何的改动,再听他们说,之前也没有任何的问题。
然后就和他们确认之前这个jobl处理大概多长时间,那个哥们说他也是最近才进的这个项目,可能数据量不同,他也不清楚。但是他肯定的说这个job会跑的很快,几个小时肯定能处理完。
大概了解了下,他们也确定具体的sql语句是什么,没有得到太多的信息,首先通过top命令来抓一下目前消耗资源比较多的进程。
PID USER PR NI VIRT RES SHR S %CPU %MEM TIME+ COMMAND
9543 oradb1 25 0 12.2g 25m 21m R 100.0 0.0 426:03.72 oracleDB01 (LOCAL=NO)
32334 oradb1 25 0 12.2g 26m 22m R 100.0 0.0 36:46.28 oracleDB01 (LOCAL=NO)
通过如下的郑州牛皮癣医院脚本可以抓到当前的process正在进行的sql语句。
if [ -z "$1" ]; then
echo "no process has provided!"
exit 0
fi
sh_tmp_process=`sqlplus -silent $DB_CONN_STR@$SH_DB_SID
<
set pagesize 0 feedback off verify off heading on echo off
select addr from v\\$process where spid=$1;
exit;
END`
if [ -z "$sh_tmp_process" ]; then
echo "no process exists or session is not from a DB account"
echo
echo "####### Process Information from OS level as below ########"
ps -ef|grep $1|grep -v "grep"|grep ora
echo "##############################################"
exit 0
else
echo '*******************************************'
echo "Process has found, pid: $1 , addr: $sh_tmp_process "
echo
echo "####### Process Information from OS level as below ########"
ps -ef|grep $1|grep -v grep|grep ora
echo "##############################################"
sqlplus -s $DB_CONN_STR@$SH_DB_SID <
col machine format a20
col terminal format a15
col osuser format a15
col process format a15
col username format a15
set linesize 150
select sid,serial#,username,osuser ,machine,process,terminal,type,to_char(LOGON_TIME,'yyyy-mm-dd hh24:mi:ss')login_time from v\$session
where paddr='$sh_tmp_process';
prompt .
col sql_id format a30
col prev_sql_id format a30
col sql_text format a60
set linesize 150
set pages 50
select sql_id,sql_text from v\$sql where sql_id in (select sql_id from v\$session where paddr='$sh_tmp_process' and sql_id is not null ) and rownum<2;
select sql_id prev_sql_id ,sql_text from v\$sql where sql_id in (select prev_sql_id sql_id from v\$session where paddr='$sh_tmp_process' ) and rownum<2;
EOF
fi
结果看了一下,和他们确认,就是他们的job要用的sql语句。可以看到里面已经有一些hint,想必是之前就碰到过问题,优化过的。
这个语句也算是挺长的一个sql了,郑州最好的牛皮癣医院里面用到了union all来做两个结果的合并。
SELECT DISTINCT 'K',
AR.RESOURCE_VALUE,
AR.RESOURCE_TYPE,
GREATEST(TO_CHAR(AR.EFFECTIVE_DATE, 'YYYYMMDDHH24MISS'),
TO_CHAR(SB.EFFECTIVE_DATE, 'YYYYMMDDHH24MISS')),
LEAST(NVL(TO_CHAR(AR.EXPIRATION_DATE, 'YYYYMMDDHH24MISS'),
'47001231000000'),
NVL(TO_CHAR(SB.EXPIRATION_DATE, 'YYYYMMDDHH24MISS'),
'47001231000000')),
AR.AGR_NO,
SB.MEDIUM_CUS_ID,
SB.SUB_STATUS,
SB.BUSINESS_ENTITY_ID,
SB.LANGUAGE,
SB.ROUTING_POLICY_ID,
SB.L9_PORT_IND,
SB.L9_SPLIT_PERIOD
FROM HUGE_RESOURCE AR,
MEDIUM_SUB SB,
(select /*+ RESULT_CACHE */
DISTINCT PARAM_NAME as PARAM_NAME
from SMALL_PARAM
where GUIDING_IND = 'Y') OP,
MEDIUM_CUS CS
WHERE AR.AGR_NO = 1056851
AND AR.AGREEMENT_KEY = MOD(1056851, 100)
AND (AR.RESOURCE_STATE != 'F' OR AR.RESOURCE_STATE IS NULL)
AND AR.RANGE_IND = 'N'
AND SB.MEDIUM_SUB_NO = AR.AGR_NO
AND EXISTS
(select /*+ INDEX(OP SMALL_PARAM_1IX) */
1
from SMALL_PARAM OP
where OP.PARAM_NAME in (AR.RESOURCE_PRM_CD, AR.BASE_PARAM_NAME) )
AND SB.MEDIUM_CUS_ID = CS.MEDIUM_CUS_ID
AND (SB.EXPIRATION_DATE IS NULL OR SB.EXPIRATION_DATE >= to_date('19000101000000','YYYYMMDDHH24MISS'))
AND (AR.EXPIRATION_DATE IS NULL OR AR.EXPIRATION_DATE >= to_date('19000101000000','YYYYMMDDHH24MISS'))
AND (AR.EFFECTIVE_DATE < SB.EXPIRATION_DATE OR
SB.EXPIRATION_DATE IS NULL)
AND (AR.EXPIRATION_DATE IS NULL OR
AR.EXPIRATION_DATE > SB.EFFECTIVE_DATE)
AND SB.SUB_STATUS != 'T'
UNION ALL
SELECT DISTINCT 'K',
AR.RESOURCE_VALUE,
AR.RESOURCE_TYPE,
GREATEST(TO_CHAR(AR.EFFECTIVE_DATE, 'YYYYMMDDHH24MISS'),
TO_CHAR(SH.EFFECTIVE_DATE, 'YYYYMMDDHH24MISS')),
LEAST(NVL(TO_CHAR(AR.EXPIRATION_DATE, 'YYYYMMDDHH24MISS'),
'47001231000000'),
NVL(TO_CHAR(SH.EXPIRATION_DATE, 'YYYYMMDDHH24MISS'),
'47001231000000')),
AR.AGR_NO,
SH.MEDIUM_CUS_ID,
SH.SUB_STATUS,
SH.BUSINESS_ENTITY_ID,
SH.LANGUAGE,
SH.ROUTING_POLICY_ID,
SH.L9_PORT_IND,
SH.L9_SPLIT_PERIOD
FROM HUGE_RESOURCE AR,
MEDIUM_SUB_HISTORY SH,
(select /*+ RESULT_CACHE */
DISTINCT PARAM_NAME as PARAM_NAME
from SMALL_PARAM
where GUIDING_IND = 'Y') OP,
MEDIUM_CUS CS
WHERE AR.AGR_NO = 1056851
AND AR.AGREEMENT_KEY = MOD(1056851, 100)
AND (AR.RESOURCE_STATE != 'F' OR AR.RESOURCE_STATE IS NULL)
AND AR.RANGE_IND = 'N'
AND SH.MEDIUM_SUB_NO = AR.AGR_NO
AND EXISTS
(select /*+ INDEX(OP SMALL_PARAM_1IX) */
1
from SMALL_PARAM OP
where OP.PARAM_NAME in (AR.RESOURCE_PRM_CD, AR.BASE_PARAM_NAME))
AND SH.MEDIUM_CUS_ID = CS.MEDIUM_CUS_ID
AND (SH.EXPIRATION_DATE IS NULL OR SH.EXPIRATION_DATE >= to_date('19000101000000','YYYYMMDDHH24MISS'))
AND (AR.EXPIRATION_DATE IS NULL OR AR.EXPIRATION_DATE >= to_date('19000101000000','YYYYMMDDHH24MISS'))
AND (AR.EFFECTIVE_DATE < SH.EXPIRATION_DATE OR
SH.EXPIRATION_DATE IS NULL)
AND (AR.EXPIRATION_DATE IS NULL OR
AR.EXPIRATION_DATE > SH.EFFECTIVE_DATE)
AND SH.SUB_STATUS NOT IN ('C', 'T')
和他们确认了基本的时间后,先抓一个awr看看里面怎么说。然后在这个基础上抓一个awr的sql report。看看执行计划的情况。
从执行计划来看,也是一个执行时间比较的sql语句,查看指标,消耗并不高,大概执行时间为5秒,但是根据他们的反馈,需要跑几十万个这样的查询。这样下来。这个语句得跑
8秒*80万次/60/60=111个小时,这样确实太长了。得跑将近5天的样子。
首先既然他们肯定了sql语句没有做过改动,而且也已经经过调优了,那就先看看为什么显示执行计划消耗没那么高,实际上却差别这么大,首先想到的就是statistics的问题。
在查看了关联的几个达标之后,发现有一个大表的统计信息误差有10%左右,其他的都在1%以内的样子。
这也是一个可能原因,在查看索引的使用情况,都走索引了,没有任何索引失效的情况。
sql语句不能随便动,只能下手的地方就是统计信息了,其他的性能参数一直都没有做过改动了。
和他们确认之后,先做了一个统计信息收集。
exec DBMS_STATS.GATHER_TABLE_STATS(OWNNAME=> NULL, TABNAME => 'HUGE_RESOURCE', CASCADE => TRUE,METHOD_OPT =>'FOR ALL INDEXED COLUMNS SIZE 1', ESTIMATE_PERCENT => 40 , DEGREE => 8,GRANULARITY =>'ALL');
执行之后就创建了一个快照,然后过了几分钟之后又生成一个快照,发现明显快了不少,从5秒降低到了2秒。也算是不少的收获了。2秒*80000次/60/60=44.4小时,还是有一些问题,然后剩下的问题就是看看之前的执行情况了。
下面是我在最近这一个月左右的时间内现有的awr中找到的。时间浮动还是比较小。
Elapsed Time (s)ExecutionsElapsed Time per Exec (s)%Total%CPU%IOSQL IdSQL ModuleSQL Text
31st May305.441452.1125.5699.690.262fjzq67jbztwvgext1GenericEx@ccbdbpr1 (TNS V1-V3)/* */ SELECT DISTINCT 'K', AR....
21st May413.886140.671.5099.740.178686n41y0jsndgext1GenericEx@ccbdbpr1 (TNS V1-V3)/* */ SELECT DISTINCT 'K', AR....
12th May100.17631.590.8099.680.25da18v3wt1u09ygext1GenericEx@ccbdbpr1 (TNS V1-V3)SELECT DISTINCT 'K', AR.RESOUR...
9th April818.457931.033.7399.860.09da18v3wt1u09ygext1GenericEx@ccbdbpr1 (TNS V1-V3)SELECT DISTINCT 'K', AR.RESOUR.
然后我仔细比较了一下对应的sql语句。发现今天碰到sql语句和之前的有一些不同之处。看来也不能全信
偶有了他们说的。
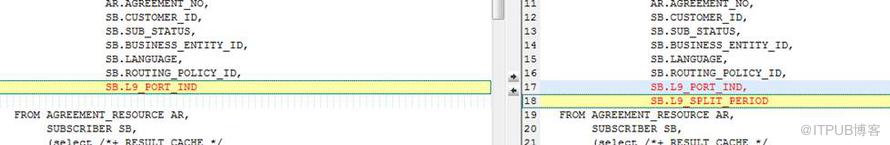
有了基本的参照,就可以在这个基础上分析了。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29661313/viewspace-1174399/ ,如需转载,请注明出处,否则将追究法律责任。

