问题现象:
日志盘(clog)满,导致集群出现问题:
收到磁盘告警,业务报错,无法执行写入和更新的SQL,无法选举和缺副本等
问题处理过程:
第一步:
根据告警及现象,判断出现问题的租户;
oceanbase的日志盘是预分配的,并且集群级别可以设置每个observer上的所有的租户可用的日志盘总和,并且可以根据实际情况配置每个observer为不同的值。
第二步:
通过如下SQL查看对应租户log_disk使用情况,登陆sys租户可以查看所有租户的使用情况,登录对应租户只能查看本租户的使用情况。
select a.svr_ip,a.svr_port,a.tenant_id,b.tenant_name,
CAST(a.data_disk_in_use/1024/1024/1024 as DECIMAL(15,2)) data_disk_use_G,
CAST(a.log_disk_size/1024/1024/1024 as DECIMAL(15,2)) log_disk_size,
CAST(a.log_disk_in_use/1024/1024/1024 as DECIMAL(15,2)) log_disk_use_G,
log_disk_in_use/log_disk_size 'usage%'
from oceanbase.__all_virtual_unit a,oceanbase.dba_ob_tenants b
where a.tenant_id=b.tenant_id;
第三步:
通过如下SQL检查集群的log_disk磁盘空间是否已经分配完,如果log_disk_free为0,则表示已分配完,(只能登录sys租户查看)
select zone,concat(SVR_IP,':',SVR_PORT) observer,
cpu_capacity_max cpu_total,cpu_assigned_max cpu_assigned,
cpu_capacity-cpu_assigned_max as cpu_free,
round(memory_limit/1024/1024/1024,2) as memory_total,
round((memory_limit-mem_capacity)/1024/1024/1024,2) as system_memory,
round(mem_assigned/1024/1024/1024,2) as mem_assigned,
round((mem_capacity-mem_assigned)/1024/1024/1024,2) as memory_free,
round(log_disk_capacity/1024/1024/1024,2) as log_disk_capacity,
round(log_disk_assigned/1024/1024/1024,2) as log_disk_assigned,
round((log_disk_capacity-log_disk_assigned)/1024/1024/1024,2) as log_disk_free,
round((data_disk_capacity/1024/1024/1024),2) as data_disk,
round((data_disk_in_use/1024/1024/1024),2) as data_disk_used,
round((data_disk_capacity-data_disk_in_use)/1024/1024/1024,2) as data_disk_free
from oceanbase.gv$ob_servers;
备注:
1)log_disk_capacity: 97.63 表示该observer上,最大可用的日志空间大小(97.63G),也就是log_disk_size或者
log_disk_percentage设置的大小。
2)log_disk_assigned: 71.04 表示该observer上给所有的租户分配的日志盘的总和为71.04G
3) log_disk_free: 26.59 表示该observer上还有26.59G空间磁盘空闲,还可以给租户分配;
第四步:
如果上面SQL查出来log_disk_free还有剩余空间,则直接扩容该租户的log_disk大小,通过如下SQL:当然也可以通过ocp平台来实现扩容;
备注:如果是通过ocp创建的租户,例如liuwenhe这个租户是通过ocp平台创建的,ocp会在三个observer节点上各自创建一个资源规格(不太理解为啥要这样设计,这点区别于用命令行创建的租户),然后每个unit(资源单元,区别于资源规格,create unit 创建的是资源规格)都有一个唯一UNIT_ID(DBA_OB_UNITS.UNIT_ID),并且每个unit都需要关联一个资源规格, 资源规格可以在DBA_OB_UNIT_CONFIGS这里查看。
首先查看待扩容的租户使用的unit 名字:
root@10.18.92.150 : oceanbase 22:28:24>select a.TENANT_NAME,a.TENANT_ID ,b.UNIT_GROUP_ID,c.NAME ,c.LOG_DISK_SIZE/1024/1024/1024 from DBA_OB_TENANTS a, DBA_OB_UNITS b, DBA_OB_UNIT_CONFIGS c where a.TENANT_ID=b.TENANT_ID and b.UNIT_config_ID=c.UNIT_CONFIG_ID;
+-------------+-----------+---------------+---------------------------------+--------------------------------+ | TENANT_NAME | TENANT_ID | UNIT_GROUP_ID | NAME | c.LOG_DISK_SIZE/1024/1024/1024 | +-------------+-----------+---------------+---------------------------------+--------------------------------+ | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone3_S3_jwe | 60.000000000000 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone1_S3_anp | 60.000000000000 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone2_S3_qpg | 60.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone1_hehe_unit_vwt | 3.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone3_hehe_unit_yfs | 2.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone2_hehe_unit_pjo | 2.000000000000 | +-------------+-----------+---------------+---------------------------------+--------------------------------+ 9 rows in set (0.04 sec) 根据前面查询到的某个租户的unit_name 来扩容: 因为是通过ocp创建的租户liuwenhe,他会有多个资源规则(每个zone都有),所以需要对每个资源规格依次都扩容,但是如果是通过命令行,先创建unit、然后资源池、最后租户,这样的话,每个租户就对应一个资源规则,只需要修改一次即可! ALTER RESOURCE UNIT config_hehe_zone1_hehe_unit_vwt LOG_DISK_SIZE = '3G'; ALTER RESOURCE UNIT config_hehe_zone3_hehe_unit_yfs LOG_DISK_SIZE = '3G'; ALTER RESOURCE UNIT config_hehe_zone2_hehe_unit_pjo LOG_DISK_SIZE = '3G'; 如下所示 liuhe这个租户的创建过程是:先创建unit、然后资源池、最后租户,这样的话,每个租户就对应一个资源规则,只需要修改一次即可 CREATE RESOURCE UNIT liuhe_unit MEMORY_SIZE = '5G', MAX_CPU = 1, MIN_CPU = 1, LOG_DISK_SIZE = '6G', MAX_IOPS = 10000, MIN_IOPS = 10000, IOPS_WEIGHT=1; CREATE RESOURCE POOL liuhe_pool UNIT='liuhe_unit', UNIT_NUM=1, ZONE_LIST=('zone1','zone2','zone3'); CREATE TENANT IF NOT EXISTS liuhe PRIMARY_ZONE='zone1,zone2,zone3' , RESOURCE_POOL_LIST=('liuhe_pool') set OB_TCP_INVITED_NODES='%'; 如下所示,liuhe这个租户对应一个资源规则: root@10.18.92.150 : oceanbase 23:03:18>select a.TENANT_NAME,a.TENANT_ID ,b.UNIT_GROUP_ID,c.NAME ,c.LOG_DISK_SIZE/1024/1024/1024 from DBA_OB_TENANTS a, DBA_OB_UNITS b, DBA_OB_UNIT_CONFIGS c where a.TENANT_ID=b.TENANT_ID and b.UNIT_config_ID=c.UNIT_CONFIG_ID; +-------------+-----------+---------------+---------------------------------+--------------------------------+ | TENANT_NAME | TENANT_ID | UNIT_GROUP_ID | NAME | c.LOG_DISK_SIZE/1024/1024/1024 | +-------------+-----------+---------------+---------------------------------+--------------------------------+ | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | sys | 1 | 1 | sys_unit_config | 11.039614410139 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone3_S3_jwe | 60.000000000000 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone1_S3_anp | 60.000000000000 | | liuwenhe | 1002 | 1001 | config_liuwenhe_zone2_S3_qpg | 60.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone1_hehe_unit_vwt | 3.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone3_hehe_unit_yfs | 3.000000000000 | | hehe | 1004 | 1002 | config_hehe_zone2_hehe_unit_pjo | 3.000000000000 | | liuhe | 1006 | 1003 | liuhe_unit | 6.000000000000 | | liuhe | 1006 | 1003 | liuhe_unit | 6.000000000000 | | liuhe | 1006 | 1003 | liuhe_unit | 6.000000000000 | +-------------+-----------+---------------+---------------------------------+--------------------------------+ 12 rows in set (0.02 sec) 如果需要对liuhe这个租户扩容:只需要对liuhe_unit这个资源规则扩容即可: ALTER RESOURCE UNIT liuhe_unit LOG_DISK_SIZE = '8G';
如果log_disk_free空间为0,则检查机器操作系统磁盘是否已经全部分配给OceanBase集群的日志盘,如果有剩余空间,可以修改集群级别log_disk_size 或者log_disk_percentage,增加OceanBase集群的log_disk大小,然后再通过上面命令,增加租户的log_disk大小,修改log_disk_size和log_disk_percentage SQL如下
ALTER system SET log_disk_size = '10G'; #该参数优先级高,注意这个值如果要减小的话,需要大于当前已经给所有租户分配的大小之和,否则命令执行成功,但是并没有生效;
ALTER system SET log_disk_percentage = 80;
#log_disk_percentage参数默认值根据日志和数据盘是否公用而不同:
共用时,Redo 日志占用其所在磁盘总空间的百分比为 30%,即分配磁盘总空间 30% 的日志文件。
独占时,Redo 日志占用其所在磁盘总空间的百分比为 90%,即分配磁盘总空间 90% 的日志文件。
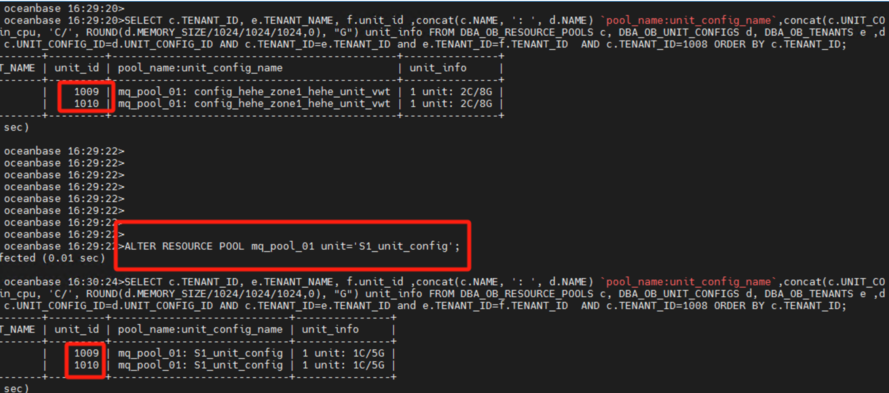
题外话:在通过调大和调小租户资源规格进行扩容和缩容时,有以下两种方式:
1)当前租户配置了独立的资源规格,可以直接修改租户的资源规格。
ALTER RESOURCE UNIT S2_unit_config MAX_CPU 5, MIN_CPU 5;
2)多个租户使用了相同的资源规格,需要切换租户的资源规格。防止影响别的租户。
ALTER RESOURCE POOL mq_pool_01 unit='new_S2_unit_config';
切换租户资源池对应的资源规格后,不会新建资源单元(如果新建unit,那么unit_id会变化),所以理论上不会迁移数据,这样来看,这两种方式实现租户扩容,内部机制是类似的。
第五步: 如果OceanBase集群log_disk已分配完,并且操作系统上的磁盘也已经被分配完, 可以先看看磁盘上还有没有可以删除的无用文件,若无, 则主动停止租户的写入, 防止 clog 盘临时腾挪的空间再次快速被业务写入打满,无法修复,
第六步:
停止租户写入后,临时调大 clog 盘停写的阈值比例,由 95% 调整到 98%,通过如下命令调整;
ALTER system SET log_disk_utilization_limit_threshold = 98;
观察一段时间,多数情况下 clog 追上后,集群可以恢复。
第七步:
如果还未恢复,扩容操作系统磁盘空间来增加足够的log_disk空间。
当出现这个情况的时候,说明dba已经出现了很大的差错,磁盘监控没有做好,或者收到监控没有及时处理。可以关闭租户业务后,进行一次租户级别的合并操作尝试触发redo日志截断。
如果还未恢复,如果数据盘和日志盘在同一个磁盘上,那么可以扩容zone的节点,数据迁移到别的observer节点,以释放redo磁盘空间,然后再调整observer的
log_disk_size,最后再调整租户的log_disk_size;
如果日志独占磁盘,那么只能想办法扩容操作系统磁盘空间来增加足够的log_disk空间或者修改日志的目录(redo_dir)到其他空间充足的目录上。
总结:
建议给oceanbase的clog_dir设置单独的目录,来提高性能,但是如果单独给redo设置磁盘的时候,需要更加合理的规划磁盘的大小,否则可能会出现由于redo磁盘空间不足,但是数据盘还非常空余的时候,集群需要扩容,建议根据oceanbase的业务情况,给clog_dir分配不低于observer的内存的三倍的磁盘空间,甚至更多些, 并且如果是ocp创建的租户,一个租户会对应多个资源规格和资源池,如果需要扩容,那么需要给所有的资源规格都得扩容。

