大家好,我是姚半仙,慕课网《Java架构师成长直通车》课程架构师讲师团成员之一。这篇文章中我们来看一下Stream如何处理异常。
大话Stream异常
人非圣贤孰能无过,Spring Cloud中哪个组件都不得不面临异常的情况,况且Java的运行期异常在任何时间任何地点都可以发生,真的是防不胜防,那我们在Stream里有什么方法来应对吗?
话说应付异常情况无非就是下面三个思路,放之四海而皆准:
- 重试 换个方式再来一次,简单方便。但是要留意程序逻辑是否实现了幂等性
- 降级 这个方案就要花点心思了,需要规划降级链路,但是对于那种“必须成功”的场景来说(比如银行转账),降级似乎不是一个好的选择
- 人工介入 这个方式就太多了,可以归集异常信息然后触发系统报警。人工介入是异常处理的最后一个环节,我们在系统设计环节应该尽量提高应用的self-heal能力,也就是容错能力,尽量减少人工介入的频率
大部分的小型应用系统只会使用第一种方案,也就是重试,能用到降级策略的一般都是有一定规模的应用。对于重试和降级都不能解决的异常情况来说,我们要么直接丢弃,要么就要打上某些特殊标记,然后通知人工介入处理。
在Stream中对以上三个情况都有相应的方案,后面我们会逐一体验这些异常处理策略。
直接发起重试
我们先来看一下最简单的重试机制,在Stream中进行重试有两个方法
(1) Consumer端重试
重试只发生在Consumer端,Stream将失败的消息原封不动的发给当前这个Consumer。也就是说,重试只会发生在当前机器,并不会换一个节点进行重试。
当然我们不能让重试无休止的进行下去,Stream默认情况下会进行3次重试,如果我们想增加或减少重试次数,可以给某个Consumer指定重试次数。
(2) Re-queue重试
不同于上一种的重试方式,在Re-queue的方案下Stream会将失败的消息重新发送到消息组件中,这种方式和前面的Consumer端重试有两个不同之处:
- 消息来源 Re-queue重试的发起点是消息组件,Stream通过Re-queue机制向队列中添加了一个新的消息,因此Consumer相当于从消息组件中处理了一个新消息。而Consumer重试的触发点是Stream本身,只是从业务逻辑层面进行重试,消费的是同一个消息。
- 消费地点 Re-queue添加的新消息可以被其他Consumer进行消费,而Consumer重试只发生在当前这个Consumer上,并不会跑到其他节点进行重试
Re-queue其实还有一个很大的坑,不小心就容易掉进去,我们在本章后面安排了一个小节专门讲异常处理的注意事项。
降级
降级说白了就是一段自定义的异常处理流程,在Stream中我们可以借助spring-integration的一个注解来完成,相关的配置非常简单,方法级别上的一行搞定一切
@ServiceActivator(inputChannel = "xxxx")
上面这个注解和Hystrix的Fallback有异曲同工之处,都是将异常请求转交给Fallback逻辑进行处理。关于这部分的内容,我们将在稍后的小节通过一个小Demo来详细说明。
人工处理
人工介入的方式五花八门,但归根结底我要知道在哪里才能找到需要人工介入的数据,这其实就是一个归集异常数据的功能。
在Stream里我们可以通过下面两个常用的方式,将异常消息归集到某个消息队列中,等待人工介入:
- 异常队列 将异常消息丢入Error Queue,如果做的再细致一些,可以分门别类地将不同错误类型的消息放到不同的异常队列中去
- 死信队列 又叫DLQ(Dead Letter Queue),是RabbitMQ专门为各种异常情况设置的队列,Stream天然集成了DLQ,在Stream中不仅可以将Re-queue的路径指向DLQ,也可以设置DLQ中消息的过期时间(对某些有时效性要求的消息)
在消息到达死信队列后,我们可以人工将消息移动到其他队列中进行重新消费,在稍后的小节里我将带大家配置一个死信队列。
案例分享
我先和大家分享一下我在新零售业务的商品发布服务里是如何处理异常情况的。
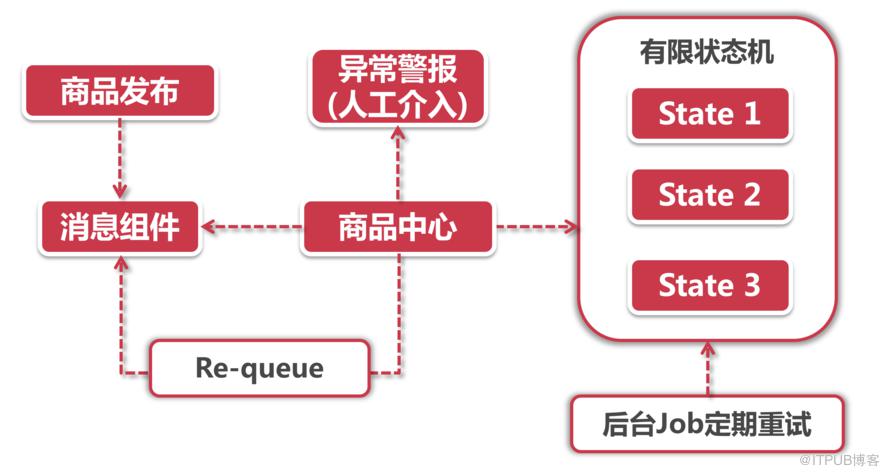
上面例子中的商品发布是借助消息组件完成的,整个发布流程涉及到上下游一大堆服务,为了保证严格的幂等性,我采用了一种简单有效的手段。
整个发布流程被定义成一个工作流,在Consumer(商品中心)接收到商品发布消息后,每做完一个发布阶段的任务都推动商品状态的变化(类似有限状态机的方式进行状态流转),在下次重试的时候,会根据状态标记获取当前商品最近一次的发布进度,然后继续走后面的流程。
在整个流程中我使用了一种重试机制和一种补偿手段:
- Re-queue 在商品发布阶段的异常情况通过Re-queue方式进行重试(有最大重试次数限制)
- 后台Job补偿 设置一个后台Job定时启动,用来触发批量重试。这个后台Job专门处理那些Re-queue次数达到阈值已经不再重试,但经过人工介入等手段修复了异常,可以继续做发布的商品
对于上面提到的无法靠Re-queue重试解决的异常情况(比如商品标题中带有违禁词),会被记录在案,等待人工介入,如果短时间内出现的异常记录超过阈值则触发警报,我就会收到包括短信、钉钉播报和自动电话语音的海陆空警报轰炸。
学习Tips:我们在实际的项目中需要搭配使用多种技术来完成一个需求,就拿商品发布的异常处理来说,就涉及了Re-queue、后台补偿Job、监控报警人工介入三个不同的环节。而对于某些一致性要求较高的场景,其中的异常处理更加复杂(比如TCC架构下的最终一致性方案)。同学们在实际应用中一定要重视异常Case,衡量一个服务的健壮性、可用性的标准不是正向Case走的多快多顺利,而是你是否Hold得住所有异常情况。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/2963/viewspace-2824792/ ,如需转载,请注明出处,否则将追究法律责任。

