什么是字符(character)? 字符是各种文字和符号的总称,包括各国家文字、标点符号、图形符号、数字等。
什么是字符集(charset)? 字符集是一个系统支持的所有抽象字符的集合。
什么是字符编码(Character Encoding)? 字符编码是指字符集中的字符以何种二进制进行储存。计算机中只保存该字符在某字符集中对应的字符编码。解码时必需使用相同的解码规则,如果使用了错误的解码规则,就会出现乱码。常见编码:ASCII、GB2312、BIG5、GB18030、Unicode等。
1、ASCII字符集&编码
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码,由ANSI制定)是基于拉丁字母的一套电脑编码系统。它主要用于显示现代英语,而其扩展版本EASCII则可以勉强显示其他西欧语言。它是现今最通用的单字节编码系统(但是有被Unicode追上的迹象),并等同于国际标准ISO/IEC 646。
ASCII字符集:主要包括控制字符(回车键、退格、换行键等);可显示字符(英文大小写字符、阿拉伯数字和西文符号)。
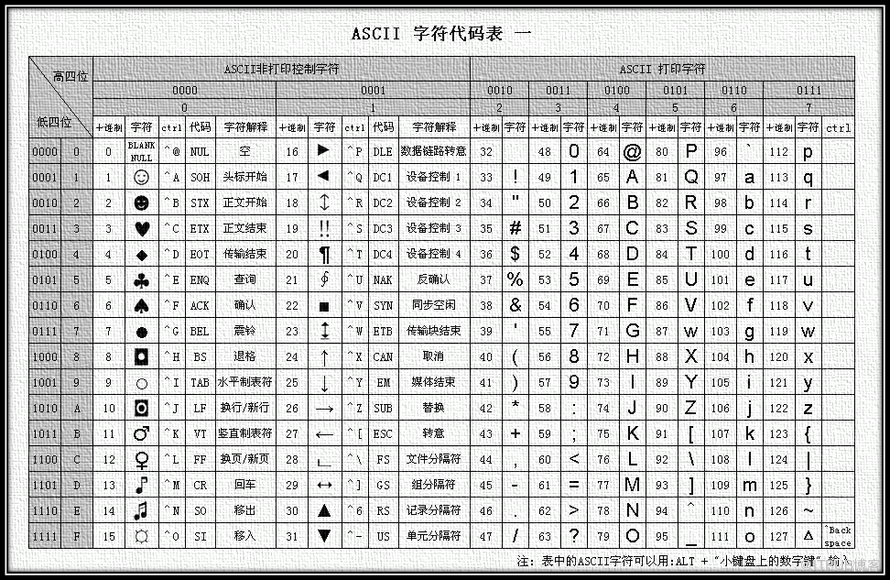
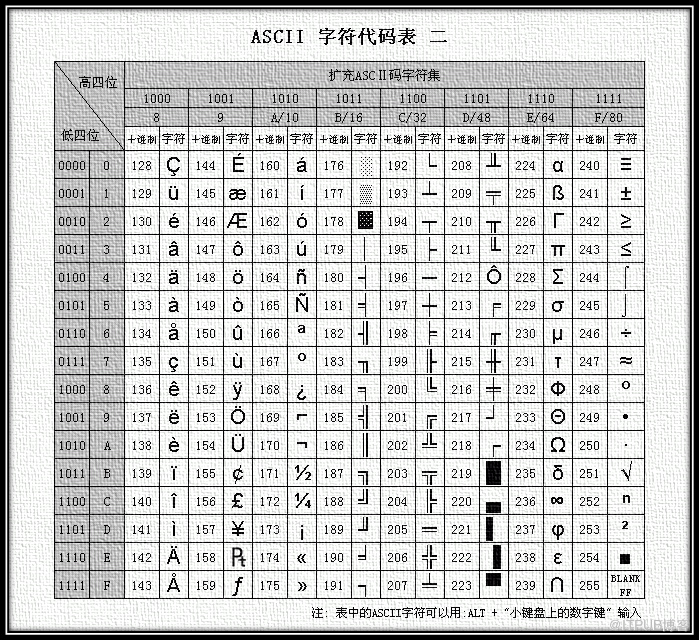
ASCII编码:将ASCII字符集转换为计算机可以接受的数字系统的数的规则。使用7位(bits)表示一个字符,共128字符;但是7位编码的字符集只能支持128个字符,为了表示更多的欧洲常用字符对ASCII进行了扩展,ASCII扩展字符集使用8位(bits)表示一个字符,共256字符。ASCII字符集映射到数字编码规则如下图所示:
2、GBXXXX字符集&编码
2.1 GB2312
GB2312或GB2312-80,是中国国家标准简体中文字符集,全称《信息交换用汉字编码字符集·基本集》,又称GB0,由中国国家标准总局发布,1981年5月1日实施。GB2312编码通行于中国大陆;新加坡等地也采用此编码。中国大陆几乎所有的中文系统和国际化的软件都支持GB2312。GB2312的出现,基本满足了汉字的计算机处理需要,它所收录的6763个汉字和682个其它符号已经覆盖中国大陆99.75%的使用频率。对于人名、古汉语等方面出现的罕用字,GB2312不能处理,这导致了后来GBK及GB 18030汉字字符集的出现。 GB2312保留了编码小于127的ASCII码,但两个大于127的字符编码连在一起时,就表示一个汉字,前面的一个字节(他称之为高字节)从0xA1用到 0xF7,后面一个字节(低字节)从0xA1到0xFE,这样我们就可以组合出大约7000多个简体汉字了。在这些编码里,还把数学符号、罗马希腊的 字母、日文的假名们都编进去了,连在ASCII里本来就有的数字、标点、字母都统统重新编了两个字节长的编码,这就是常说的"全角"字符,而原来在127号以下的那些就叫"半角"字符了。
2.2 GBK
由于GB 2312只收录6763个汉字,有不少汉字,如部分在GB 2312-80推出以后才简化的汉字(如"啰"),部分人名用字(如中国前总理朱镕基的"镕"字),台湾及香港使用的繁体字,日语及朝鲜语汉字等,并未有收录在内。于是厂商微软利用GB 2312-80未使用的编码空间,收录GB 13000.1-93全部字符制定了GBK编码。 虽然GBK收录GB 13000.1-93的全部字符,但编码方式并不相同。GBK自身并非国家标准,只是曾由国家技术监督局标准化司、电子工业部科技与质量监督司公布为"技术规范指导性文件"。原始GB13000一直未被业界采用,后续国家标准GB18030技术上兼容GBK而非GB13000。
2.3 GB 18030
全称:国家标准GB 18030-2005《信息技术 中文编码字符集》,是中华人民共和国现时最新的内码字集,是GB 18030-2000《信息技术 信息交换用汉字编码字符集 基本集的扩充》的修订版。与GB 2312-80完全兼容,与GBK基本兼容,支持GB 13000及Unicode的全部统一汉字,共收录汉字70244个。GB18030主要有以下特点:
与UTF-8相同,采用多字节编码,每个字可以由1个、2个或4个字节组成;编码空间庞大,最多可定义161万个字符;支持中国国内少数民族的文字,不需要动用造字区;汉字收录范围包含繁体汉字以及日韩汉字。
本规格的初版使中华人民共和国信息产业部电子工业标准化研究所起草,由国家质量技术监督局于2000年3月17日发布。现行版本为国家质量监督检验总局和中国国家标准化管理委员会于2005年11月8日发布,2006年5月1日实施。此规格为在中国境内所有软件产品支持的强制规格。
2.4 BIG5
Big5,又称为大五码或五大码,是使用繁体中文(正体中文)社区中最常用的电脑汉字字符集标准,共收录13,060个汉字。中文码分为内码及交换码两类,Big5属中文内码,知名的中文交换码有CCCII、CNS11643。Big5虽普及于台湾、香港与澳门等繁体中文通行区,但长期以来并非当地的国家标准,而只是业界标准。倚天中文系统、Windows等主要系统的字符集都是以Big5为基准,但厂商又各自增加不同的造字与造字区,派生成多种不同版本。2003年,Big5被收录到CNS11643中文标准交换码的附录当中,取得了较正式的地位。这个最新版本被称为Big5-2003。
Big5码是一套双字节字符集,使用了双八码存储方法,以两个字节来安放一个字。第一个字节称为"高位字节",第二个字节称为"低位字节"。"高位字节"使用了0x81-0xFE,"低位字节"使用了0x40-0x7E,及0xA1-0xFE。
3、Unicode编码
Unicode(统一码、万国码、单一码、标准万国码)是业界的一种标准,它可以使电脑得以体现世界上数十种文字的系统。Unicode 是基于通用字符集(Universal Character Set)的标准来发展,并且同时也以书本的形式[1]对外发表。Unicode 还不断在扩增, 每个新版本插入更多新的字符。直至目前为止的第六版,Unicode 就已经包含了超过十万个字符(在2005年,Unicode 的第十万个字符被采纳且认可成为标准之一)、一组可用以作为视觉参考的代码图表、一套编码方法与一组标准字符编码、一套包含了上标字、下标字等字符特性的枚举等。Unicode 组织(The Unicode Consortium)是由一个非营利性的机构所运作,并主导 Unicode 的后续发展,其目标在于:将既有的字符编码方案以Unicode 编码方案来加以取代,特别是既有的方案在多语环境下,皆仅有有限的空间以及不兼容的问题。
4、UCS字符集
通用字符集(Universal Character Set,UCS)是由ISO制定的ISO 10646(或称ISO/IEC 10646)标准所定义的标准字符集。历史上存在两个独立的尝试创立单一字符集的组织,即国际标准化组织(ISO)和多语言软件制造商组成的统一码联盟。前者开发的 ISO/IEC 10646 项目,后者开发的统一码项目。因此最初制定了不同的标准。1991年前后,两个项目的参与者都认识到,世界不需要两个不兼容的字符集。于是,它们开始合并双方的工作成果,并为创立一个单一编码表而协同工作。从Unicode 2.0开始,Unicode采用了与ISO 10646-1相同的字库和字码;ISO也承诺,ISO 10646将不会替超出U+10FFFF的UCS-4编码赋值,以使得两者保持一致。两个项目仍都存在,并独立地公布各自的标准。但统一码联盟和ISO/IEC JTC1/SC2都同意保持两者标准的码表兼容,并紧密地共同调整任何未来的扩展。在发布的时候,Unicode一般都会采用有关字码最常见的字型,但ISO 10646一般都尽可能采用Century字型。
5、UTF编码
UTF-32/ UTF-16/ UTF-8是Unicode编码的三种方案。
5.1 UTF-32 用4字节的数字来表达每个字母、符号,或者表意文字(ideograph),每个数字代表唯一的至少在某种语言中使用的符号的编码方案,称为UTF-32。UTF-32又称UCS-4是一种将Unicode字符编码的协定,对每个字符都使用4字节。
5.2 UTF-16 如果字符编码U小于0x10000,也就是经常用到的0~65535之间的字符,则直接使用两字节表示;超过此范围的0x10000到0x10FFFF,则需要4个字节来表示这些编码。
5.3 UTF-8 使用一至四个字节为每个字符编码:128个US-ASCII字符只需一个字节编码(Unicode范围由U+0000至U+007F),带有附加符号的拉丁文、希腊文、西里尔字母、亚美尼亚语、希伯来文、阿拉伯文、叙利亚文及它拿字母则需要二个字节编码(Unicode范围由U+0080至U+07FF)。
其他基本多文种平面(BMP)中的字符(这包含了大部分常用字)使用三个字节编码。其他极少使用的Unicode辅助平面的字符使用四字节编码。
举例:不同字符集之间的编码
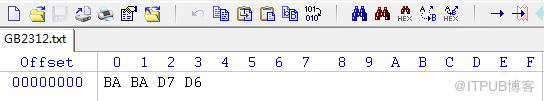
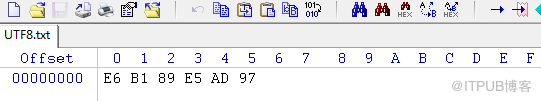
上图为“汉字”在三种不同的字符集下对应的编码,当字符集为GB2312时,编码BABA 表示 “汉” 这个字, 若到其他编码规则中去查找编码BABA对应的字符时,就可能会出现乱码。所以要准确地解读编码,两者间字符编码必须要相同或进行转换。从上面可以得知:
1、以某字符集存储字符时,它会在该字符集中搜索这个字符的编码,把这个编码保存在计算机中,如果所搜找不到该字符对应的编码,一定会出错。
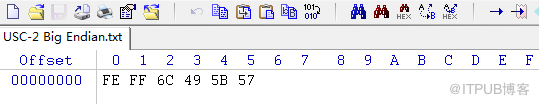
2、当需要显示字符时,用记事本为例,记事本先判断是该用哪种字符集来读取解析文本字符:记事本打开一个TXT,若发现有头标签,就用unicode编码。头标签叫BOM,如果是0xFF 0xFE,是UTF16LE,如果是0xFE 0xFF则UTF16BE,如果是0xEF 0xBB 0xBF,则是UTF-8。如果没有这三个东西,那么就用ANSI(即记事本的默认编码字符集),即使用操作系统的默认语言编码来解释。如果搜索到就正常显示,搜索不到就会显示乱码。
什么是字符集(charset)? 字符集是一个系统支持的所有抽象字符的集合。
什么是字符编码(Character Encoding)? 字符编码是指字符集中的字符以何种二进制进行储存。计算机中只保存该字符在某字符集中对应的字符编码。解码时必需使用相同的解码规则,如果使用了错误的解码规则,就会出现乱码。常见编码:ASCII、GB2312、BIG5、GB18030、Unicode等。
1、ASCII字符集&编码
ASCII(American Standard Code for Information Interchange,美国信息交换标准代码,由ANSI制定)是基于拉丁字母的一套电脑编码系统。它主要用于显示现代英语,而其扩展版本EASCII则可以勉强显示其他西欧语言。它是现今最通用的单字节编码系统(但是有被Unicode追上的迹象),并等同于国际标准ISO/IEC 646。
ASCII字符集:主要包括控制字符(回车键、退格、换行键等);可显示字符(英文大小写字符、阿拉伯数字和西文符号)。
ASCII编码:将ASCII字符集转换为计算机可以接受的数字系统的数的规则。使用7位(bits)表示一个字符,共128字符;但是7位编码的字符集只能支持128个字符,为了表示更多的欧洲常用字符对ASCII进行了扩展,ASCII扩展字符集使用8位(bits)表示一个字符,共256字符。ASCII字符集映射到数字编码规则如下图所示:
2、GBXXXX字符集&编码
2.1 GB2312
GB2312或GB2312-80,是中国国家标准简体中文字符集,全称《信息交换用汉字编码字符集·基本集》,又称GB0,由中国国家标准总局发布,1981年5月1日实施。GB2312编码通行于中国大陆;新加坡等地也采用此编码。中国大陆几乎所有的中文系统和国际化的软件都支持GB2312。GB2312的出现,基本满足了汉字的计算机处理需要,它所收录的6763个汉字和682个其它符号已经覆盖中国大陆99.75%的使用频率。对于人名、古汉语等方面出现的罕用字,GB2312不能处理,这导致了后来GBK及GB 18030汉字字符集的出现。 GB2312保留了编码小于127的ASCII码,但两个大于127的字符编码连在一起时,就表示一个汉字,前面的一个字节(他称之为高字节)从0xA1用到 0xF7,后面一个字节(低字节)从0xA1到0xFE,这样我们就可以组合出大约7000多个简体汉字了。在这些编码里,还把数学符号、罗马希腊的 字母、日文的假名们都编进去了,连在ASCII里本来就有的数字、标点、字母都统统重新编了两个字节长的编码,这就是常说的"全角"字符,而原来在127号以下的那些就叫"半角"字符了。
2.2 GBK
由于GB 2312只收录6763个汉字,有不少汉字,如部分在GB 2312-80推出以后才简化的汉字(如"啰"),部分人名用字(如中国前总理朱镕基的"镕"字),台湾及香港使用的繁体字,日语及朝鲜语汉字等,并未有收录在内。于是厂商微软利用GB 2312-80未使用的编码空间,收录GB 13000.1-93全部字符制定了GBK编码。 虽然GBK收录GB 13000.1-93的全部字符,但编码方式并不相同。GBK自身并非国家标准,只是曾由国家技术监督局标准化司、电子工业部科技与质量监督司公布为"技术规范指导性文件"。原始GB13000一直未被业界采用,后续国家标准GB18030技术上兼容GBK而非GB13000。
2.3 GB 18030
全称:国家标准GB 18030-2005《信息技术 中文编码字符集》,是中华人民共和国现时最新的内码字集,是GB 18030-2000《信息技术 信息交换用汉字编码字符集 基本集的扩充》的修订版。与GB 2312-80完全兼容,与GBK基本兼容,支持GB 13000及Unicode的全部统一汉字,共收录汉字70244个。GB18030主要有以下特点:
与UTF-8相同,采用多字节编码,每个字可以由1个、2个或4个字节组成;编码空间庞大,最多可定义161万个字符;支持中国国内少数民族的文字,不需要动用造字区;汉字收录范围包含繁体汉字以及日韩汉字。
本规格的初版使中华人民共和国信息产业部电子工业标准化研究所起草,由国家质量技术监督局于2000年3月17日发布。现行版本为国家质量监督检验总局和中国国家标准化管理委员会于2005年11月8日发布,2006年5月1日实施。此规格为在中国境内所有软件产品支持的强制规格。
2.4 BIG5
Big5,又称为大五码或五大码,是使用繁体中文(正体中文)社区中最常用的电脑汉字字符集标准,共收录13,060个汉字。中文码分为内码及交换码两类,Big5属中文内码,知名的中文交换码有CCCII、CNS11643。Big5虽普及于台湾、香港与澳门等繁体中文通行区,但长期以来并非当地的国家标准,而只是业界标准。倚天中文系统、Windows等主要系统的字符集都是以Big5为基准,但厂商又各自增加不同的造字与造字区,派生成多种不同版本。2003年,Big5被收录到CNS11643中文标准交换码的附录当中,取得了较正式的地位。这个最新版本被称为Big5-2003。
Big5码是一套双字节字符集,使用了双八码存储方法,以两个字节来安放一个字。第一个字节称为"高位字节",第二个字节称为"低位字节"。"高位字节"使用了0x81-0xFE,"低位字节"使用了0x40-0x7E,及0xA1-0xFE。
3、Unicode编码
Unicode(统一码、万国码、单一码、标准万国码)是业界的一种标准,它可以使电脑得以体现世界上数十种文字的系统。Unicode 是基于通用字符集(Universal Character Set)的标准来发展,并且同时也以书本的形式[1]对外发表。Unicode 还不断在扩增, 每个新版本插入更多新的字符。直至目前为止的第六版,Unicode 就已经包含了超过十万个字符(在2005年,Unicode 的第十万个字符被采纳且认可成为标准之一)、一组可用以作为视觉参考的代码图表、一套编码方法与一组标准字符编码、一套包含了上标字、下标字等字符特性的枚举等。Unicode 组织(The Unicode Consortium)是由一个非营利性的机构所运作,并主导 Unicode 的后续发展,其目标在于:将既有的字符编码方案以Unicode 编码方案来加以取代,特别是既有的方案在多语环境下,皆仅有有限的空间以及不兼容的问题。
4、UCS字符集
通用字符集(Universal Character Set,UCS)是由ISO制定的ISO 10646(或称ISO/IEC 10646)标准所定义的标准字符集。历史上存在两个独立的尝试创立单一字符集的组织,即国际标准化组织(ISO)和多语言软件制造商组成的统一码联盟。前者开发的 ISO/IEC 10646 项目,后者开发的统一码项目。因此最初制定了不同的标准。1991年前后,两个项目的参与者都认识到,世界不需要两个不兼容的字符集。于是,它们开始合并双方的工作成果,并为创立一个单一编码表而协同工作。从Unicode 2.0开始,Unicode采用了与ISO 10646-1相同的字库和字码;ISO也承诺,ISO 10646将不会替超出U+10FFFF的UCS-4编码赋值,以使得两者保持一致。两个项目仍都存在,并独立地公布各自的标准。但统一码联盟和ISO/IEC JTC1/SC2都同意保持两者标准的码表兼容,并紧密地共同调整任何未来的扩展。在发布的时候,Unicode一般都会采用有关字码最常见的字型,但ISO 10646一般都尽可能采用Century字型。
5、UTF编码
UTF-32/ UTF-16/ UTF-8是Unicode编码的三种方案。
5.1 UTF-32 用4字节的数字来表达每个字母、符号,或者表意文字(ideograph),每个数字代表唯一的至少在某种语言中使用的符号的编码方案,称为UTF-32。UTF-32又称UCS-4是一种将Unicode字符编码的协定,对每个字符都使用4字节。
5.2 UTF-16 如果字符编码U小于0x10000,也就是经常用到的0~65535之间的字符,则直接使用两字节表示;超过此范围的0x10000到0x10FFFF,则需要4个字节来表示这些编码。
5.3 UTF-8 使用一至四个字节为每个字符编码:128个US-ASCII字符只需一个字节编码(Unicode范围由U+0000至U+007F),带有附加符号的拉丁文、希腊文、西里尔字母、亚美尼亚语、希伯来文、阿拉伯文、叙利亚文及它拿字母则需要二个字节编码(Unicode范围由U+0080至U+07FF)。
其他基本多文种平面(BMP)中的字符(这包含了大部分常用字)使用三个字节编码。其他极少使用的Unicode辅助平面的字符使用四字节编码。
举例:不同字符集之间的编码
上图为“汉字”在三种不同的字符集下对应的编码,当字符集为GB2312时,编码BABA 表示 “汉” 这个字, 若到其他编码规则中去查找编码BABA对应的字符时,就可能会出现乱码。所以要准确地解读编码,两者间字符编码必须要相同或进行转换。从上面可以得知:
1、以某字符集存储字符时,它会在该字符集中搜索这个字符的编码,把这个编码保存在计算机中,如果所搜找不到该字符对应的编码,一定会出错。
2、当需要显示字符时,用记事本为例,记事本先判断是该用哪种字符集来读取解析文本字符:记事本打开一个TXT,若发现有头标签,就用unicode编码。头标签叫BOM,如果是0xFF 0xFE,是UTF16LE,如果是0xFE 0xFF则UTF16BE,如果是0xEF 0xBB 0xBF,则是UTF-8。如果没有这三个东西,那么就用ANSI(即记事本的默认编码字符集),即使用操作系统的默认语言编码来解释。如果搜索到就正常显示,搜索不到就会显示乱码。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29626120/viewspace-1709341/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
YUM源配置
下一篇:
没有了~

请登录后发表评论
登录
全部评论
