换个角度看Aurora:缘何“万能”?对比TiDB有何不同?
http://www.yunweipai.com/archives/24367.html
主要内容介绍了Aurora知识,并与TiDB进行了对比;
节选内容如下:
Aurora vs TiDB(Spanner&F1)
回顾数据库的发展历史,我们可以简单分成三个阶段,从上实际 70 年代 E.F. Codd 提出关系模型到本世纪初,基本上是以单机关系型数据库为主,如 Oracle、MySQL、PostgreSQL,但随着互联网搜索、社交的发展、数据量爆发增长,传统数据库高成本,无法线性扩展问题日益凸显,分布式 NoSQL 快速发展,如 HBase、MongoDB,近几年来,大家发现很多的业务并没有办法直接使用 NoSQL 的模型,应用需要很复杂的开发才能实现 SQL 和事务能很简单实现的功能,所以新一轮的数据库开始了 SQL 回归,这种可扩展、高性能、支持 SQL 和事务的数据库被大家泛称为 NewSQL。
NewSQL 又分为不同的方向,除了本文提到的云计算 RDS,还有分布式关系数据库,其中的代表产品如谷歌的 Spanner&F1,还有国内人气厂商 PingCAP 的 TiDB,TiDB 具有支持 SQL、水平弹性扩展、数据强一致性的高可用等特性,篇幅限制,这里不展开,详情可参考 TiDB 的官方文档 (https://pingcap.com)。
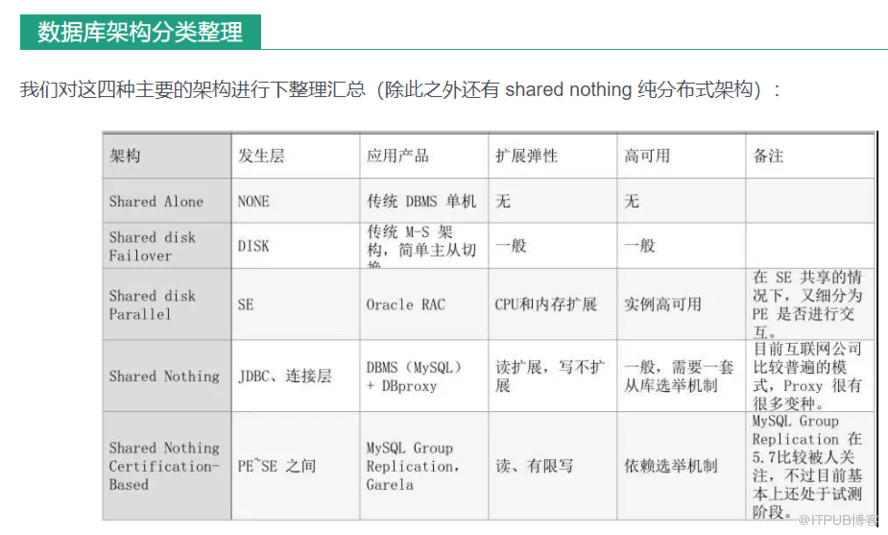
虽然 Aurora、TiDB 是两个不同方向的产物,但作为两个引领潮流的数据库产品,笔者按照体系结构、数据格式、存储引擎、容量能力、扩展性、兼容性、移植性、灵活性、读写性能、内存机制、异地多活等若干维度进行下对比:
Aurora
架构:属于 Shared disk 架构(存储可以简单理解为共享,实际上是一套多副本复制存储)。
存储:数据格式属于传统的表结构(InnoDB 引擎)。
写扩展:单点写入,系统写入性能有上限(虽然正在计划中的 Multimaster 理论上也会提升写吞吐,但是仍然受限于实例之间的内存交互及存储之间的 Apply log),从写流量看不属于真正的 Scale out。
读扩展:实例可弹性扩展。
大小限制:数据大小上限 64 T。
读写响应:大大简化 commit 的机制,读写响应时间很好。
兼容性:由于实例层本身就源于 MySQL,所以对 MySQL 兼容性好(100%)。
移植性:移植性很差,它依赖 AWS 很多组件,尤其是底层的共享存储系统,所以基本不具有移植性,它定位就是一套云环境下 RDS。
灵活性:架构可改造性很差。
内存交互:日志会在实例节点 Buffer 之间进行复制应用,通过这种“内存交互”方式读性能会更优。
事务性能:不存在 2 PC 及写扩大的问题,写入性能上更优。
高可用:不是强一致机制,极端情况下通过其它节点可能读不到最新的数据。
节点状态:实例分主次,只能通过从库选举方式来进行实例层的高可用。
适合场景:主要解决的 OLTP 场景,它的优化器和 MySQL 一样,不是为分布式系统设计。目前还不支持Hashjoin 、并行等技术(从2017 AWS Re:Invent 最新消息看,后面会逐步支持,包括 Pushdown query),但综合比较看仍不适合 OLAP 分析场景。
开源状态:商业数据库。
TiDB
架构:属于 Shared nothing 的分布式架构,他通过 Raft 协议进 同步,实现每个 Raft group 内的数据强一致性。
存储:数据格式是 KV,数据模型是基于 LSMTree 的模型,底层(Rocksdb)。
写扩展:写入分布式写入,线性扩展,写入容量理论上限很高,LSM 写入性能更好。
读扩展:存储节点、实例节点都可进行线性扩展(读写扩展),属于典型的 Scale out。
大小限制:理论无上限。
读写响应:两阶段提交、Raft 复制对响应时间都会有一定延迟成本。
兼容性:高兼容 MySQL 连接协议,但和 Aurora 比,不支持存储过程,触发器,兼容性略差。
移植性:具有很好的移植性,支持多种部署方式,可以在公有云、私有云、私有环境下快速搭建。
灵活性:实例层、存储层拆分的很清晰,独立,可在 TiKV 上直接调研 API 、或者部署诸如 Tispark 完成架构的灵活多样性。
内存交互:实例节点 Buffer 不存在交互机制,不能共享内存。
事务性能:分布式事务锁机制,写入性能,尤其是冲突比较多写入场景性能较差。
高可用:只要网络条件允许,可以创建真正意义的异地多活分布式数据库。
节点状态:实例层无状态,实例层的高可用更胜一筹。
适合场景:首先解决了 OLTP 场景,同时通过 Tispark 可以比较好的支持 OLAP 场景,而且由于共用一份 TiKV 集群或者实时同步机制,能实现实时分析场景。
开源状态:开源数据库,社区活跃。
对比总结
两个产品作为 NewSQL 的两个方向,都属于跨时代的产品,也都有很多令人激动的 Feature,他们用各自的方式提升、扩展了数据库的写入容量,都是替换 Sharding + Proxy 很好的方案,Sharding + Proxy 虽然是目前主流方案,但它存在很多问题,具体可关注笔者近期将发布的另一篇文章《数据库 Sharding +Proxy 方案成本汇总》。
Aurora 在内存一致性、读写性能、MySQL 兼容性、事务限制、内存管理、Cash recovery 等方面优于 TiDB。但反过来 TiDB 在弹性扩展、架构的解耦性、灵活性、场景覆盖等方面更胜一筹,更重要的是 TiDB 移植性很好,笔者觉得这点会成为两类产品普及度一个很重要的因素,同时 TiDB是可以真正实现跨区域的异地多活的分布式数据库。
总结
云计算的发展为存储分离的提供了更多可能,也加速了这种趋势,传统关系型数据库需要在单机层面花费了昂贵的成本去实现 ACID,这样导致单机的容量非常有限,以 MySQL 为例,M-S 的架构虽然解决了读流量的扩展问题,但写流量成了最大的瓶颈(虽然有各种 Sharding、多主等方案,但本质上并未解决写流量扩展问题),Aurora 依托自身的云产品,把数据库这个盒子打开进行抽茧剥丝,通过把写入、恢复等昂贵操作下沉到存储服务中的方式,很大程度了提升了集群的写入容量,粗略估计可能会提升一个数量级,在这个容量范围内的 OLTP 业务覆盖量还是非常大的,但反过来说,这种架构本质上还是单节点写入,而且从目前看上去 Aurora 在实例层改动很少,这么看上去有点小马拉大车的感觉,笔者把它理解为变向的Scale up。同时,Aurora 在自动拓展存储容量、自动修复数据、闪崩恢复、将缓存从实例中分离持久化进而解决了热数据问题上都是值得借鉴的很好创新。Aurora 可以说是在云环境下(AWS)量身定做的产物,它所依赖的共享存储,不是简单的共享,而是一个包含计算,能自动复制的共享存储服务系统,但这一点就就很难进行复制。
最后,不管是计算与存储分离的云数据库,还是分布式数据库,NewSQL 的时代已经来临。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29519108/viewspace-2220499/ ,如需转载,请注明出处,否则将追究法律责任。

