单位日志,需要每天过滤之后上传到Hadoop,然后通过Hive分析.
日志大致格式如下
2016-01-11 10:00:03,114.112.124.236,57280,10,1,-24576,vvlive,1.0.0.1026,6941c526245a6ec26ed5a4b32e1b2d72,avcore,3,401,21502,roomid=941404583 svr=122.226.185.23 port=8009 devicetype=1 channelid=2034 time=30750 totalsend=849 lostsend=0 uniqsend=849 uniq lost=0 reqlost=0 dropreqlost=0 totalsendbytes=423261 lostsendbytes=0 uniqsendbytes=423261 peerrtt=93 droprate=0.0000 rate=400 originalrate=400
2016-01-11 10:00:09,114.112.124.236,52999,10,1,11776,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,vvlive_user,3,5,705497093,705497093+0%+2%+2012/07/29 06:39:25
2016-01-11 10:00:11,114.112.124.236,52999,10,1,12032,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,avcore,3,405,705497093,roomid=909578532 svr=122.226.185.23 port=8009 devicetype=1 channel=2042 time=60000 recvcucpackets=0 detectlostpackets=0 reqlostp acketsucccount=0 duppackets=0 reqlostpackets=0 lostnotify=0 lostrate=-1.0000 reqlostrate=-1.0000
2016-01-11 10:00:11,114.112.124.236,52999,10,1,12032,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,avcore,3,405,705497093,roomid=909578532 svr=122.226.185.23 port=8009 devicetype=0 channel=2041 time=60000 recvcucpackets=0 detectlostpackets=0 reqlostp acketsucccount=0 duppackets=0 reqlostpackets=0 lostnotify=0 lostrate=-1.0000 reqlostrate=-1.0000
前面的字段都是固定的,但是最后一个字段是无模式的.
这些日志需要先做过滤,然后抽取其中几个字段包括那个无模式的列.
进入日志目录,

使用如下命令格式化日志
grep avcore,3, *.dat | sed 's/^.*dat://g' | sed 's/=/\o003/g' | awk -F',' '{printf("%s\001%s\001%s\001%s\001%s\001%s\001%s\n",$1,$8,$9,$10,$12,$13,$14)}' | sed 's/\t/\o002/g' > /data/statsvr/tmp/vvlive_$(date +%y%m%d).txt
作用:
sed 's/^.*dat://g'
grep 所有的dat文件,匹配的文件名称会显示出来,这个sed删除冒号之前的信息.
sed 's/=/\o003/g'
最后一列都是无模式的,所以映射为hive的Map格式。这个sed将日志中的等于号,替换为Hive Map中键值的分隔符,(默认八进制编码的\003表示)
awk -F',' '{printf("%s\001%s\001%s\001%s\001%s\001%s\001%s\n",$1,$8,$9,$10,$12,$13,$14)}'
AWK提取需要的字段,中间用hive字段分隔符隔离(hive字段间的分隔符默认是八进制的\001)
sed 's/\t/\o002/g'
\002默认是hive Map 键值对之间的默认分隔符.
规范化之后的日志:
在hive上建表.
最后将规范化的日志上传到hdfs即可.
hadoop fs -put vvlive_160113.txt /avcore_live/vvlive/
在hive查看信息.
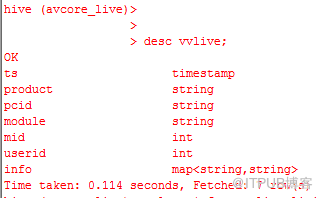
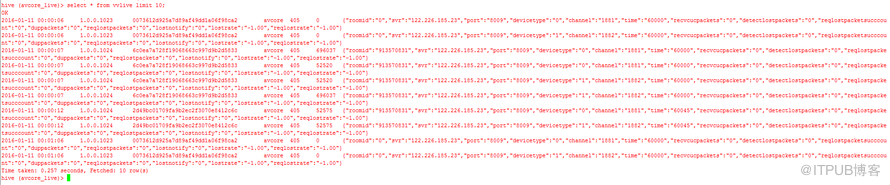
日志大致格式如下
2016-01-11 10:00:03,114.112.124.236,57280,10,1,-24576,vvlive,1.0.0.1026,6941c526245a6ec26ed5a4b32e1b2d72,avcore,3,401,21502,roomid=941404583 svr=122.226.185.23 port=8009 devicetype=1 channelid=2034 time=30750 totalsend=849 lostsend=0 uniqsend=849 uniq lost=0 reqlost=0 dropreqlost=0 totalsendbytes=423261 lostsendbytes=0 uniqsendbytes=423261 peerrtt=93 droprate=0.0000 rate=400 originalrate=400
2016-01-11 10:00:09,114.112.124.236,52999,10,1,11776,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,vvlive_user,3,5,705497093,705497093+0%+2%+2012/07/29 06:39:25
2016-01-11 10:00:11,114.112.124.236,52999,10,1,12032,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,avcore,3,405,705497093,roomid=909578532 svr=122.226.185.23 port=8009 devicetype=1 channel=2042 time=60000 recvcucpackets=0 detectlostpackets=0 reqlostp acketsucccount=0 duppackets=0 reqlostpackets=0 lostnotify=0 lostrate=-1.0000 reqlostrate=-1.0000
2016-01-11 10:00:11,114.112.124.236,52999,10,1,12032,vvlive,1.0.0.1026,9b09c9011d102407670b4a3b8b0694f6,avcore,3,405,705497093,roomid=909578532 svr=122.226.185.23 port=8009 devicetype=0 channel=2041 time=60000 recvcucpackets=0 detectlostpackets=0 reqlostp acketsucccount=0 duppackets=0 reqlostpackets=0 lostnotify=0 lostrate=-1.0000 reqlostrate=-1.0000
前面的字段都是固定的,但是最后一个字段是无模式的.
这些日志需要先做过滤,然后抽取其中几个字段包括那个无模式的列.
进入日志目录,

使用如下命令格式化日志
grep avcore,3, *.dat | sed 's/^.*dat://g' | sed 's/=/\o003/g' | awk -F',' '{printf("%s\001%s\001%s\001%s\001%s\001%s\001%s\n",$1,$8,$9,$10,$12,$13,$14)}' | sed 's/\t/\o002/g' > /data/statsvr/tmp/vvlive_$(date +%y%m%d).txt
作用:
sed 's/^.*dat://g'
grep 所有的dat文件,匹配的文件名称会显示出来,这个sed删除冒号之前的信息.
sed 's/=/\o003/g'
最后一列都是无模式的,所以映射为hive的Map格式。这个sed将日志中的等于号,替换为Hive Map中键值的分隔符,(默认八进制编码的\003表示)
awk -F',' '{printf("%s\001%s\001%s\001%s\001%s\001%s\001%s\n",$1,$8,$9,$10,$12,$13,$14)}'
AWK提取需要的字段,中间用hive字段分隔符隔离(hive字段间的分隔符默认是八进制的\001)
sed 's/\t/\o002/g'
\002默认是hive Map 键值对之间的默认分隔符.
规范化之后的日志:
- 2016-01-11 00:00:06^A1.0.0.1023^A0073612d925a7d89af49dd1a06f98ca2^Aavcore^A405^A0^Aroomid^C0^Bsvr^C122.226.185.23^Bport^C8009^Bdevicetype^C0^Bchannel^C1881^Btime^C60000^Brecvcucpackets^C0^Bdetectlostpackets^C0^Breqlostpacketsucccount^C0^Bduppackets^C0^Breqlostpackets^ C0^Blostnotify^C0^Blostrate^C-1.00^Breqlostrate^C-1.00
- 2016-01-11 00:00:06^A1.0.0.1023^A0073612d925a7d89af49dd1a06f98ca2^Aavcore^A405^A0^Aroomid^C0^Bsvr^C122.226.185.23^Bport^C8009^Bdevicetype^C1^Bchannel^C1882^Btime^C60000^Brecvcucpackets^C0^Bdetectlostpackets^C0^Breqlostpacketsucccount^C0^Bduppackets^C0^Breqlostpackets^ C0^Blostnotify^C0^Blostrate^C-1.00^Breqlostrate^C-1.00
- 2016-01-11 00:00:07^A1.0.0.1024^A6c0ea7a728f19068663c997d9b2d5833^Aavcore^A405^A696037^Aroomid^C913570831^Bsvr^C122.226.185.23^Bport^C8009^Bdevicetype^C0^Bchannel^C1881^Btime^C60000^Brecvcucpackets^C0^Bdetectlostpackets^C0^Breqlostpacketsucccount^C0^Bduppackets^C0^Bre qlostpackets^C0^Blostnotify^C0^Blostrate^C-1.00^Breqlostrate^C-1.00
在hive上建表.
- create external table vvlive
- (
- ts TIMESTAMP,
- product STRING,
- pcid STRING,
- module STRING,
- mid INT,
- userid INT,
- info Map<STRING,STRING>
- )
- row format delimited
- fields terminated by '\001'
- collection items terminated by '\002'
- map keys terminated by '\003'
- lines terminated by '\n'
- location '/avcore_live/vvlive';
最后将规范化的日志上传到hdfs即可.
hadoop fs -put vvlive_160113.txt /avcore_live/vvlive/
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29254281/viewspace-1976121/ ,如需转载,请注明出处,否则将追究法律责任。
上一篇:
小花狸MyBatis慢查询监控插件
下一篇:
gitbook和Markdown

请登录后发表评论
登录
全部评论
