-
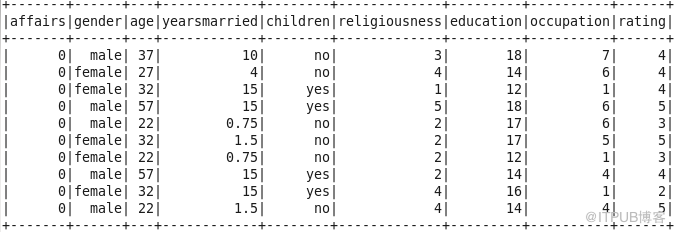
// affairs:一年来婚外情的频率
-
// gender:性别
-
// age:年龄
-
// yearsmarried:婚龄
-
// children:是否有小孩
-
// religiousness:宗教信仰程度(5分制,1分表示反对,5分表示非常信仰)
-
// education:学历
-
// occupation:职业(逆向编号的戈登7种分类)
-
// rating:对婚姻的自我评分(5分制,1表示非常不幸福,5表示非常幸福)
-
-
import org.apache.spark.sql.SparkSession
-
import org.apache.spark.sql.Dataset
-
import org.apache.spark.sql.Row
-
import org.apache.spark.sql.DataFrame
-
import org.apache.spark.sql.Column
-
import org.apache.spark.sql.DataFrameReader
-
import org.apache.spark.rdd.RDD
-
import org.apache.spark.sql.catalyst.encoders.ExpressionEncoder
-
import org.apache.spark.sql.Encoder
-
import org.apache.spark.ml.linalg.Vectors
-
import org.apache.spark.ml.feature.StringIndexer
-
import org.apache.spark.ml.feature.OneHotEncoder
-
import org.apache.spark.ml.feature.VectorAssembler
-
import org.apache.spark.ml.feature.StandardScaler
-
import org.apache.spark.ml.feature.PCA
-
import org.apache.spark.ml.clustering.KMeans
-
-
scala> val spark = SparkSession.builder().appName("Spark SQL basic example").config("spark.some.config.option", "some-value").getOrCreate()
-
-
scala>
-
-
scala> // For implicit conversions like converting RDDs to DataFrames
-
scala> import spark.implicits._
-
-
-
scala> val data: DataFrame = spark.read.format("csv").option("header", true).load("hdfs://ns1/datafile/wangxiao/Affairs.csv")
-
data: org.apache.spark.sql.DataFrame = [affairs: string, gender: string ... 7 more fields]
-
-
scala>
-
-
scala> data.cache
-
res0: data.type = [affairs: string, gender: string ... 7 more fields]
-
-
scala>
-
-
scala> data.limit(10).show()
-
-
-
-
-
-
scala>
-
-
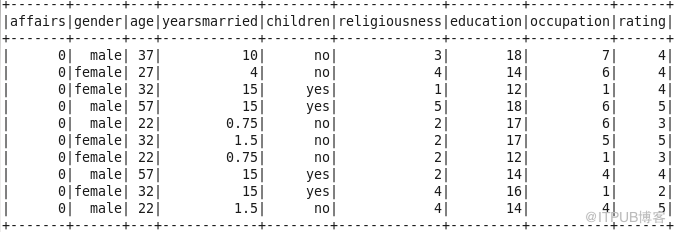
scala> // 转换字符类型,将Double和String的字段分开放
-
-
scala> val data1 = data.select(
-
| data("affairs").cast("Double"),
-
| data("age").cast("Double"),
-
| data("yearsmarried").cast("Double"),
-
| data("religiousness").cast("Double"),
-
| data("education").cast("Double"),
-
| data("occupation").cast("Double"),
-
| data("rating").cast("Double"),
-
| data("gender").cast("String"),
-
| data("children").cast("String"))
-
data1: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 7 more fields]
-
-
scala>
-
-
scala> data1.printSchema()
-
root
-
|-- affairs: double (nullable = true)
-
|-- age: double (nullable = true)
-
|-- yearsmarried: double (nullable = true)
-
|-- religiousness: double (nullable = true)
-
|-- education: double (nullable = true)
-
|-- occupation: double (nullable = true)
-
|-- rating: double (nullable = true)
-
|-- gender: string (nullable = true)
-
|-- children: string (nullable = true)
-
-
-
scala> data1.limit(10).show
-
-
-
-
-
scala>
-
-
scala> val dataDF = data1
-
dataDF: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 7 more fields]
-
-
scala>
-
-
scala> dataDF.cache()
-
res4: dataDF.type = [affairs: double, age: double ... 7 more fields]
-
-
scala>
-
-
scala> //###################################
-
-
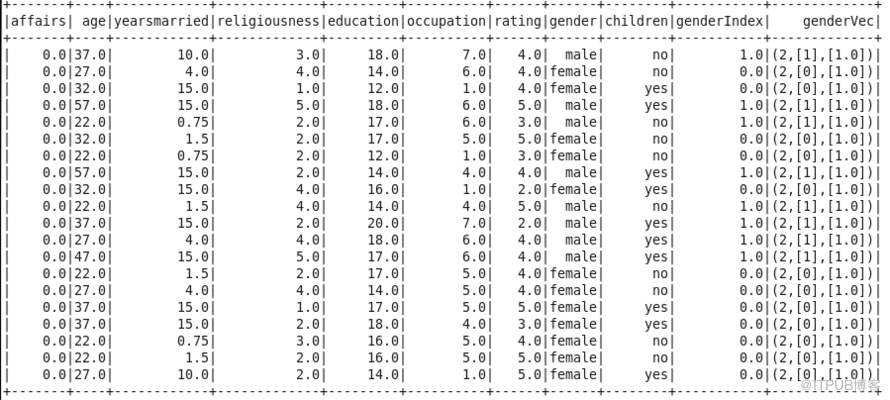
scala> val indexer = new StringIndexer().setInputCol("gender").setOutputCol("genderIndex").fit(dataDF)
-
indexer: org.apache.spark.ml.feature.StringIndexerModel = strIdx_19a888aff882
-
-
scala> val indexed = indexer.transform(dataDF)
-
indexed: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 8 more fields]
-
-
scala> // OneHot编码,注意setDropLast设置为false
-
-
scala> val encoder = new OneHotEncoder().setInputCol("genderIndex").setOutputCol("genderVec").setDropLast(false)
-
encoder: org.apache.spark.ml.feature.OneHotEncoder = oneHot_f0f47e0b5b37
-
-
scala> val encoded = encoder.transform(indexed)
-
encoded: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 9 more fields]
-
-
scala> encoded.show()
-
-
-
-
scala>
-
-
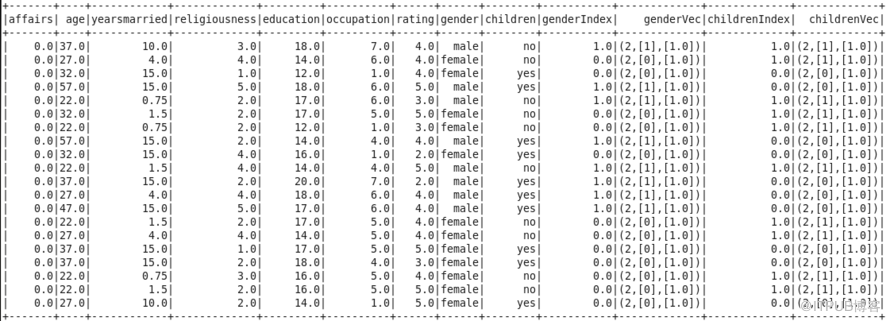
scala> val indexer1 = new StringIndexer().setInputCol("children").setOutputCol("childrenIndex").fit(encoded)
-
indexer1: org.apache.spark.ml.feature.StringIndexerModel = strIdx_7e4d8c69b823
-
-
scala> val indexed1 = indexer1.transform(encoded)
-
indexed1: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 10 more fields]
-
-
scala> val encoder1 = new OneHotEncoder().setInputCol("childrenIndex").setOutputCol("childrenVec").setDropLast(false)
-
encoder1: org.apache.spark.ml.feature.OneHotEncoder = oneHot_9a8906781325
-
-
scala> val encoded1 = encoder1.transform(indexed1)
-
encoded1: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 11 more fields]
-
-
scala> encoded1.show()
-
-
-
-
scala>
-
-
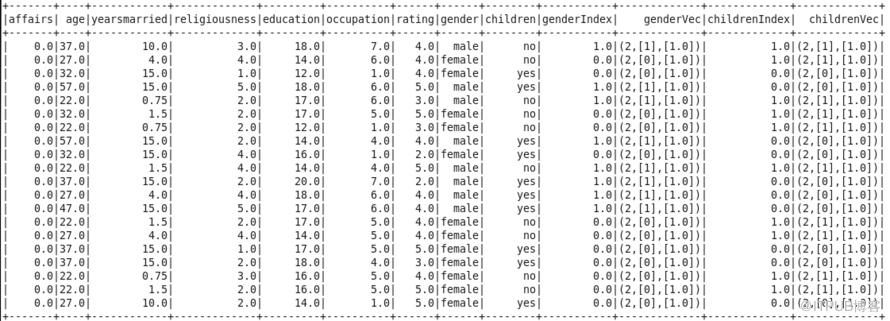
scala> val encodeDF: DataFrame = encoded1
-
encodeDF: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 11 more fields]
-
-
scala> encodeDF.show()
-
-
-
-
scala> encodeDF.printSchema()
-
root
-
|-- affairs: double (nullable = true)
-
|-- age: double (nullable = true)
-
|-- yearsmarried: double (nullable = true)
-
|-- religiousness: double (nullable = true)
-
|-- education: double (nullable = true)
-
|-- occupation: double (nullable = true)
-
|-- rating: double (nullable = true)
-
|-- gender: string (nullable = true)
-
|-- children: string (nullable = true)
-
|-- genderIndex: double (nullable = true)
-
|-- genderVec: vector (nullable = true)
-
|-- childrenIndex: double (nullable = true)
-
|-- childrenVec: vector (nullable = true)
-
-
-
scala>
-
-
scala> //#################################
-
-
scala> val assembler = new VectorAssembler().setInputCols(Array("affairs", "age", "yearsmarried", "religiousness", "education", "occupation", "rating", "genderVec", "childrenVec")).setOutputCol("features")
-
assembler: org.apache.spark.ml.feature.VectorAssembler = vecAssembler_8ccd528981cd
-
-
scala>
-
-
scala> val vecDF: DataFrame = assembler.transform(encodeDF)
-
vecDF: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 12 more fields]
-
-
scala> vecDF.select("features").show
-
16/11/05 15:56:14 WARN Executor: 1 block locks were not released by TID = 11:
-
[rdd_17_0]
-
+--------------------+
-
| features|
-
+--------------------+
-
|[0.0,37.0,10.0,3....|
-
|[0.0,27.0,4.0,4.0...|
-
|[0.0,32.0,15.0,1....|
-
|[0.0,57.0,15.0,5....|
-
|[0.0,22.0,0.75,2....|
-
|[0.0,32.0,1.5,2.0...|
-
|[0.0,22.0,0.75,2....|
-
|[0.0,57.0,15.0,2....|
-
|[0.0,32.0,15.0,4....|
-
|[0.0,22.0,1.5,4.0...|
-
|[0.0,37.0,15.0,2....|
-
|[0.0,27.0,4.0,4.0...|
-
|[0.0,47.0,15.0,5....|
-
|[0.0,22.0,1.5,2.0...|
-
|[0.0,27.0,4.0,4.0...|
-
|[0.0,37.0,15.0,1....|
-
|[0.0,37.0,15.0,2....|
-
|[0.0,22.0,0.75,3....|
-
|[0.0,22.0,1.5,2.0...|
-
|[0.0,27.0,10.0,2....|
-
+--------------------+
-
only showing top 20 rows
-
-
-
scala>
-
-
scala> // 标准化--均值标准差
-
-
scala> val scaler = new StandardScaler().setInputCol("features").setOutputCol("scaledFeatures").setWithStd(true).setWithMean(true)
-
scaler: org.apache.spark.ml.feature.StandardScaler = stdScal_2e35fbc29084
-
-
scala>
-
-
scala> // Compute summary statistics by fitting the StandardScaler.
-
-
scala> val scalerModel = scaler.fit(vecDF)
-
scalerModel: org.apache.spark.ml.feature.StandardScalerModel = stdScal_2e35fbc29084
-
-
scala>
-
-
scala> // Normalize each feature to have unit standard deviation.
-
-
scala> val scaledData: DataFrame = scalerModel.transform(vecDF)
-
scaledData: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 13 more fields]
-
-
scala> // scaledData:DataFrame = [features: vector, scaledFeatures: vector]
-
-
scala>
-
-
scala> scaledData.select("features", "scaledFeatures").show
-
16/11/05 15:56:20 WARN Executor: 1 block locks were not released by TID = 13:
-
[rdd_17_0]
-
+--------------------+--------------------+
-
| features| scaledFeatures|
-
+--------------------+--------------------+
-
|[0.0,37.0,10.0,3....|[-0.4413500298573...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|
-
|[0.0,32.0,15.0,1....|[-0.4413500298573...|
-
|[0.0,57.0,15.0,5....|[-0.4413500298573...|
-
|[0.0,22.0,0.75,2....|[-0.4413500298573...|
-
|[0.0,32.0,1.5,2.0...|[-0.4413500298573...|
-
|[0.0,22.0,0.75,2....|[-0.4413500298573...|
-
|[0.0,57.0,15.0,2....|[-0.4413500298573...|
-
|[0.0,32.0,15.0,4....|[-0.4413500298573...|
-
|[0.0,22.0,1.5,4.0...|[-0.4413500298573...|
-
|[0.0,37.0,15.0,2....|[-0.4413500298573...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|
-
|[0.0,47.0,15.0,5....|[-0.4413500298573...|
-
|[0.0,22.0,1.5,2.0...|[-0.4413500298573...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|
-
|[0.0,37.0,15.0,1....|[-0.4413500298573...|
-
|[0.0,37.0,15.0,2....|[-0.4413500298573...|
-
|[0.0,22.0,0.75,3....|[-0.4413500298573...|
-
|[0.0,22.0,1.5,2.0...|[-0.4413500298573...|
-
|[0.0,27.0,10.0,2....|[-0.4413500298573...|
-
+--------------------+--------------------+
-
only showing top 20 rows
-
-
-
scala>
-
-
scala> //##########################
-
-
scala> // 主成分
-
-
scala> val pca = new PCA().setInputCol("scaledFeatures").setOutputCol("pcaFeatures").setK(3).fit(scaledData)
-
16/11/05 15:56:21 WARN Executor: 1 block locks were not released by TID = 14:
-
[rdd_17_0]
-
16/11/05 15:56:22 WARN Executor: 1 block locks were not released by TID = 15:
-
[rdd_17_0]
-
16/11/05 15:56:24 WARN BLAS: Failed to load implementation from: com.github.fommil.netlib.NativeSystemBLAS
-
16/11/05 15:56:24 WARN BLAS: Failed to load implementation from: com.github.fommil.netlib.NativeRefBLAS
-
16/11/05 15:56:25 WARN LAPACK: Failed to load implementation from: com.github.fommil.netlib.NativeSystemLAPACK
-
16/11/05 15:56:25 WARN LAPACK: Failed to load implementation from: com.github.fommil.netlib.NativeRefLAPACK
-
pca: org.apache.spark.ml.feature.PCAModel = pca_8569d580d6e4
-
-
scala> pca.explainedVariance.values //解释变量方差
-
res11: Array[Double] = Array(0.28779526464781313, 0.23798543640278289, 0.11742828783633019)
-
-
scala> pca.pc //载荷(观测变量与主成分的相关系数)
-
res12: org.apache.spark.ml.linalg.DenseMatrix =
-
-0.12034310848156521 0.05153952289637974 0.6678769450480689
-
-0.42860623714516627 0.05417889891307473 -0.05592377098140197
-
-0.44404074412877986 0.1926596811059294 -0.017025575192258197
-
-0.12233707317255231 0.08053139375662526 -0.5093149296300096
-
-0.14664751606128462 -0.3872166556211308 -0.03406819489501708
-
-0.145543746024348 -0.43054860653839705 0.07841454709046872
-
0.17703994181974803 -0.12792784984216296 -0.5173229755329072
-
0.2459668445061567 0.4915809641798787 0.010477548320795945
-
-0.2459668445061567 -0.4915809641798787 -0.010477548320795945
-
-0.44420980045271047 0.240652448514566 -0.089356723885704
-
0.4442098004527103 -0.24065244851456588 0.08935672388570405
-
-
scala> pca.extractParamMap()
-
res13: org.apache.spark.ml.param.ParamMap =
-
{
-
pca_8569d580d6e4-inputCol: scaledFeatures,
-
pca_8569d580d6e4-k: 3,
-
pca_8569d580d6e4-outputCol: pcaFeatures
-
}
-
-
scala> pca.params
-
res14: Array[org.apache.spark.ml.param.Param[_]] = Array(pca_8569d580d6e4__inputCol, pca_8569d580d6e4__k, pca_8569d580d6e4__outputCol)
-
-
scala>
-
-
scala> val pcaDF: DataFrame = pca.transform(scaledData)
-
pcaDF: org.apache.spark.sql.DataFrame = [affairs: double, age: double ... 14 more fields]
-
-
scala> // pcaDF:DataFrame = [features: vector, scaledFeatures: vector,pcaFeatures: vector]
-
-
scala> pcaDF.cache()
-
res15: pcaDF.type = [affairs: double, age: double ... 14 more fields]
-
-
scala>
-
-
scala> pcaDF.printSchema()
-
root
-
|-- affairs: double (nullable = true)
-
|-- age: double (nullable = true)
-
|-- yearsmarried: double (nullable = true)
-
|-- religiousness: double (nullable = true)
-
|-- education: double (nullable = true)
-
|-- occupation: double (nullable = true)
-
|-- rating: double (nullable = true)
-
|-- gender: string (nullable = true)
-
|-- children: string (nullable = true)
-
|-- genderIndex: double (nullable = true)
-
|-- genderVec: vector (nullable = true)
-
|-- childrenIndex: double (nullable = true)
-
|-- childrenVec: vector (nullable = true)
-
|-- features: vector (nullable = true)
-
|-- scaledFeatures: vector (nullable = true)
-
|-- pcaFeatures: vector (nullable = true)
-
-
-
scala> pcaDF.select("features", "scaledFeatures", "pcaFeatures").show
-
16/11/05 15:56:36 WARN Executor: 1 block locks were not released by TID = 18:
-
[rdd_64_0]
-
+--------------------+--------------------+--------------------+
-
| features | scaledFeatures | pcaFeatures |
-
+--------------------+--------------------+--------------------+
-
|[0.0,37.0,10.0,3....|[-0.4413500298573...|[0.27828160409293...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|[2.42147114101165...|
-
|[0.0,32.0,15.0,1....|[-0.4413500298573...|[0.18301418047489...|
-
|[0.0,57.0,15.0,5....|[-0.4413500298573...|[-2.9795960667914...|
-
|[0.0,22.0,0.75,2....|[-0.4413500298573...|[1.79299133565688...|
-
|[0.0,32.0,1.5,2.0...|[-0.4413500298573...|[2.65694237441759...|
-
|[0.0,22.0,0.75,2....|[-0.4413500298573...|[3.48234503794570...|
-
|[0.0,57.0,15.0,2....|[-0.4413500298573...|[-2.4215838062079...|
-
|[0.0,32.0,15.0,4....|[-0.4413500298573...|[-0.6964555195741...|
-
|[0.0,22.0,1.5,4.0...|[-0.4413500298573...|[2.18771069800414...|
-
|[0.0,37.0,15.0,2....|[-0.4413500298573...|[-2.4259075891377...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|[-0.7743038356008...|
-
|[0.0,47.0,15.0,5....|[-0.4413500298573...|[-2.6176149267534...|
-
|[0.0,22.0,1.5,2.0...|[-0.4413500298573...|[2.95788535193022...|
-
|[0.0,27.0,4.0,4.0...|[-0.4413500298573...|[2.50146472861263...|
-
|[0.0,37.0,15.0,1....|[-0.4413500298573...|[-0.5123817022008...|
-
|[0.0,37.0,15.0,2....|[-0.4413500298573...|[-0.9191740114044...|
-
|[0.0,22.0,0.75,3....|[-0.4413500298573...|[2.97391491782863...|
-
|[0.0,22.0,1.5,2.0...|[-0.4413500298573...|[3.17940505267806...|
-
|[0.0,27.0,10.0,2....|[-0.4413500298573...|[0.74585406839527...|
-
+--------------------+--------------------+--------------------+
-
only showing top 20 rows
-
-
-
scala>
-
-
scala> //#####################################
-
-
scala>
-
-
scala> // 注意最大迭代次數和轮廓系数
-
-
scala> val KSSE = (2 to 10 by 1).par.toList.map { k =>
-
| // 聚类
-
| // Trains a k-means model.
-
| val kmeans = new KMeans().setK(k).setSeed(1L).setFeaturesCol("pcaFeatures")
-
| val model = kmeans.fit(pcaDF)
-
|
-
| // Evaluate clustering by computing Within Set Sum of Squared Errors.
-
| val WSSSE = model.computeCost(pcaDF)
-
|
-
| (k, WSSSE)
- | }
-
KSSE: List[(Int, Double)] = List((2,2876.20580405469), (3,1680.6647048004902), (4,1395.7184052948346), (5,1239.9362814229812), (6,999.2793106095127), (7,849.0071338527408), (8,737.8560221633246), (9,771.8211752483357), (10,655.7836351785677))
-
-
scala>
-
-
scala> KSSE.foreach(println)
-
(2,2876.20580405469)
-
(3,1680.6647048004902)
-
(4,1395.7184052948346)
-
(5,1239.9362814229812)
-
(6,999.2793106095127)
-
(7,849.0071338527408)
-
(8,737.8560221633246)
-
(9,771.8211752483357)
- (10,655.7836351785677)
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29070860/viewspace-2127855/ ,如需转载,请注明出处,否则将追究法律责任。
下一篇:
Scala zip 拉链操作

请登录后发表评论
登录
全部评论
