一、达梦 AWR
AWR--Automatic Workload Repository,系统为其所有重要统计信息和负载信息执行一次快照,并将这些快照存储在AWR中。 数据库快照是一个只读的静态的数据库。DM快照功能是基于数据库实现的,每个快照是基于数据库的只读镜像。通过检索快照,可以获取源数据库在快照创建时间点的相关数据信息。
AWR是 达梦 数据库中一个非常重要的诊断工具,通过度量而展现问题, AWR的引入,为我们分析数据库提供了非常好的便利条件 , 每一个DBA都应当深入理解这其中的知识 。接下来我们简要介绍下达梦AWR工具的创建和使用过程, 希望通过这篇文章,能方便大家更好地利用AWR进行分析工作。
二、如何创建 AWR
达梦AWR功能默认是关闭的,如果需要开启,则 要 调用DBMS_WORKLOAD_REPOSITORY 包。DM 数据库在创建该包时,默认创建一个名为 SYSAUX 的表空间,对应的数据文件为 SYSAWR.DBF ,该表空间用于存储该包生成快照的数据。如果该包被删除,那么 SYSAUX 表空间也对应地被删除。
1 、 在使用 DBMS_WORKLOAD_REPOSITORY 包之前,需要提前 初始化awr 快照包
Sp_init_awr_sys(1);
2. 设置一下AWR 每个快照的时间间隔
CALL DBMS_WORKLOAD_REPOSITORY.AWR_SET_INTERVAL(10);
-- 这里设置的是 10 分钟,可以根据需要来设置(必须设置一个时间,不然无法抓取快照)
设置成功后,可以使用 CREATE_SNAPSHOT 手动创建快照,也可以等待设置的间隔时间后系统自动创建快照,快照 id 从 1 开始递增 。
手动设置快照 :
DBMS_WORKLOAD_REPOSITORY.CREATE_SNAPSHOT();
3 、查询快照信息:
SELECT * FROM SYS.WRM$_SNAPSHOT;
4、 根据id信息生成AWR报告
call SYS.AWR_REPORT_HTML(1,2,'/home/dmdba/','AWR1.HTML');
5、 其他操作
通过 DMBS_WORKLOAD_REPOSITORY 包还可以对快照本身做增删改操作 ,这里不再详细介绍。
三、分析 AWR
通过 AWR 报告,DBA 可以容易地获知最近数据库的活动状态,数据库的各种性能指标的变化趋势曲线,最近数据库可能存在的异常,分析数据库可能存在的性能瓶颈从而对数据库进行优化。AWR 报告中指标比较高,接下来挑几个用的比较多的指标进行说明。
1、数据库
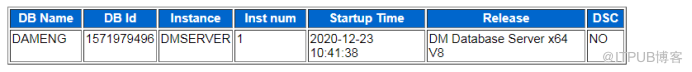
这部分可以看到 :
数据库的版本
数据库 DBID
数据库实例名称及实例号
数据库最近一次启动时间
数据库版本
数据库是否为rac
2 、主机配置信息

这部分可以看到 :
数据库主机名
数据库主机平台
服务器CPU及核数
服务器CPU个数
服务器内存大小
3 、 SnapShot 信息
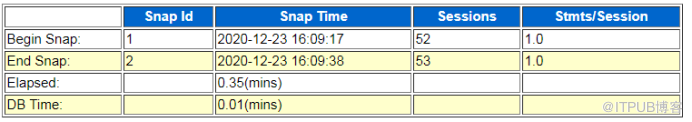
awr报告的起止时间以及当时的session数量等
awr报告持续时间
DB 时间
DB Time= session time spent in database.
DB Time= CPU Time + Non IDLE wait time.
可以看到DB Time 比 Elapsed 大,如果大很多并且有性能问题,需再进一步分析
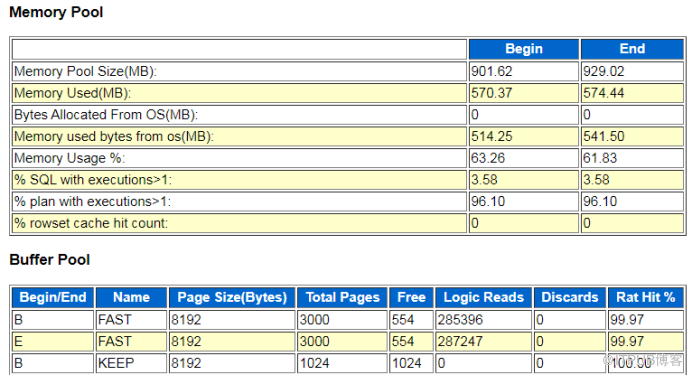
4 、内存使用
Memory Pool 和 Buffer Pool :
5 、 Load Profile
这里我们可以了解系统负载的情况
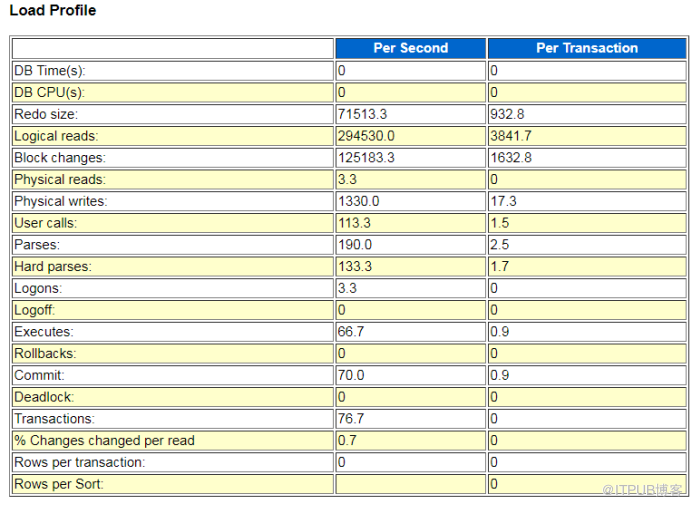
DB Time
表示用户操作花费的时间,包括CPU时间和等待 时间 。通常同时这个数值判读数据库的负载情况。
DB CPU
这是一个用于衡量CPU的使用率的重要指标。假设系统有N个CPU,那么如果CPU全忙的话,一秒钟内的DB CPU就是N秒。除了利用CPU进行计算外,数据库还会利用其它计算资源,如网络、硬盘、内存等等,这些对资源的利用同样可以利用时间进行度量。假设系统有M个session在运行,同一时刻有的session可能在利用CPU,有的session可能在访问硬盘,那么在一秒钟内,所有session的时间加起来就可以表征系统在这一秒内的繁忙程度。一般的,这个和的最大值应该为M
。
Redo size
每秒(每个事务)产生的日志大小(单位字节)
Logical reads
每秒(每个事务)产生的逻辑读(单位是block)。在很多系统里select执行次数要远远大于transaction次数。这种情况下,可以参考Logical reads/Executes。在良好的oltp环境下,这个应该不会超过50,一般只有10左右。如果这个值很大,说明有些语句需要优化。
Block Changes
每秒(每个事务)改变的数据块数。
Physical reads
每秒(每个事务)产生的物理读(单位是block)。一般物理读都会伴随逻辑读,除非直接读取这种方式,不经过cache。
Physical writes
每秒(每个事务)产生的物理写(单位是block)。
User calls
每秒(每个事务)用户调用次数。User calls/Executes基本上代表了每个语句的请求次数,Executes越接近User calls越好。
Parses
每秒(每个事务)产生的解析(或分析)的次数,包括软解析和硬解析,但是不包括快速软解析。软解析每秒超过300次意味着你的"应用程序"效率不高,没有使用soft soft parse 。
Hard parses
每秒(每个事务)产生的硬解析次数。每秒超过100次,就可能说明你绑定使用的不好。
Logons
每秒(每个事务)登录数据库次数。
Executes
每秒(每个事务)SQL语句执行次数。包括了用户执行的SQL语句与系统执行的SQL语句,表示一个系统SQL语句的繁忙程度。
Transactions
每秒的事务数。表示一个系统的事务繁忙程度。目前已知的最繁忙的系统为淘宝的在线交易系统,这个值达到了1000。
% Changes changed per Read
表示逻辑读用于只读而不是修改的块的比例。如果有很多PLSQL,那么就会比较高。
6 、 Instance Efficiency Percentages
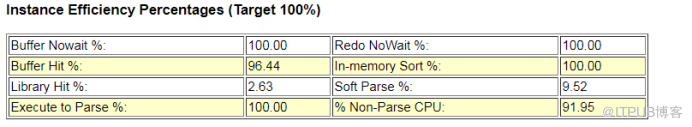
这个部分是内存效率的统计信息。对于OLTP 系统而言,这些值都应该尽可能地接近 100% 。对于 OLAP 系统而言,意义不太大。因为在 OLAP 系统中,大查询的速度才是对性能影响的最大因素。
Buffer Nowait %
非等待方式获取数据块的百分比。
这个值偏小,说明发生SQL 访问数据块时数据块正在被别的会话读入内存,需要等待这个操作完成。发生这样的事情通常就是某些数据块变成了热块。
Redo NoWait %
非等待方式获取redo数据百分比。
Buffer Hit %
数据缓冲命中率,表示了数据块在数据缓冲区中的命中率。
In-memory Sort %
数据块在内存中排序的百分比。总排序中包括内存排序和磁盘排序。当内存中排序空间不足时,使用临时表空间进行排序,这个是内存排序对总排序的百分比。
Library Hit %
共享池中SQL 解析的命中率。
Library Hit<95% ,要考虑加大共享池,绑定变量。
Soft Parse %
软解析占总解析数的百分比。可以近似当作sql 在共享区的命中率。
这个数值偏低,说明系统中有些SQL 没有重用,最优可能的原因就是没有使用绑定变量。
<95% :需要考虑到绑定
<80% :那么就可能 sql 基本没有被重用
Execute to Parse %
执行次数对分析次数的百分比。
如果该值偏小,说明解析( 硬解析和软解析 ) 的比例过大,快速软解析比例小。根据实际情况,可以适当调整参数。没绑定的话导致不能重用也是一个原因,当然 memory pool 太小也有可能 。
% Non-Parse CPU
CPU 非分析时间在整个 CPU 时间的百分比。
100*(parse time cpu / parse time elapsed)= Parse CPU to Parse Elapsd %
查询实际运行时间/( 查询实际运行时间 +sql 解析时间 ) ,太低表示解析消耗时间过多。
7 、 Top 5 Timed Foreground Events
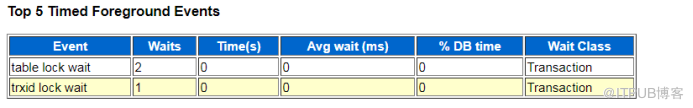
这部分指的是占用数据库时间靠前的一些事件, 主要是等待事件
Event 代表事件的名称
Waits 代表 该事件等待的次数, CPU Time 不适用
Time(s) 代表该事件等待的总时间,单位为秒
Avg Wait(ms) 代表平均等待时间 (Time(s)/Waits) ,单位为毫秒
% DB Time 代表该事件占整个 DB Time 的比例
Wait Class 代表等待事件的类型
8 、 Time Model Statistics
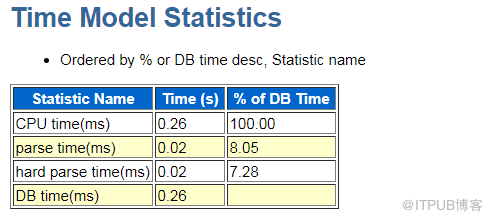
我们注意到所有 % of DB Time 总和大于 100% ,因为这是一个累计的比例,下面 DB CPU 相关的过程包含在 DB CPU 中
我们需要注意的是一些异常的高占用情况,如hard parse time ( 硬解析时间 ) 占用时间过长等
9 、 SQL Statistics
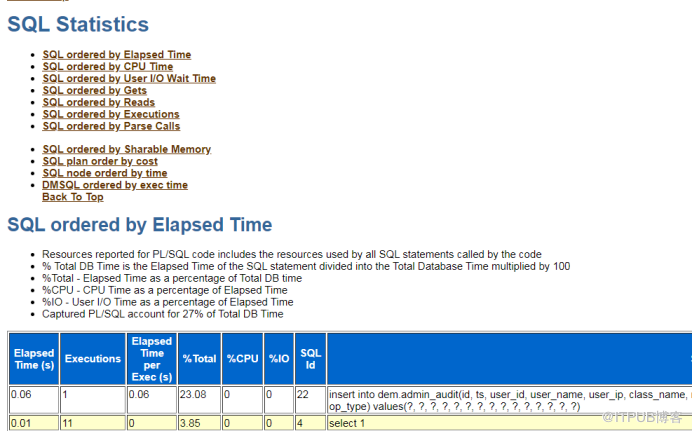
这一部分 是最重要的一块 之一 ,他能帮助我们定位占用相关资源的TOP SQL语句 。
Elapsed Time(S)
SQL 语句执行用总时长,此排序就是按照这个字段进行的。注意该时间不是单个 SQL 跑的时间,而是监控范围内 SQL 执行次数的总和时间。单位时间为秒。 Elapsed Time = CPU Time + Wait Time
CPU Time(s)
为SQL语句执行时CPU占用时间总时长,此时间会小于等于Elapsed Time时间。单位时间为秒。
Executions
SQL 语句在监控范围内的执行次数总计。如果 Executions=0 ,则说明语句没有正常完成,被中间停止,需要关注。
Elapsed Time per Exec (s)
执行一次SQL的平均时间。单位时间为秒。
% Total
为SQL的Elapsed Time时间占数据库总时间的百分比。
% CPU
为SQL的 CPU 时间占总时间的百分比。
SQL ID
SQL语句的ID编号。
SQL Text
SQL 文本 。
Buffer Gets
SQL执行获得的内存数据块数量。
Gets per Exec
每次执行获得的内存数据块数量。
Physical Reads
SQL物理读的次数
Reads per Exec
SQL每次执行产生的物理读。
Rows Processed
SQL处理的记录数。
Rows per Exec
SQL每次执行处理的记录数。
如果看到SQL语句执行时间很长,而CPU时间很少,则说明SQL在I/O操作时(包括逻辑I/O和物理I/O)消耗较多。可以结合前面I/O方面的报告以及相关等待事件,进一步分析是否是I/O存在问题。当然SQL的等待时间主要发生在I/O操作方面,不能说明系统就存在I/O瓶颈,只能说SQL有大量的I/O操作。
如果SQL语句执行次数很多,需要关注一些对应表的记录变化。如果变化不大,需要从前面考虑是否大多数操作都进行了Rollback,导致大量的无用功。
SQL运行周期对报告的影响
需要注意的是execution如果为0不代表未执行,代表在awr报告的持续范围内该语句未执行完成 。
对SQL语句来讲,只有当它执行完毕之后,它的相关信息才会被达梦所记录(比如:CPU时间、SQL执行时长等)。当时当某个SQL终止于做AWR报告选取的2个快照间隔时间之后,那么它的信息就不能被这个AWR报告反映出来。尽管它在采样周期里面的运行,也消耗了很多资源。
也就是说某个区间的性能报告并不能精确地反映出在这个采样周期中资源的消耗情况。因为有些在这个区间运行的SQL可能结束于这个时间周期之后,也可能有一些SQL在这个周期开始之前就已经运行了很久,恰好结束于这个采样周期。这些因素都导致了采样周期里面的数据并不绝对是这个时间段发生的所有数据库操作的资源使用的数据。
来自 “ ITPUB博客 ” ,链接:https://blog.itpub.net/29000877/viewspace-2747993/ ,如需转载,请注明出处,否则将追究法律责任。

